这两天刷本地大模型圈,最割裂的画面来自同一颗芯片:AMD 锐龙 AI Max+ 395。
一边,有人拿它配 128G 统一内存的一体机,实测 Qwen3.8-Flash-Next 这个 125B 参数的 MoE 模型,代码生成跑到 60 token/s,256K 上下文基本不衰减,结论是"本地大模型这条路,AMD 统一内存机型算是真能打了"。 另一边,也有人甩下一句"鸡肋,qwen3.8 flash 跑长上下文能降到个位数 tps"就退坑了。小红书小红书
比性能分歧更扎心的是价格。这颗 U 的 128G 机型,去年发布时评论区还在吵"集成显卡能战 4070,但卖 1 万 5 是不是太贵"。 今年,它的价格和口碑已经完全倒了个个儿。这篇把价格、速度、生态、时机四本账摊开对一遍,先给结论:395 现在的状态是"能打了,但当前价格对新入坑的人不友好"——天天要用的看怎么低成本搞到,跟风的建议等 495 国行定价落地再动。小红书
一、价格账:从"1万5太贵"到"2万2没货"
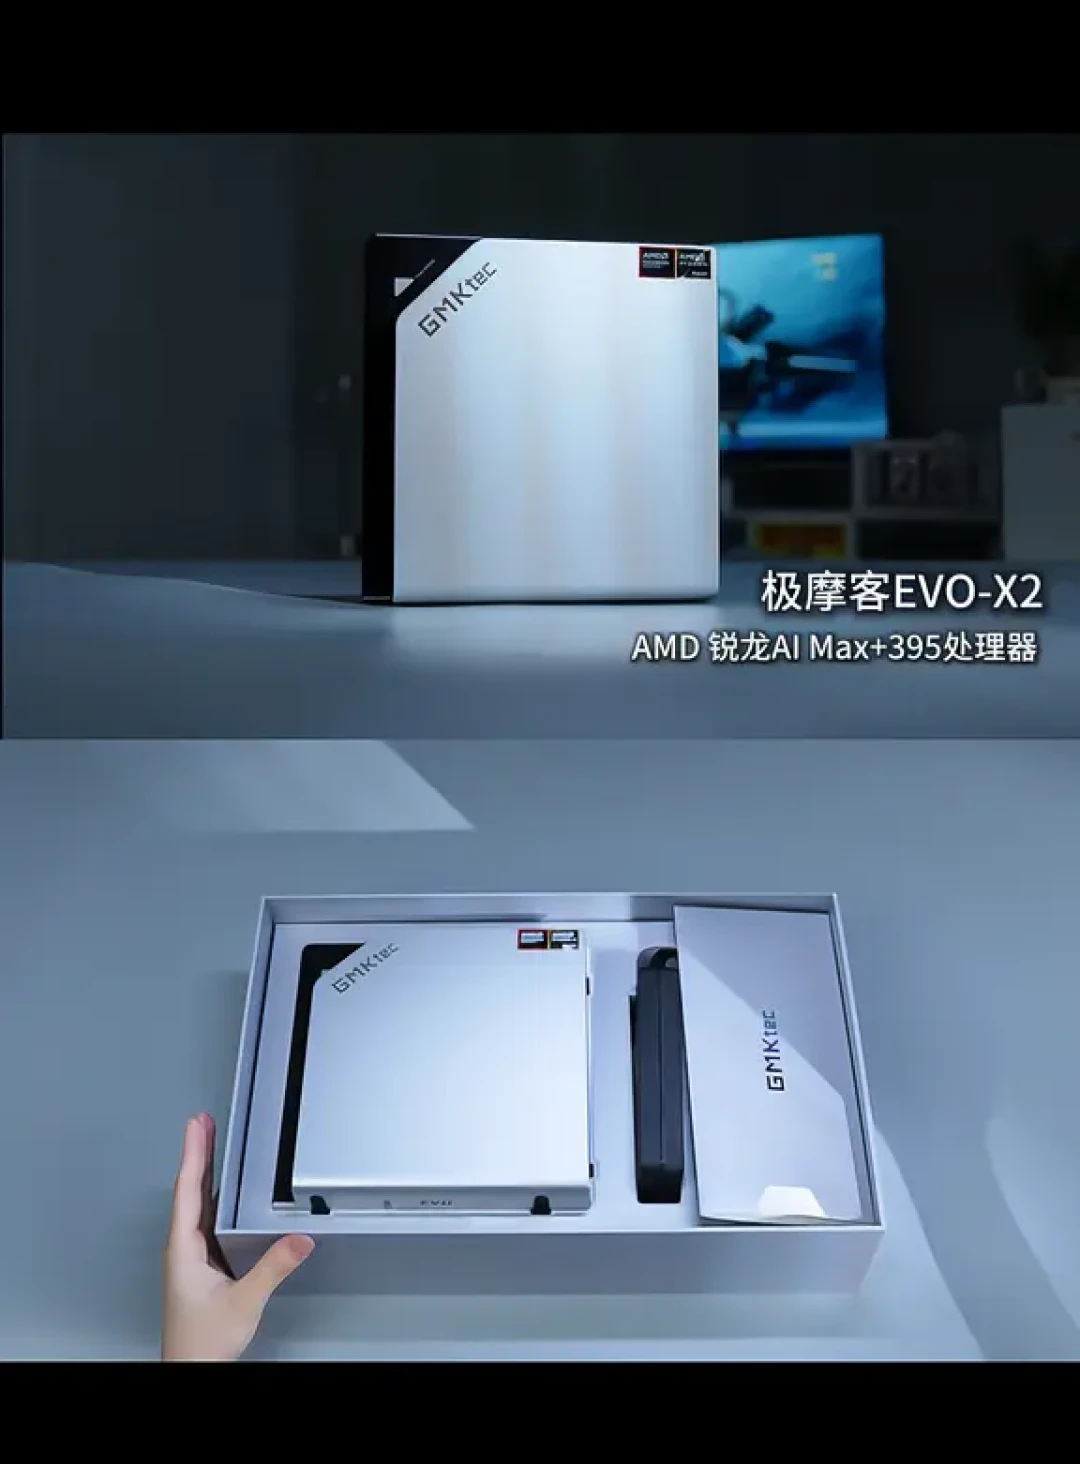
先看这台机器的价格轨迹。2025 年 4 月,极摩客 EVO-X2 开启预售,官方后来的开箱帖标题就叫"了解一下 14999 的 AI PC",128G 内存 + 2T 固态 + Radeon 8060S 核显。小红书
到了今年 9 月,同一条讨论帖的评论区已经换了一个世界:有人"当年 1.3W 买的,现在 2.3W",有人"14499 买的,用了一年,涨到 21999 了,成了理财产品了",还有人"根本买不到,咸鱼蹲了半年都没蹲到"。小红书
涨价的原因没法完全拆清,但时间线上它和三件事重合:LPDDR5X 内存涨价周期、AMD 四季度涨价传闻、本地大模型需求升温。板载统一内存的机型对内存价格没有任何议价缓冲,这是它和普通 DIY 装机最大的不同——你自己配 64G 内存嫌贵可以等,它不能。
更重要的是,涨价之后这笔账得重算。评论区已经有人替你算了:理论跑分也就 4060 水平、价格两万了,买张 4090 魔改卡配整套电脑三万多,性能是它的三四倍。 这个对比对纯游戏党成立,对跑模型的人不成立——4090 只有 24G 显存,塞不下 125B 权重。但它划出了一个事实:2.2 万的 395,性价比已经薄到必须靠"128G 统一内存"这一个理由撑着。你要是没有"必须本地跑大模型"的硬需求,这个价格就是纯溢价。小红书
而 9 月出现的变数是:IFA 2026 上极摩客展出了 EVO-X5 Pro,换装锐龙 AI Max+ PRO 495、内存上到 192GB。 9 月 15 日 AMD 又在国内开了 PRO 495 发布会,联想 ThinkCentre X Ultra、铭凡 MS-S1 MAX-P495、极摩客 EVO-X5 Pro、七彩虹灵创 Mini Pro、阿迈奇 F9A 一串机型都在通稿名单里。 新一批内存更大更新的机器马上上市,这正是当前 395 现货价格最大的下行变量。IT之家微博
二、速度账:60 token/s 是真的,但每个数字前面都挂着条件
先说那句最容易被截图传播的"125B 跑 60 token/s"是怎么回事。实测帖的配置是 128G 统一内存一体机加 Linux:Qwen3.8-Flash-Next 虽然总参数 125B,但它是 MoE 架构,每生成一个 token 只激活 6B 权重,82G 权重躺在共享内存里、每次只读一小截,吃的是 273G/s 的内存带宽——刚好是这种架构最舒服的吃法。小红书
同机实测的数字分层很清楚:代码生成 60.7 token/s,JSON 结构化 36 到 53,散文 23,256K 上下文性能基本不衰减,整机峰值功耗 70W。小红书
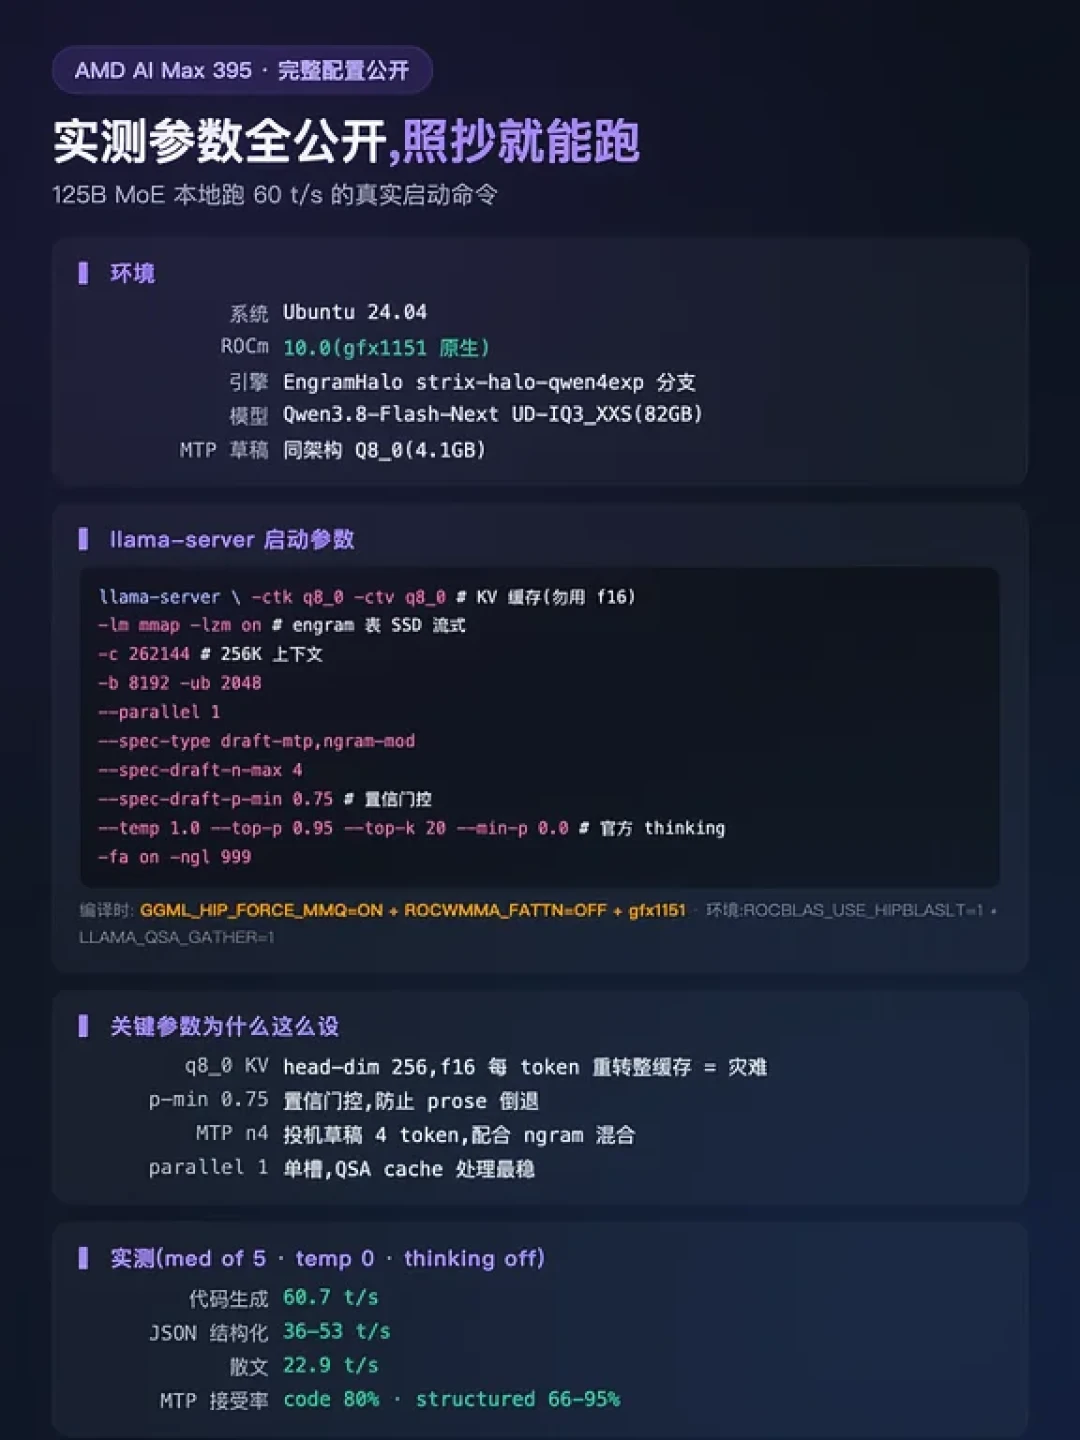
但这个数字的前置条件,比"买台机器"多得多。
第一条是必须 Linux。评论区同款配置在 Windows 上"速度可能要砍半",这不是玄学,是平台自身的缺陷。小红书
第二条是引擎要挑对。社区专门给 Strix Halo 维护了分支,带 GPU 端 top-k(不然上下文一深就丢回 CPU 算)、原生 MTP 投机头、ngram 草稿三个关键补丁,配合 ROCm 10.0 的 gfx1151 原生支持才能不掉链子。小红书
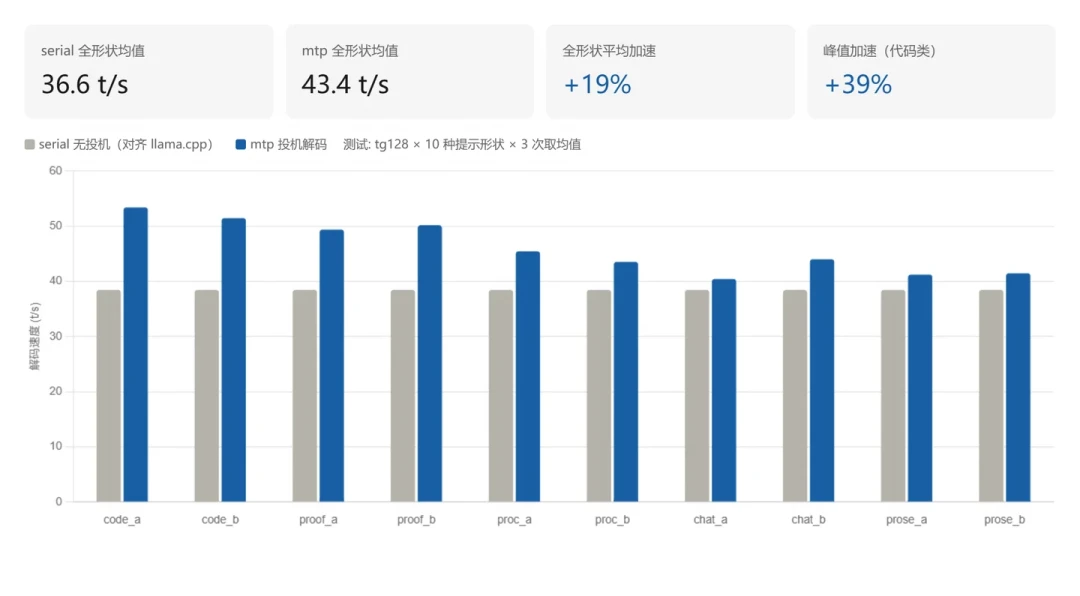
第三条是参数不能乱调。实测者自己交过学费:KV 缓存上 f16、投机草稿拉长,速度从 28 掉到 17,越"优化"越慢;老老实实改回 q8_0 + MTP n4 + 门控 0.75,速度直接翻三倍。小红书
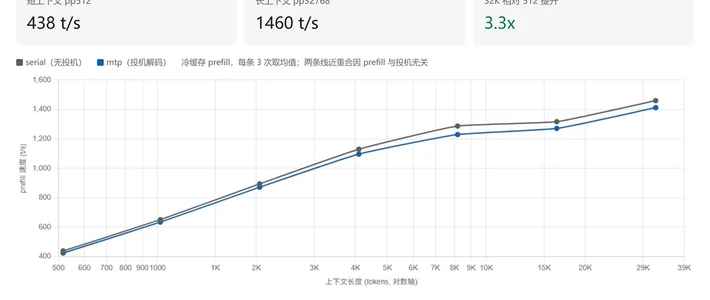
第四条最容易被忽略:prefill 才是真正的瓶颈。评论区追问之下,prefill 只有 200-230 t/s,“最大的问题是 prefill 太慢”,长上下文冷启动要多等,不着急的活才能这么跑。小红书
更完整的速度曲线来自另一个玩家:qwen 27B 这类稠密模型,从最开始 4-7 tps,折腾 MTP 到 15-17 tps,再到社区定制引擎 halogen-flash-server,拉到 26-28 tps,“终于算是好用的速度了”。 这个定制引擎 9 月又出了新版本,宣称 prefill 速度 tps 上千、decode 40-50 tps。小红书小红书
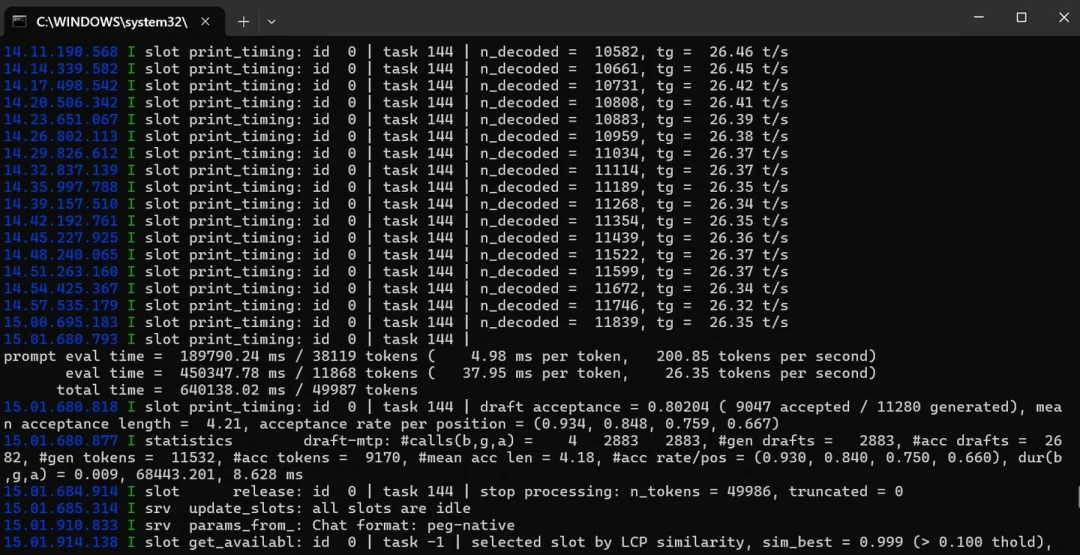
反方证据也摆在这:同样这颗 U,qwen3.8 flash 用 iq4xs 量化跑长上下文,速度能掉到个位数;“这代核显的推理算力太低了,只是到了能跑模型的程度”;也有人直接拿它对标 M4 Pro 和 Spark DGX,认为性价比毫无优势。 这些说法和 60 tps 并不矛盾——差距全在模型、量化、上下文长度、引擎和系统这五个变量上。所以看任何 395 的跑分帖,先看这五项,再看数字,不然就是拿别人的极限对照自己的日常。小红书
三、生态账:这颗 U 出厂是"半成品",补丁都在社区手里
9 月这波翻红,一半功劳在生态补课。ROCm 10.0 对 gfx1151 原生支持,不用再搞版本伪装;飞牛 OS 已经适配 8060S 核显加速、内置 ROCm 7.1 和 RNNX、PyTorch 支持,想拿它当 AI NAS 的有现成路线。 主流 agent 工具实测都能对接,有玩家拿 Claude Code 对接本地 qwen3.6-35B-A3B 干活,“效果比 Gemini cli 要强很多”。小红书小红书
模型选择上,一周实测 20 万上下文的老玩家给出的可用清单很短:真正干活成功且好用的只有 qwen3.8-next-flash q4、qwen3.6-35B-A3B q4 和 qwen3.8 27B(外接显卡跑的)。小红书
这份清单外的模型要谨慎:gemma4 处理中文文档差点意思;ornith1.5 快是快,但在主流 agent 里几乎完成不了任务,“无效 token 生成很多,生产不建议用”。小红书
坏消息也得说全。最强的定制引擎只能 Linux 部署、直接拉 Docker,目前没有开源,视觉支持都是 9 月 10 日才补上的。 Windows 是明确的二等公民,速度砍半之外还有别的坑。别指望外接独显组"混合推理",实测 iGPU 加 USB4 外接 7900 XTX 没法并行跑模型。小红书小红书
想游戏 AI 两吃的还要注意幻 X 这类二合一机型:有玩家被鸣潮反复死机折磨了半年,开睿频就卡死卡屏,最后发现元凶是 AMD 官网的芯片组驱动,用 DDU 删干净、改装 ROG 官网驱动才根治。小红书
一句话:这颗 U 的体验下限很低、上限很高,决定你拿到手是哪个档位的,是你愿不愿意折腾 Linux 和命令行,而不是机器本身。
四、人群账:谁该冲、谁该等、谁该绕
对着这四本账,人群其实很好分。
可以冲的:天天要跑本地模型、有隐私或断网硬约束、工作流已经绑在 agent 上、且 Linux 折腾能力在线的人。对你们来说 128G 统一内存目前仍是同价位独一份的入场券,评论区那句"价格在那里呢,你不能既要也要还要"就是这类人的真实状态。 买法上优先蹲二手和官方促销——闲鱼长期无货说明它现在是卖方市场,蹲到的注意核对保修和成色,这个价位迷你主机的售后口碑本身就有争议。小红书
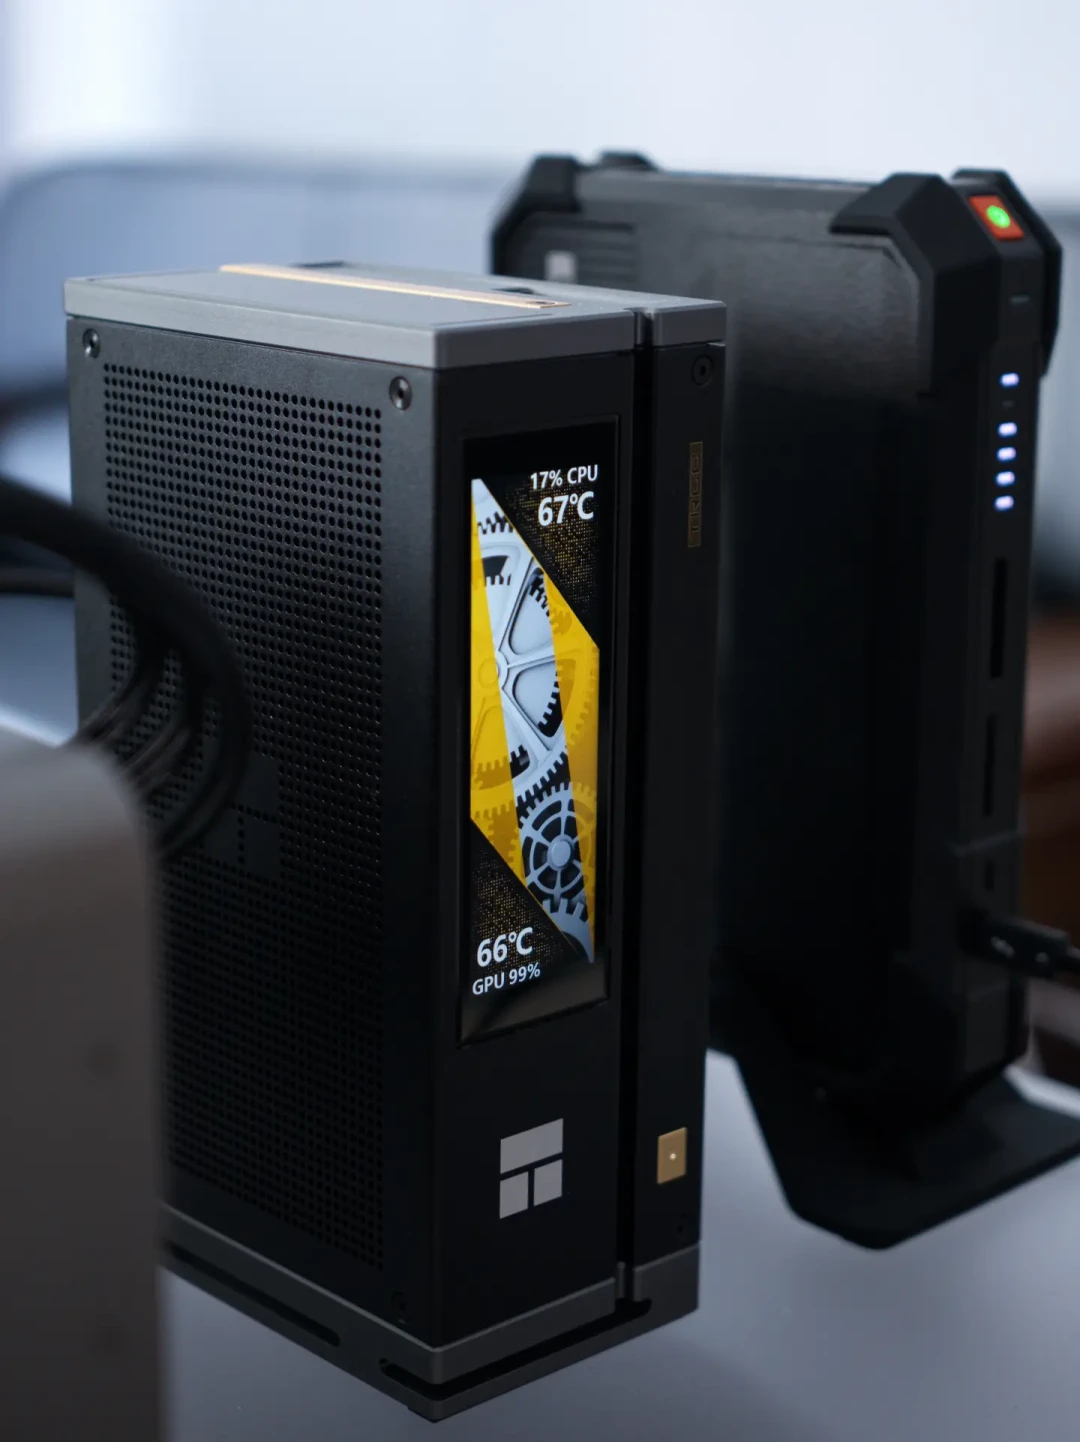
应该等的:预算两万上下、又没有"必须现在用"的理由的人。等的不是降价,是两个确定性:PRO 495 机型(192G 内存)的国行定价,以及 495 上市后 395 现货的价格反应。9 月 15 日发布会名单里联想、铭凡、极摩客、七彩虹都在,量不会小,定价很快会见分晓。
建议绕的:主要买来打游戏的(4060 级核显加驱动坑,两万块干这个纯属受罪)、图省事开箱即用的(Windows 体验残缺、模型清单要自己踩)、以及只想尝鲜跑跑小模型的——这个需求四五千的入门迷你主机加云 API 就能覆盖,犯不上为 128G 付溢价。
接下来盯这四个信号
PRO 495 国行定价:直接决定 395 现货价格还能撑多久,也是"192G 多花的钱值不值"的第一个数据点;
halogen-flash-server 是否开源:开源与否决定这套速度优化是社区资产还是个人作品,也决定 Windows 支持有没有戏;
四季度 AMD 涨价落地情况:整机涨幅的传导幅度,决定年后这批机器的底价;
Strix Halo 游戏驱动修复进展:幻 X 死机这类问题修没修干净,决定"AI 生产力加偶尔游戏"这个复合需求能不能成立。
这颗 U 现在真正的对手不是 4090,是"你愿不愿意为一台要伺候的 Linux 推理机付两万块"。想清楚这个问题,四本账自然就对完了。