这个月刷AI资讯的人应该都注意到了同一件事:所有人都在说"AI能操作你的电脑了"。
时间线密得反常。8月20日,Anthropic的Computer Use结束大半年的公测正式转正,顺带上线了能读页面结构的新工具browser use。知乎
9月3日前后,OpenAI发布GPT-6 Astra,头号卖点不是跑分,是直接接管鼠标键盘把多步骤任务从头做到尾。 腾讯的开源项目BrowserSkill则连着出现在9月16、17两天的行业日报里,标题直给:“AI Agent可接管已登录浏览器”。新浪财经知乎
9月17日,Devin Cloud上线macOS,AI在云端自己打开应用、点击界面、检查结果、录制测试视频;同一天,OpenRouter挂出shell工具,平台上任何模型都能在托管的Linux容器里运行代码。知乎
从演示到产品,"智能体动手"只用了30天。很多人的第一反应是想试,第二反应是三个顾虑:额度会不会被吃穿、登录态会不会出事、它做一半翻车了谁收拾。这三个顾虑都值得展开,但展开之前,得先拆掉四个流传最广的误解。
误解一:AI操作电脑,是逐帧盯着屏幕看
这是新手对"computer use"最大的想象偏差,也是成本焦虑的真正来源。9月17日知乎上有人把Astra操作电脑的过程放慢拆解,发现它绝大部分时间根本不在看像素:它的主通道,是操作系统给视障用户准备的无障碍接口——Windows上的UIA、macOS上的AXUIElement,这套基础设施有二十多年历史,比深度学习古老得多。知乎
拆解者在Windows 11上实测:遍历新版记事本的控件树,61个控件、耗时0.14秒,精简后的控件清单998个token;同一时刻截一张1936×1048的图,按OpenAI对高细节视觉输入的计费规则要2125个token——而且截图里的信息模型还得靠视觉推理"读"出来,控件树里"50个字符,共73个"是一个现成的字符串,只有28个token。知乎
真正的乘数效应在循环次数上。传统computer tool一轮只返回一批原子动作,宿主执行完回传新截图再进下一轮;官方给Astra的建议是优先用代码执行模式——模型直接写一段脚本,内部可以组合几十上百个动作、带循环和条件等待,跑完只回传结果。一个20步的任务,前者光传截图就要约42500个token的观测,后者两轮树观测加起来不到2000个token。 同一个任务,成本差20倍。差的不是模型智力,是harness怎么搭。知乎
工程侧还有一组对照数字:做语义层提取的AIBrowser给出的实测口径是,截图加OCR约400ms一步,语义树约50ms一次,而且OCR根本不知道那个按钮是"登录"还是"注册"。 所以决定接不接一个computer-use方案,第一个要问的是观测通道。如果它靠截图猜坐标,后面所有成本和可靠性讨论都从最贵、最不稳的那档算起。知乎
误解二:贵就贵在token上
"太烧Token"是9月17日的知乎热问,但高赞回答认为靶子就立错了:Astra的token效率其实很高,干活干净利落,问题是单价——比GPT-5.6 Sol贵2.5倍。知乎
该回答给出的自测口径:pro x20订阅、中等思考强度,goal模式长程工作1小时大约烧掉4%周限额,一周只有25小时纯Astra时间;换Sol大概是62小时。知乎
但同样是他的结论,方向反直觉:真正贵的不是token,是返工——"如果测试成本高,测试流程长,那没啥好省的,多买几个x20的账号蹬Astra才是真正的节省。"官方案例也在换计价单位:Anthropic正式版披露的客户Asteroid跑保险理赔,最长流程从32分钟降到13分钟、每任务成本降约30%、完成率100%、提示词一行没改。 注意,这是厂商单案例,数字不可外推。但方向是清楚的:智能体任务开始按"干成一件"计价,而不是按"说了多少话"计价。知乎
误解三:OSWorld 72.6%,等于能干你七成的活
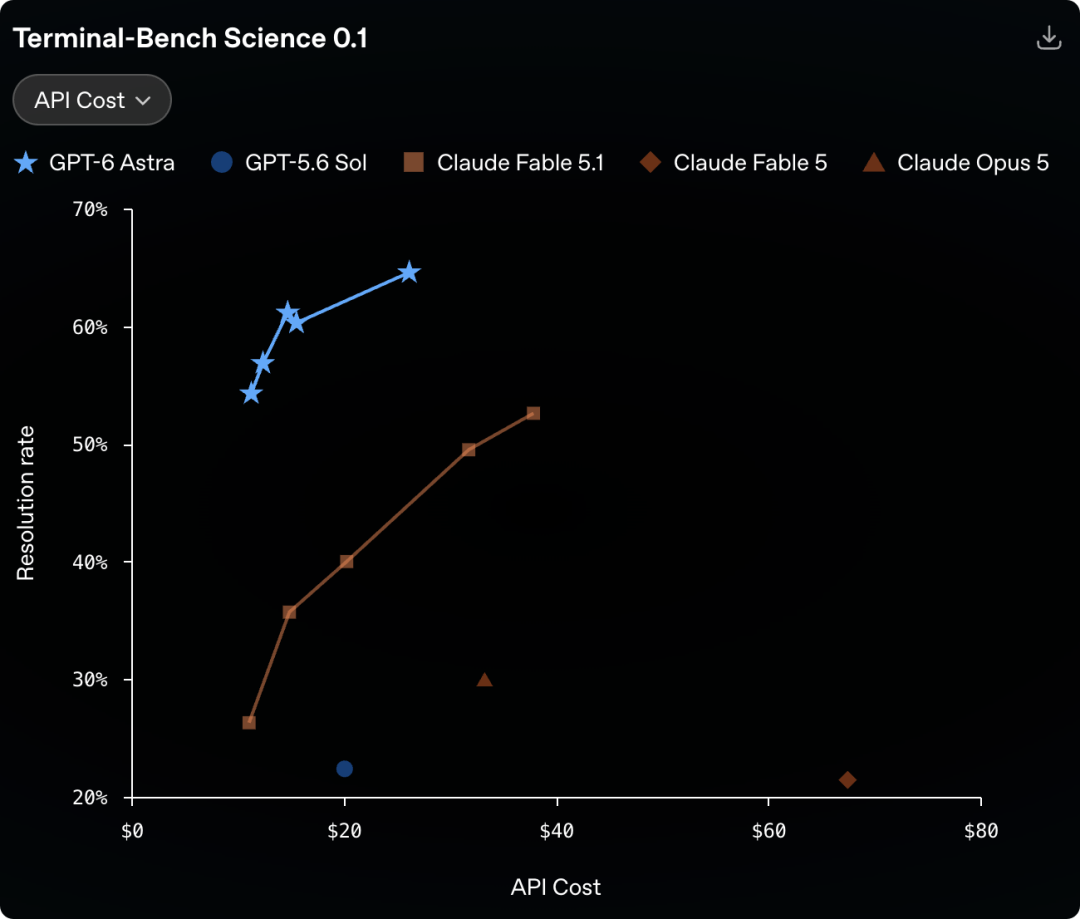
Astra在OSWorld 2.0上得分72.6%,上一代Sol是65.7%,平均任务耗时从约75分钟压到40分钟——但这是官方基准:同一批虚拟环境、用执行后的环境状态判成败、任务都是"标准题"。 另一边的真实体感,是另一条热问下的高赞短评:“感觉不到和5.6 Sol的差异。”知乎
更早的教训在检索侧:OpenAI的BrowseComp放了1266道"答案难找、验证容易"的浏览难题,GPT-4o接上浏览器也只有1.9%的准确率。 给模型一个浏览器,不等于它会干活;OSWorld能跑通,不等于它在你司的内网系统里跑通。基准刷到多少,只能说明基准内的水位;出了基准,就是另一个分布。知乎
误解四:安全问题就是"AI会不会乱点"
9月15日有条微博实操记录,折腾了一下午:用常规"接管浏览器"方案让AI替自己干活,结果把Google和X的登录全挤掉了。微博
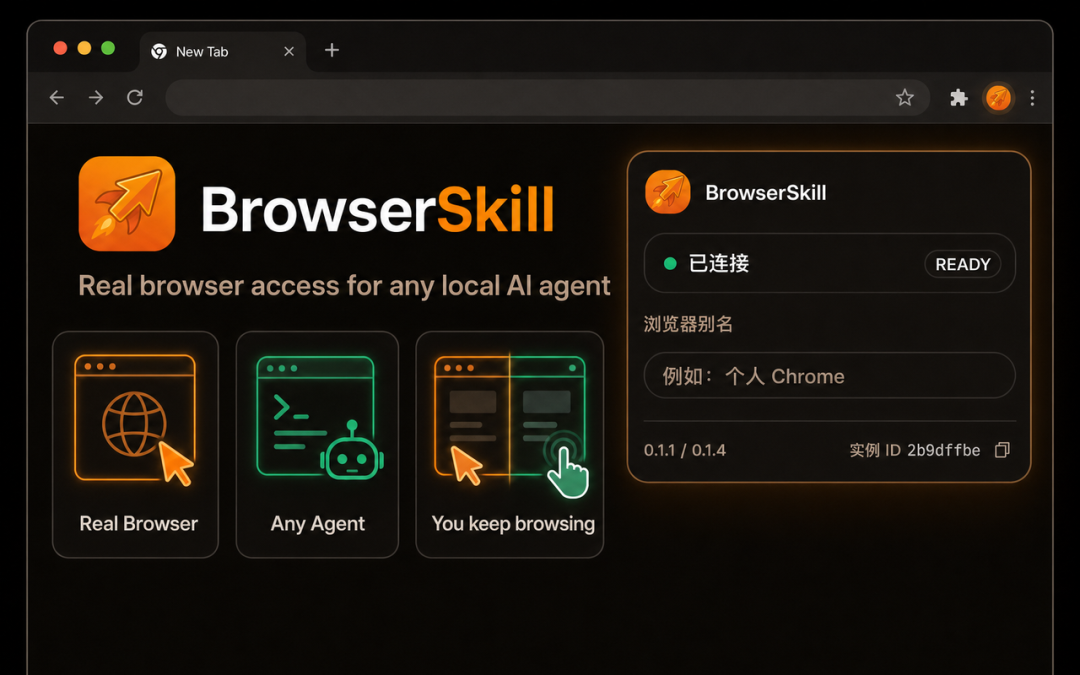
腾讯的BrowserSkill给出了另一种安全模型,三个细节值得抄作业。一是Agent有独立窗口,要用你已打开的页面时先"借走"这个Tab、用完再还,且明确不允许长期占用私人标签页。 二是确认开关放在浏览器扩展的设置里,CLI里的–unattended、–no-confirm覆盖不了它——因为"权限只写在System Prompt里的话,一次Prompt Injection就可能让模型忽略它"。三是验证码、扫码这些只有人能过的关卡,设计上就是把控制权交还给人。Anthropic那侧的说法更直白:模型只负责提议下一步动作,每一次点击和敲击都在你自己的环境里执行。知乎知乎
把四条误解拆完,落到能执行的部分。
接入前,先问四个问题
对着产品页或文档逐条过,问不出答案就先别接:
观测走什么通道?控件树、DOM、语义层,还是纯截图猜坐标?
一次模型调用能批量执行几步?跑一个20步任务要几轮"观测-推理"?
每个敏感动作有没有逐次确认?中途能不能接管、能不能看到操作日志?
你的订阅额度换算成"长程任务小时数"是多少?测试成本在你的工作流里贵不贵?
任务本身,按三档分:现在就可以交的,是规则清楚、测试便宜的网页杂活——批量填表、多站资料归集、内部后台查数,这一步便宜模型配好harness就能跑,不需要为旗舰款焦虑;要交但得盯着的,是跨系统但可回滚的中等流程,用带"借页确认加人工接管"设计的方案,前五次每步核验;暂时别交的,是资金操作、已登录社交账号的对外发送、生产库写入——目前所有方案都没给"翻车谁赔"留出条款,便利不抵风险。
最后是两个窗口期。OpenRouter的隐身模型Union Alpha把自己定位成面向研究、编程和智能体工作流的多模态模型,免费一周、支持256K上下文与工具调用,号称有GPT-6级别的编码能力。 想试智能体链路,可以白嫖一周再谈订阅。Grok 4.7已被曝进入员工内测,至今零泄露。判断"能不能让AI替你动手",别看发布会,看下一个新版本发布7天后,有没有人晒完整的第三方真实任务流复盘。数字会骗人,返工不会。知乎