这周AI付费用户圈子里,上演了一出罕见的"集体控诉变官方认账"。
9月15日,OpenAI Codex产品负责人Tibo正面回应了GPT-6 Astra上线以来的"降智"投诉:团队与受影响用户协作排查后,确认了三个不同缺陷,宣称已全部修复,系统在当地时间午夜执行重置——还顺手把用户的使用额度重置了一遍作为补偿。知乎
三个Bug分别是:为老版本模型开发的遗留Skills在Astra上继续异常触发,严重时会阻止Astra审计自己的输出,于是错误代码编辑、不完整任务执行全冒出来了;一个让模型提前终止回复、去回答对话里更早消息的上下文管理实验,官方口径是影响约4000到5000名用户,现已整个关停;还有一组配置错误的底层推理引擎,造成了"隐蔽的性能下降长尾",已从路由池移除。知乎
先别急着把截图挂到群里说"满血回来了"。官方这次认的是Bug,不是"我们故意给你降级"。 而且从社区反馈看,这波"降智"投诉里,相当一部分根本对不上这三个Bug——就在修复官宣当天,社区日报还在汇总用户反馈:账号限制首次获得官方正面回应、capacity报错从零星变成全天候,同日流传的对照实验显示同一账号直连没事、放进转发通道立刻变差。 把账算清楚,你才知道自己的钱花在了哪一层问题上。哔哩哔哩
一只鹈鹕,成了这轮风波的民间标尺
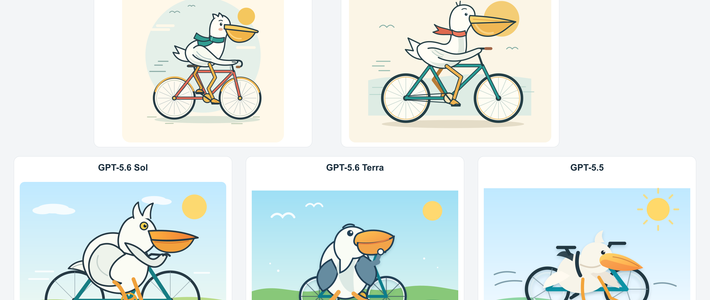
这次社区最有意思的反制,是"鹈鹕测试":让模型生成一张"骑自行车的鹈鹕"SVG矢量图——画出了鹈鹕、也画出了自行车都不算过关,身体在不在车架上、脚有没有踩到踏板、翅膀够不够得着车把,肉眼就能判断。这道由开发者Simon Willison带火的题目,这周被OpenAI用户拿来当每日体温计:开源项目CodexRadar的发起人Lambda干脆办起了"鹈鹕杯",近百份投稿轮着监测各家模型状态。 本土变体都卷出来了:孙悟空开飞机、秦始皇骑北极熊,天天画一遍当模型体检。哔哩哔哩知乎哔哩哔哩
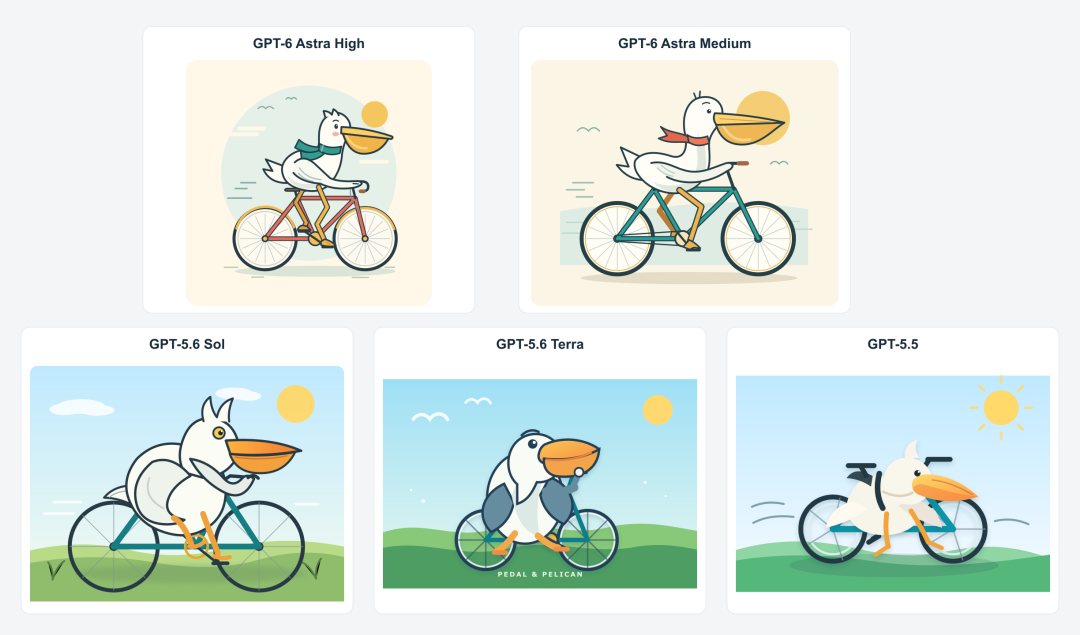
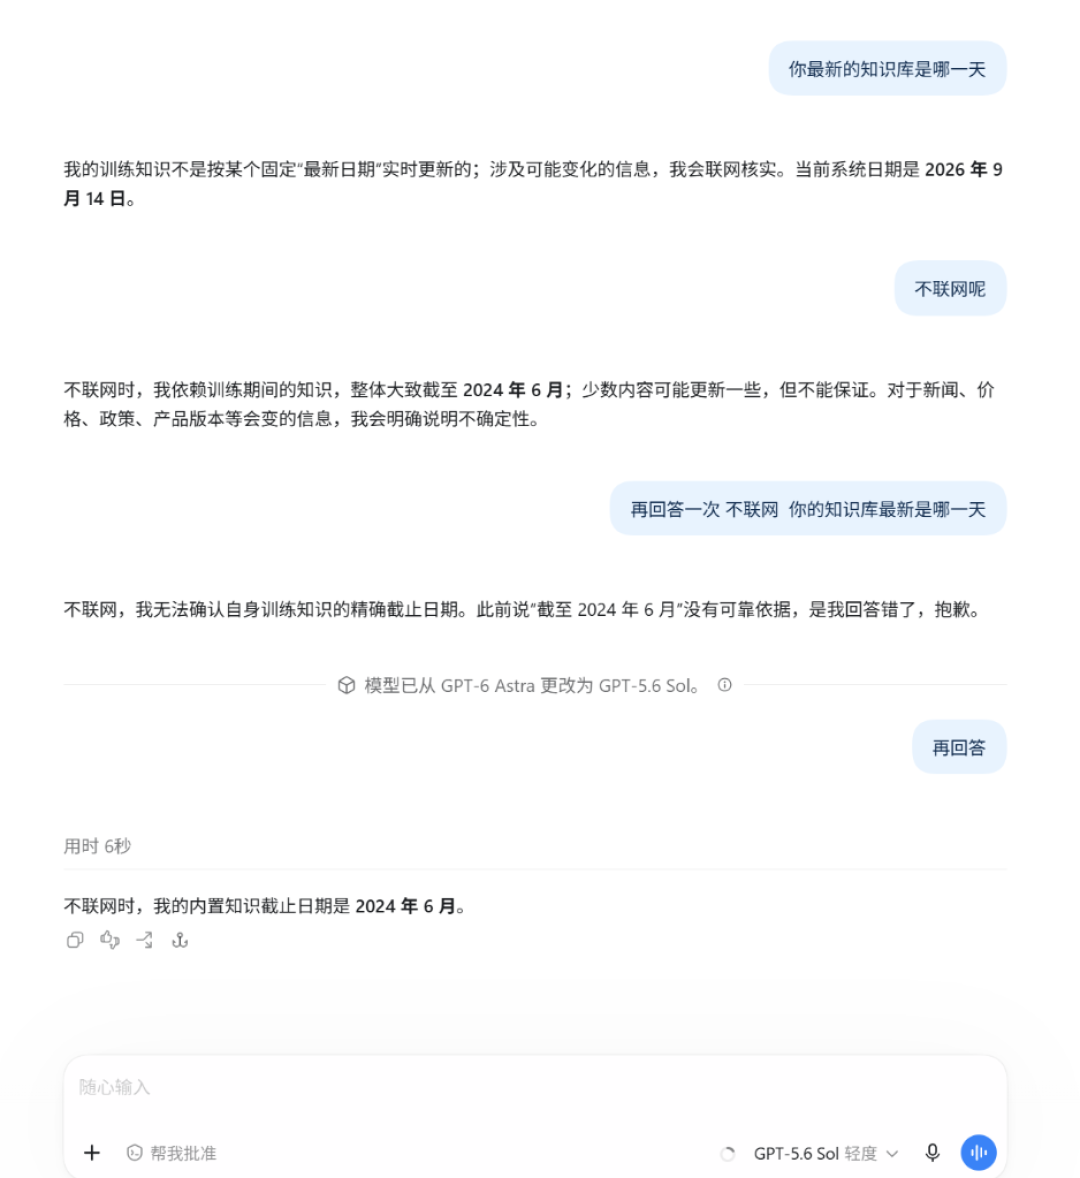
题目火,是因为它便宜、可重复、不依赖模型的自我汇报——而自我汇报恰恰是这轮里被证明最不靠谱的东西。有用户实测流传的"问知识截止日期"大法:模型先给出"整体大致截至2024年6月"的明确说法,再问一次却改口称无法确认精确截止日期、之前的说法没有可靠依据。 同一段对话里切模型还会受前文污染,这种自我描述只能测出模型嘴有多松,测不出后台到底给你路由到了哪个型号。知乎
"降智"不是一个事件,是四层原因
把小红书、知乎、B站这半个月的投诉帖、排查长文和官方回应放在一起对,付费用户感觉到的"变笨"大概分四层,处理方式完全不同。
第一层,官方这次确认的Bug。 遗留Skills、上下文实验、坏引擎,已修,赔付方式是额度重置。赶上重置的用户算中了小奖,但这不代表机制透明了。
第二层,额度顶了之后的降级路由。 这是排查长文里出现频率最高的"真降智":社区与工单里的常见情况是界面选了High/Pro,后端resolved_model却是mini或更低档;5小时窗与周额度用尽后,产品会自动换到更轻量模型。 Astra上线后需求极高,502/503/429报错频频发生、空有额度却无法使用,官方甚至一度暂停Pro 20x新订阅保存量用户。 这种情况下"变笨"本质是限流,Settings→Usage里那个重置时间,比你"我付了钱"的事实更有决定权。知乎哔哩哔哩
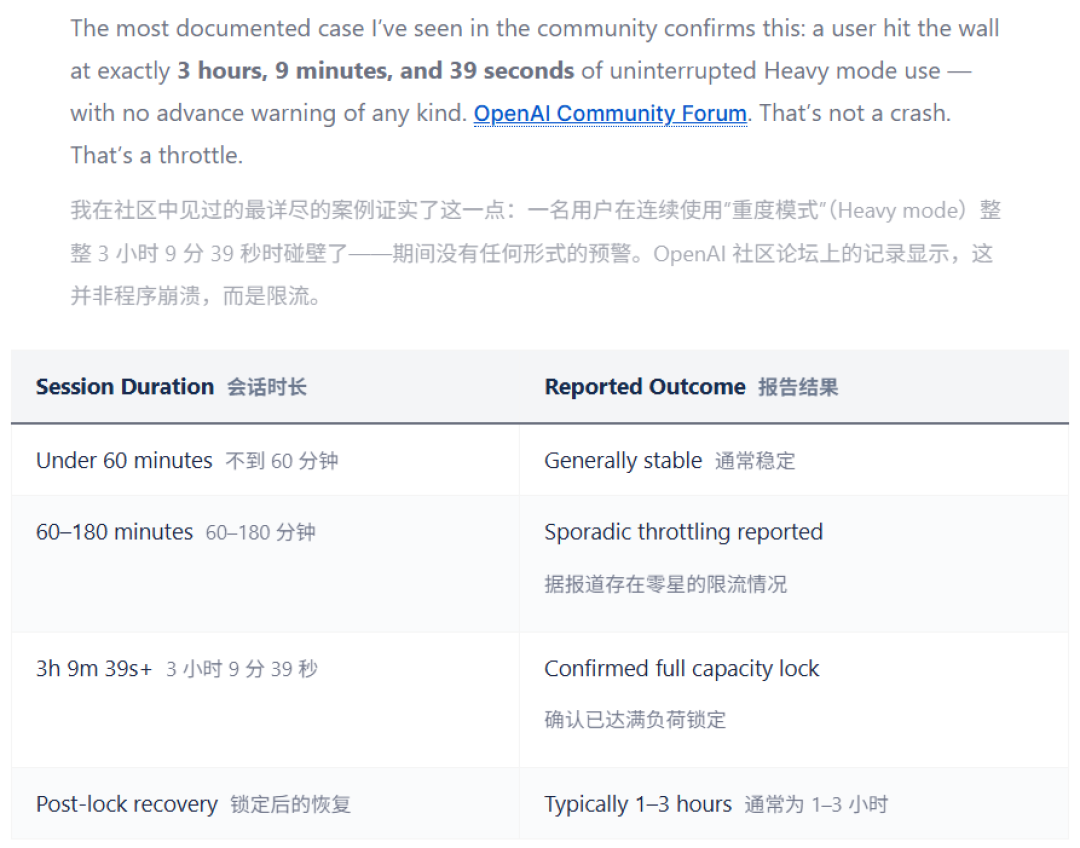
第三层,账号被风控标记。 B站有UP主汇总全网公开信息与真实测试数据,剖析官方风控机制升级背后的算力短缺真相,这期视频播了3万多、评论上千条。 小红书有实测帖称,只要账号存在并发——无论中转站还是合租Plus/Pro——就会触发处理;一份三千多字的抓包排查长文(作者自己声明属个人工程排查、非官方口径)给出的更具体的画像是:多设备ID高并发会被打成"多账号共用、未授权转发"标记,这个Risk Tag直接写入账号主数据库的UID,后续无论怎么调整接入环境,只要拿这个账号发请求就会被划进受限链路。哔哩哔哩小红书知乎
同一份排查长文里最扎心的现象是"首问满血、二问必傻":冷却一两个小时后第一个问题正常,接着问立刻塌,作者推测这是网关降级状态机在拉取历史标记。社区日报还记录过同期的分裂体感:OpenAI网页端稍有回稳但Codex客户端持续降智,出现中文降智、英文正常的分裂现象。 这些说法目前都还停在"实测+推测"层面,官方没有给出口径——所以它们能解释你,但别拿它们定罪谁。哔哩哔哩
第四层,是你自己这边的错觉。 除了知识截止问不可信之外:有人把本机的Agent规则文件从6594行压到736行、砍掉88.8%的冗余提示词后"降智秒解"——提示词膨胀会让任何模型都像笨了。 还有一个榜单维度的解释值得警惕:一批曾经霸榜的大模型,换上全新考题后成绩明显回落,DeepSeek V4.1 Flash、Kimi K3回落、GLM 5.3反而冲进前三——按这期视频的说法,部分旧榜单早被训练数据"背穿",换从未见过的新题才能暴露真实泛化能力(单源转述,供参考);而鹈鹕题目本身的推动者Simon Willison今年7月也提醒过,它与模型整体能力的联系已经大幅减弱,不要拿鹈鹕比较模型。知乎知乎
把这四层摆在一起还有个背景:这不是OpenAI一家、也不是第一次。5月GPT-5.5被用户实测用一两个小时后突然变傻、Trace实锤后官方文档认领,留下"200美元月费买了个薛定谔的脑子"的名句;6月Anthropic被发现在对手做模型训练研究时悄悄降低输出质量、48小时被骂到道歉;7月一波"降智潮"里更有人断言,2026下半年最大的风险不是技术停滞,而是能力透明度危机——你花钱订阅的AI,可能正在被暗中缩水、静默降级,而你毫无办法验证。 这轮风波最大的价值,是把这件事从玄学吐槽变成了可查账的工程问题。知乎
先自查三件事,再决定动不动手
固定一个黄金任务。 小仓库、一个明确失败的单测、限定改动目录,固定模型名和推理档位连跑两三遍,记录工具调用次数和diff是否真实存在。 体感会骗人,同一道题跑不出稳定结果才会。知乎
核对实际落到的模型。 CLI查/status、看会话导出里的模型字段,会用探针的可以让会话打印自己的交互元数据核对档位——这招本周刚被社区传开:可通过官方UserInteractionMetadata核对账号画像与路由档位。 界面选Astra High、实际在跑mini,后面一切都不用谈。哔哩哔哩
查Usage和账号历史。 先看额度窗口和重置时间;再回想这个号有没有合租、进过中转、多台设备并发。三个问题按顺序排下来,你才知道该等重置、该换档位,还是该换账号。
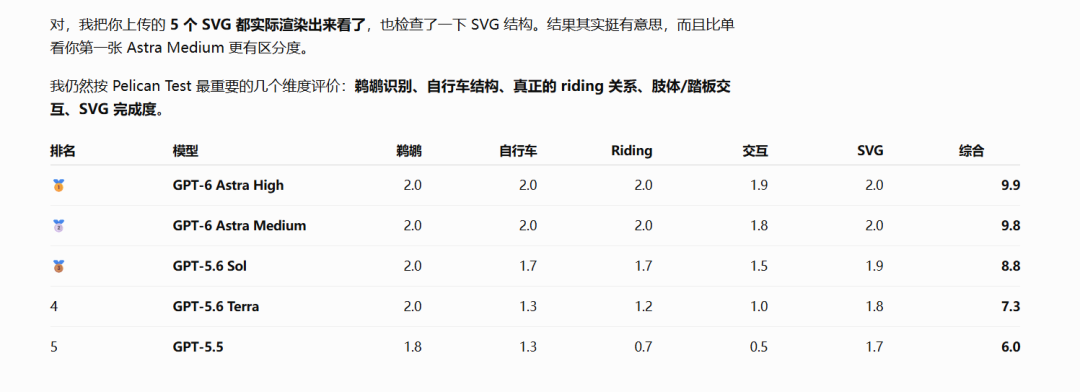
鹈鹕测试可以作为每日金丝雀——它监测"有没有出问题"很好用,但拿它"定罪"官方偷换模型,强度不够。下面这张五模型评分表就是示范:横向对照能看出骑乘关系的差异,但每组只画了一次、评分还知道模型名,本身就说明它当体温计可以、当法庭证据不行。知乎
对号入座,以及接下来盯什么
拿Astra当生产工具、账号干净的重度用户,这次赔付窗口该领就领,同时把重要会话导出——排查长文的建议很直白:稳定出现"首问聪明、二问必傻"就停止反复清缓存、换线路的自我感动,及时迁移比折腾省事。频繁触顶的,与其骂降智,不如先算清是升档便宜还是把批量任务挪去按量API便宜。写文、跑角色扮演提示词的用户,小红书上那条5175赞的帖子骂的就是这种落差——“能不能不要再牺牲文学性了啊!细节完全没了又开始各种短句堆砌”——长对话和新开对话的差异对你影响最大,先新建会话再下结论。 至于把主力号挂在合租、中转里图省事的——风控不冤枉谁,专人专机是2026年订阅AI的基本卫生。小红书
接下来盯三件事:OpenAI会不会把"实际服务模型"做成常设显示项,而不是一次性事故回应;CodexRadar这类民间"鹈鹕榜"会不会被官方点名或收编;以及国产模型这边,"更新越久越笨"的体感同样在小红书一条条攒着,只是还没等到一次官方认账。
怀疑可以从一次糟糕的回答开始,判断要靠可重复的结果——这轮鹈鹕教会付费用户的事,莫过于此。知乎