Redis之父的ds4冲到2.4万星:128G Mac跑V4.1 Flash是真的,但那是流式不是常驻——换机前,先把官方这张8行速度表读完
双11前的本地AI圈,这两周最热闹的名字不是哪个新模型,而是一个引擎。
10月27日早上,知乎上《大模型本地部署还得拼显存?Redis 作者开源 ds4》被顶上推荐;同一天,DeepSeek 新模型的单周调用量登顶全球、环比暴增 801% 冲上热榜——涨的量,正是 10 月 17 日发布的 DeepSeek V4.1 Flash-1017。两条消息叠在一起,把同一个问题推到了很多 Mac 用户面前:Redis 之父 Salvatore Sanfilippo(antirez)写的 ds4(DwarfStar),到底能不能把你那台"买时想着以后用得上、平时只开网页剪片子"的大内存 Mac,变成一台真正的 DeepSeek 机器?知乎
GitHub API 今天的数字:24,106 星、2,338 个复刻、843 个未关闭 issue,5 月 6 日建的库,最后一次提交在 10 月 23 日。小红书 8 月还是 20,212 星(“2万星开源项目,专治大内存Mac吃灰"那篇有 75 赞、151 收藏),B站有人拿 128G 的 M5 Max 实测拿到 9,677 播放,微博的说法是"很纯粹的 C 语言端侧推理引擎,专为大内存 Mac、CUDA 与 ROCm 打造”。小红书哔哩哔哩微博
热度是真的。但"能跑"和"值得为它换机"之间,隔着几张官方文档里的表。这篇文章只做一件事:把散在 README、MODELS.md、PERFORMANCE.md 和社区实测里的数字摊在同一张桌上,替 64G–128G 统一内存 Mac 这条线的用户算清楚。
先破一个误读:ds4 不是"又一个 Ollama"
社区里最常见的问法是"我装了 Ollama,还要不要换 ds4"。这个问题本身就问偏了——ds4 压根不是通用运行器。
README 写得很直白:它刻意"窄",不做一个能读万物 GGUF 的通用引擎,只为少数模型服务——DeepSeek V4 Flash(含实验版视觉)、V4.1 Flash、V4 PRO,GLM 5.2/5.3/5.3 Flash,Qwen3.8 Flash Next——而且必须用项目自己产出的 GGUF 文件,和 llama.cpp 生态的权重不通用。V4.1 Flash 有自己的一套 GGUF、分词器和推理图,官方原话:“V4 Flash 权重和 DSpark 支持文件与它不通用。”GitHub
换来的是什么?是针对这几家模型做的深度定制:MoE 路由专家权重的激进量化(官方动机里点名"DeepSeek V4 Flash 和 PRO、GLM 5.2 能容忍 expert 级量化")、直接落盘的 Engram 表、SSD Streaming、RDMA 双机张量并行,外加一个原生 Coding Agent(ds4-agent)和可接 Pi、OpenCode、Codex CLI、Claude Code 的本地 HTTP 服务。
所以它的真实定位是:** llama.cpp/Ollama 负责"什么都能跑",ds4 负责"把 V4.1 Flash 这类你真正想当主力用的模型,在你能买得起的机器上跑到最能跑的样子"。** README 自己也承认项目脱胎于 llama.cpp 和 GGML,一部分量化布局以 MIT 兼容方式保留在源码里——两者是路线之争,不是敌我之争。
另一个必须先知道的底色:README 里"AI full disclosure"一节写着,这个项目"在开发上强烈依赖 AI 编码代理,人负责想法、测试和调试",并且补了一句相当硬的话——"如果你不接受 AI 写的代码,这个软件不适合你。“加上官方自述"仍在快速变化、beta 质量、回归和兼容性问题都可能出现”,以及那个 843 的未关闭 issue 数:尝鲜可以,All in 要等。GitHub
官方速度表只有 8 行:同一句"128G",两台机器是两个物种
PERFORMANCE.md 里目前只放了一张正式的自报表——注意,跑的是 V4 Flash Q2 常驻模式,还没有 V4.1 的行(条件:2048-token 递进 prefill、每档 128 token greedy 生成,官方标注"这是记录基线,不代表每个 commit 的复测"):
机器 | 上下文 | Prefill | 生成 |
|---|---|---|---|
M5 Max,128G | 2K | 790.18 t/s | 39.35 t/s |
M5 Max,128G | 16K | 572.53 t/s | 36.14 t/s |
M5 Max,128G | 32K | 557.04 t/s | 34.36 t/s |
M5 Max,128G | 64K | 398.50 t/s | 27.64 t/s |
DGX Spark,128G | 2K | 825.76 t/s | 18.05 t/s |
DGX Spark,128G | 16K | 872.44 t/s | 15.10 t/s |
DGX Spark,128G | 32K | 855.94 t/s | 14.43 t/s |
DGX Spark,128G | 64K | 822.98 t/s | 13.84 t/s |
这张表里藏着两个反直觉:
一、"128G 内存"这四个字,在 Mac 和 Spark 上是两回事。 Spark 的 prefill 全程稳在 820–870,比 M5 Max 还快——喂长文档、重放上下文的场景它占优;但出字速度 M5 Max 是它的两倍还多(39 vs 18),而且随上下文增长掉得也更明显(64K 时只剩 27.64,Spark 反而几乎不掉)。做日常对话和 Agent 连续生成,Mac 是快的那台;批量喂料型任务,Spark 的 prefill 曲线更适合挂机。
二、出字"能不能看"的分界点在 32K,不在 64K。 M5 Max 从 2K 到 32K,生成只从 39 掉到 34,体感几乎不变;真正跳水发生在 32K→64K(34.36→27.64)。也就是说官方数据支持的甜区是把上下文控制在 32K 上下——这恰好和 B站评论区最尖锐的那条差评对上:“agent 的系统 prompt 会到 20K,检索一下输入就大几千 tokens,这种场景的测试才有意义。” 官方表支持 64K,但按这曲线,64K 的 27 t/s 属于"能用但不痛快"。哔哩哔哩
双11 前被反复提到的"拼显存"逻辑,在 ds4 这里要换成:统一内存容量决定"装不装得下常驻",本机 SSD 带宽决定"装不下时流式跑多快",而上下文长度决定这两件事各自打几折。
真正的门槛在 V4.1:152 GiB 主权重,比你的 128G 大一圈
把"我家 128G Mac 能不能跑现在最火的 1017 版"这个问题拆开,MODELS.md 给了全部答案。V4.1 Flash 三档量化:
量化档 | 文件大小 | 主权重 | 官方口径 |
|---|---|---|---|
Q2(1017 checkpoint) | 341 GiB | 152 GiB | 单台 128G Mac/Spark:SSD 流式;双 128G 机器 RDMA:常驻分片(每机约 81 GiB);256G+ 整机常驻(M3 Ultra 512G 实测过) |
Q4(上一版 checkpoint) | 483 GiB | 294 GiB | 小内存机器只能流式;常驻需要 512G Mac;双 128G 常驻 TP 放不下 |
MXFP4(1017) | 467 GiB | 278 GiB | 下载需合并九片,磁盘预留约 935 GiB |
三档之外还有一个对所有档生效的硬条件:189 GiB 的 Engram 表在所有模式下都不进内存、直接按需读盘,官方明确要求"放在高速本地 SSD 上"。换句话说,ds4 的"大内存"叙事之外,PCIe 4.0/5.0 的固态带宽是第二入场券,老款外接盘党先醒一醒。GitHub
于是"128G Mac 跑 V4.1 Flash"的正确读法是:不是不能跑,而是默认跑在 SSD Streaming 模式(`./ds4 -m gguf/DeepSeek-V4.1-Flash-1017-IQ2_XXS-Q2_K-imatrix.gguf --ssd-streaming --ctx 32768`)。能不能跑 = 真的能;跑得=官方速度表那个 39 t/s ≠——那张表是 V4 Flash 常驻的数据,官方文档至今没有给出 V4.1 流式模式的自报速度。想先验证的,抄官方 PERFORMANCE.md 里的 ds4-bench 自己跑一遍 2048→65536 递进,这是唯一不掺水的路径。知乎
顺带把几个常见"我到底该下哪个"一次排掉:
96–128G 想要常驻体验:下 V4 Flash Q2(约 81 GiB),官方明说这是"96/128 GB 系统的起点";B站实测视频里内存占用约 70 GiB,有用户观察到请求瞬间冲到 134G 又回落——留余量,别把机器塞到只剩十几 G。
只有 64G Mac:V4.1 够不着,入场券是 Qwen3.8 Flash Next 的 Q2 小版本(主+MTP 权重 41.73 GiB,文件里另有 95.37 GiB BF16 n-grams 常驻读盘),官方建议从 8K 上下文起步。
两台 128G Mac/Spark:RDMA 张量并行,每机 81 GiB 主权重常驻,这是官方文档里"不加钱换大机器"的正解;但注意官方自己提醒:网络通信开销高时,两台未必快过一台。
256G+:V4.1 Q2 整机常驻;512G 才谈 Q4 常驻。
N卡用户别凑热闹:ds4 的 CUDA 路线官方主目标是 DGX Spark,外加 Ada(L40S 八卡 16 路会话合计 126 t/s)这类多卡工作站;消费级单卡的异构分片方案,那是 Strata 们的赛道,不是它的。
V4.1 这波为什么值得重新讨论:1017 把"能跑"的性价比抬了一档
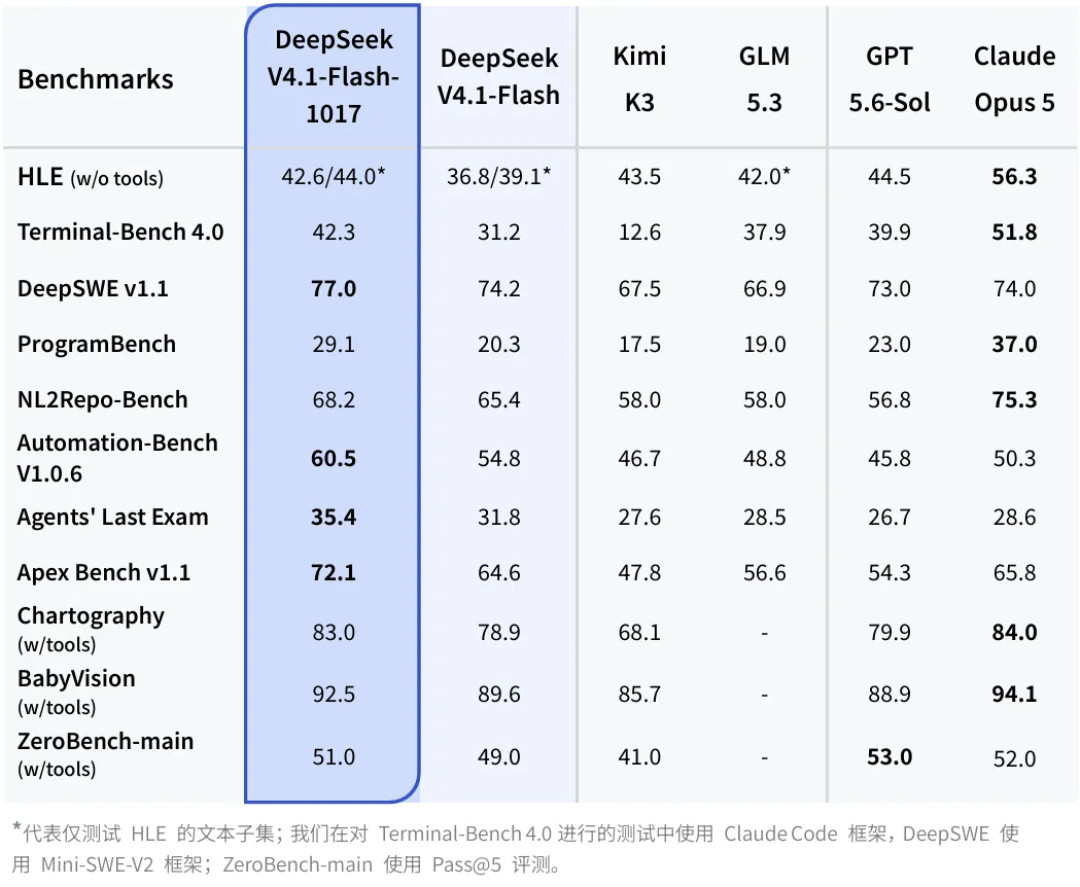
为什么是现在?10 月 17 日发布的 V4.1 Flash-1017 是这两周所有变量的源头:单周调用量登顶、环比暴增 801%;B站引进的 Donato Capitella 实测解读提到 1017 版输出 token 比上一代少 44%,并且直接跑在 Strix Halo 的 Framework Desktop 上、引擎就是 DwarfStar。少 44% 的输出 token,在本地意味着同样的生成速度下、同样的任务多近 8 成的"免费秒数"——这比任何一项引擎优化都更直接地改善家用机体验。哔哩哔哩
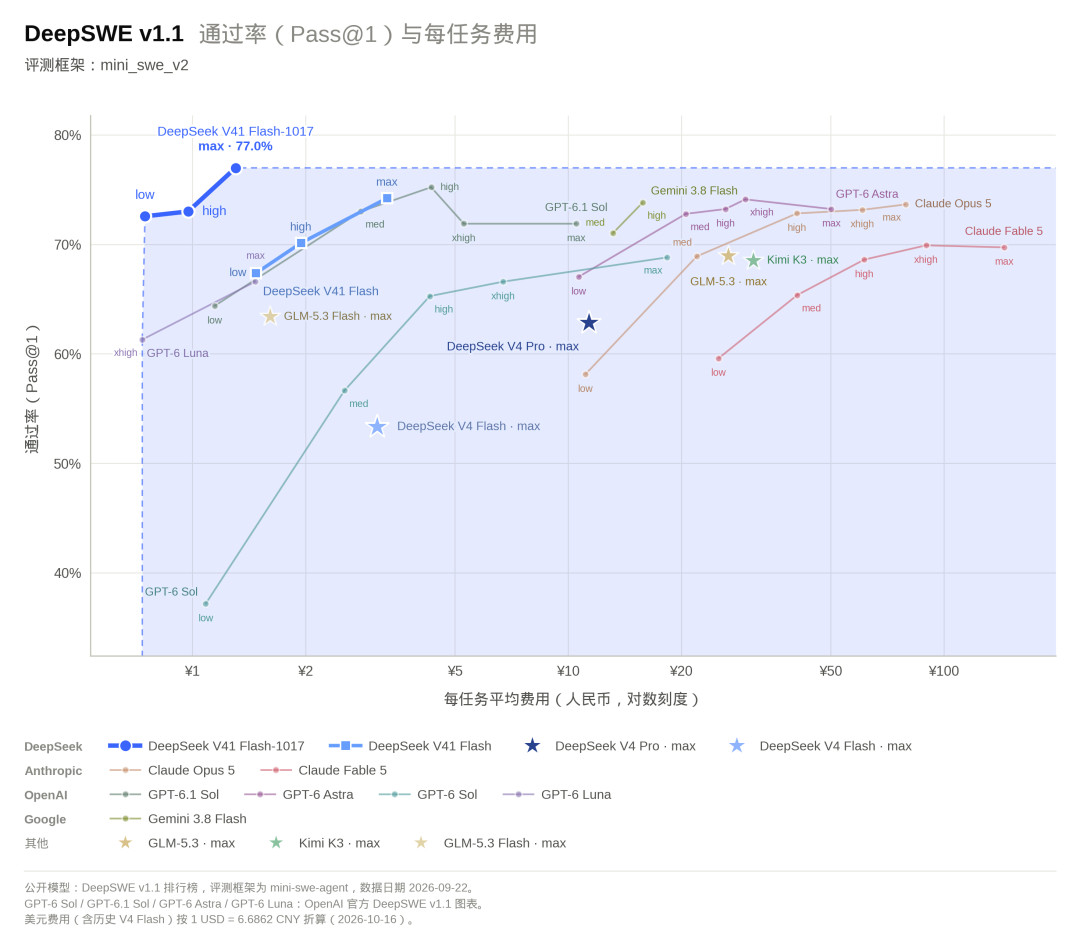
ds4 还给了一个很多人没注意的旋钮:V4.1 支持 `–think-level 1–100`(`–think` 默认 75,`–think-max` 100,0 关闭思考)。在本地算力预算下,把思考强度从 75 调到 25,本质是"用自己的速度换模型的推理深度"。B站评论区那句"这个智商有很大下滑么"问的就是量化+思考档位的双重折价——目前社区没有公开的对照测试,这也是双11 前最值得自己跑一遍 `ds4-eval`(官方内置能力回归,README 特意强调"这是集成检查,不是跑分榜单")的原因。
双11 前给三类人的判断,和两条继续观察的信号
把上面所有数字压缩成可执行的话:
1. 手里已有 96–128G 的 Apple Silicon Mac:先跑,不动钱包。 今天 ds4 对你就是"免费让吃灰机器长出一个主力模型":V4 Flash Q2 常驻起步(官方速度表那档 39→27 t/s),V4.1 用 `–ssd-streaming` 自己测出你的流式真实速度,再决定要不要动下一步。别按常驻表预期流式体验,这是本轮最大的坑。
2. 双11 准备"为了本地AI"升级 Mac:把预算问题换成容量档位问题。 64G 只能摸到 Qwen3.8 Q2 的门口;96–128G 是"新模型永远差半档常驻、靠流式过渡"的档位;256G 才让 V4.1 整机常驻成立;512G 才谈 Q4 常驻和更大的 GLM 5.x。ds4 官方测试名单里常驻 V4.1 只有 M3 Ultra 512G——目前没有任何官方数据支持"128G 流畅常驻 1017"这个说法,销售页和你的期待之间,隔的就是这个。GitHub
3. 两台机器的囤积党/小团队:这是 ds4 相对 llama.cpp 的独占场景。 RDMA 双 128G 常驻分片、流水线并行拼内存,README 明确"支持其他后端不支持的多卡组合"(DGX Spark 集群党可以把这当成官方给出的第二种玩法)。单机党不用眼红,官方也说了:个人一台机器,多设备并行暂时用不上。
两条继续观察的信号:其一,官方速度表什么时候补上 V4.1 行——PERFORMANCE.md 已写明流式测试要"记录有效缓存、区分冷启动和热缓存",128G 单机的真实流式数据大概率以这种形式出现,出现之前所有"128G 跑 V4.1 飞快"的转述都不作数;其二,843 个未关闭 issue 和"beta 质量"的消长——10 月 23 日还在推提交,版本快速变化期,主力工作流别迁移,挂个 release watch 等它稳。
最后说句圈内的话:Redis 之父用 C 重写一个"只伺候几个模型"的引擎,这件事本身就是本地部署圈从"什么都能跑"走向"把最该跑的那个跑到能用"的注脚。显存党有显卡党的账要算,Mac 党从今天起也有了属于自己的那张 8 行速度表——先把表读完,再决定钱和硬盘位花在哪儿。