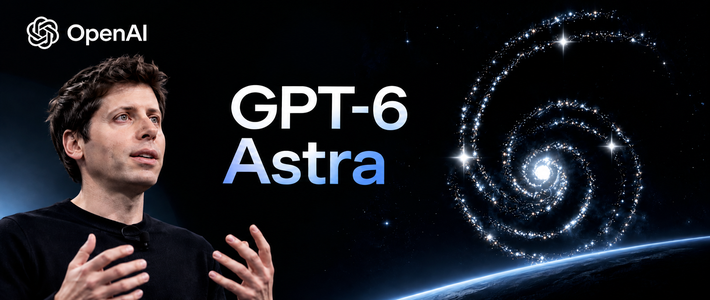
GPT-6定价涨2.5倍,单次贵但复杂任务总成本反而更低
09-04 19:34
精选参考来源

名人张聊 2026-09-02
来自新浪微博
康钊 2026-08-28
来自新浪微博来源
精选参考来源
1. #8月大模型日均发布1.1个#内卷的风也刮到大模型行业了。8月大模型行业进入“日均发布1.1个”的高频迭代节奏,月内有30余个开源模型/项目更新。其中,国产模型占据主导地位。DeepSeek、千问、智谱、腾讯混元、商汤、蚂蚁等密集开源,覆盖端侧部署、多模态、视频生成、Agent等方向。Claude、ChatGPT、Gemini等海外模型同步迭代,但开源节奏明显不及国产阵营。另外,国产开源阵营集体换挡,竞争焦点正从“拼参数”转向“拼计算效率与场景落地”。多款MoE模型将总参数推至数百B,单次推理仅激活数B至数十B,以有限计算量承载更大能力容量,以降低成本提升效率。Agent、AI编程、具身智能持续升温,AI竞争走向产品能力与实际应用。截止到6月,我国日均token调用量已突破500万亿,OpenRouter上中国模型Token调用占比从去年4.5%飙升至50%以上,前五全为中国模型,算力需求爆发式增长。#老张聊科技# #8月大模型日均发布1.1个#

新浪微博 2026-09-02 00:00:00
2. 千问办公上线Qwen3.8-Flash,专治Agent“Token焦虑”,量大管饱Agent圈现在最头疼的,不是模型不聪明,是Token烧不起。IDC预测,2026年我国企业级Token消耗量将同比增长约20倍。重度玩家一天干掉10亿Token,耗费数千美元。而且,同一个任务,Agent工作流的Token消耗是聊天机器人的5到30倍。用AI用出了理财的感觉,打开任务还要先算成本,大伤脑筋。昨晚阿里放出Qwen3.8-Flash,千问办公第一时间接入,同步上线标准模式,模型的Token生成速度提升100%,Token消耗减少75%。先说一下这模型:千亿总参数,仅激活60亿,官方口径性能超越Claude Opus4.6;每百万Tokens输入0.8元,输出2.7元,不到Claude Opus4.6的1/40,比DeepSeek-V4-Flash忙时价格的1/3还低。#景甜下沉市场口碑#
新浪微博 2026-08-28 00:00:00
3. Qwen3.8-Flash-Next 突然开源!125B 模型本地运行,显存不够硬盘来凑,居然真能跑!部署实测来了 | 零度解说

哔哩哔哩 2026-08-29 00:00:00
4. #智谱上半年业绩#【#智谱上半年收入超去年全年#,API收入激增2736%】#智谱上半年营收9.539亿#智谱发布2026年中期业绩。业绩显示,2026年上半年,公司实现收入9.54亿元,同比增长近400%,超过去年全年。其中,智谱MaaS开放平台及API业务收入达到8.25亿元,同比增长2736%,占公司上半年总收入的86.5%。截至8月底,智谱MaaS开放平台Token调用量较年初增长超过40倍,付费日活用户增长603%,前十大客户日均调用量增长98倍。与此同时,API平均售价提升约101%。业务增长同样反映到用户和调用量上。智谱表示,随着模型架构和推理基础设施持续优化,公司单位Token推理成本较年初下降80%,单位算力投入(包括训练与推理)所对应的收入提升14倍,MaaS业务毛利率提升至24.6%。(新浪科技)
新浪微博 2026-08-31 00:00:00
5. #全球最强模型Fable5.1发布#这玩意纯纯考试怪。Terminal-Bench-Science 和 AutomationBench 分数都翻倍了,然而你去对比 Opus 5,GDPval-AA v2 只领先 29 分,CursorBench 从 70.5% 提升到 73.4%.llm-stats 的综合分上它输给 GPT-5.6 Sol,DeepSWE 甚至还是下降的。缓存命中降价 25%,然而它跟 Kimi K3 有点像,复杂任务会疯狂开一堆 Agent,烧 Token 也快多了。最终完成任务花的钱一点也没少甚至可能更多
新浪微博 2026-09-02 00:00:00
6. OpenAI买数万台Mac训练AI——2026年最反直觉的算力新闻。据The Information:OpenAI采购了数万台Mac mini和Mac Studio,跑强化学习和computer-use智能体训练;Anthropic也在通过AWS租Mac算力。英伟达已把苹果视为本地AI处理的顶级对手。为什么是Mac?统一内存架构。CPU和GPU共享同一块高带宽内存,训练"操作电脑的AI"这类任务时,避开了传统GPU集群的某些瓶颈。消费级硬件,意外成了前沿实验室的基础设施。同日另一条:微软泄露文件显示一名员工28天烧掉2.8万美元Token,公司已开始收紧内部AI用量监控,默认负载切到更便宜的GPT-5.6 Sol。两条新闻合起来就是当下AI行业的完整切面:1. 算力饥渴没有尽头,连Mac都成了采购标的2. Token成本已经大到巨头也要盯着每个员工省3. 苹果Mac营收涨29%,成了最意外的AI受益者 Scaling的尽头是什么?目前看是账单。
新浪微博 2026-08-31 00:00:00
7. 我和很多人聊下来,大家思考问题啊都是非常理想化的状态,与现实就根本不符。你就比如说AI的降本增效我说多数的多数都是投入产出比负的。为什么?token的费用我就不说了,我们不能默认大家都聪明人,找的供应商都靠谱,然后流程一跑就通,维护成本也低。这不是现实,这是童话故事真的情况下,先试错,培训,买课花了很多钱。然后自己去操作了,发现token烧也就算了,之前花的钱还不知道啥时候能回本呢。然后等到你稍微熟练点了,结果新的工具又来了,热点又来了。你永远都在投入,产出不知道啊另外很多小伙伴每个月拿固定窝囊费的,就别谈什么ROI了,根本就是苏联笑话
新浪微博 2026-09-03 00:00:00
8. 中国每天消耗500万亿词元!两年前才1000亿。 AI的使用量,正在以普通人想象不到的速度疯狂上涨。 有一组实打实的数据,让人看完很震撼。 咱们国家每天消耗的AI词元,已经达到500万亿个。 而在2024年年初,这个数字仅仅只有1000亿。 短短两年时间,直接暴涨5000倍。 8月31日,腾讯副总裁司晓在大数据产业博览会上,公开了这组数据。 很多人会以为,这么庞大的数量,全是普通人聊天、提问消耗出来的。 其实并不是。 绝大部分调用,来自AI智能体自己在后台自动干活。 AI智能体去完成一整套复杂任务,消耗的词元,可能是普通一问一答的3500倍。 现在已经形成一个循环: 模型调用价格越便宜,使用的人和机器就越多;用量上去之后,又需要投入更多算力来支撑。 这个增长的飞轮,已经实实在在转起来了。 同一场会议上,国家数据局局长刘烈宏也讲了一番话。 词元,是机器智能最小的计算单位。一项技术不光要做得出来,更重要的是老百姓能用、用得起。 这里说的词元,就是大家常听到的Token。 今年3月,国家数据局正式确定Token的中文叫法就是“词元”。 之后节奏推进得很快。 5月,专门开了词元经济座谈会。 6月,“词元交易”写进官方文件。 7月,又鼓励大家围绕词元去探索新的商业玩法。 短短四个月,原本只是技术圈的专业名词,变成了官方认可的经济概念。 这背后释放的信号很清楚。 词元,会成为AI时代的水电煤。 以后消耗多少词元,就好比家里用了多少度电、多少吨水,会成为AI世界的基础计量单位。 但它和水电又有本质不一样。 词元并不是随便用、没有成本的。 每生成一次词元,背后都要消耗算力、储存空间和电力。 拆开成本来看,七成开销花在芯片、内存、电力这些硬件上面,算法只占到两到三成。 看着是软件AI,底层其实是重硬件、重能耗的重工业。 这也就理解了黄仁勋那句“算力就是营收”。 这不只是讲给资本市场听的大话。 我们每消耗的一个词元,背后,都是实实在在的金钱成本。 风险提示:本文仅行业资讯梳理,不构成任何投资建议。 信息来源:科技日报、国家数据局、新浪财经 #AI #词元经济 #算力 #科技观察

今日头条 2026-09-01 00:00:00
9. 500 万亿。 这是我国目前每天的 AI 词元调用量。2024 年初,这个数字是 1000 亿。两年,涨了 5000 倍。 词元(Token)你可能没概念,但你每次和 AI 对话、生成一张图、写一段代码、让 AI 整理一份文档,背后都是海量词元在流动。它是大模型处理信息的最小单元,也是衡量 AI 真实使用规模最核心的指标。 国家数据局 8 月 29 日发布了这个数据。更值得注意的是增长结构 —— 不是大家在跟 AI 闲聊,而是 AI 在 "干活":写代码、做设计、处理文档、生成视频、跑数据分析。夜间 AI 漫剧的批量生成渲染,甚至成了算力消耗的新高峰。 【如是道】:500 万亿这个数字,比任何发布会都更说明问题 ——AI 已经从 "新鲜玩具" 变成了 "水电煤"。 两年前,大多数人用 AI 是 "问个问题试试";现在,很多人的工作流里已经离不开 AI 了。这个转变的速度,比所有人预期的都快。 对普通人来说,这意味着两件事: 一是 AI 的使用成本会继续下降。调用量越大,规模效应越明显,单位词元的价格会越来越便宜。两年前用 AI 写篇文章可能要几块钱,现在几毛钱。 二是 "不会用 AI" 的成本会越来越高。当周围的人都在用 AI 提速,你不用,不是 "保持传统",而是在主动降速。 你现在每天用 AI 做什么?是偶尔问个问题,还是已经嵌进工作流里了? #AI 应用 #词元 #人工智能
今日头条 2026-09-02 00:00:00
10. 10万亿参数!OpenAI强行曝光GPT-6:2000美元破解10个世纪难题,一批白领正沦为”初代数字炮灰”

知乎 2026-08-29 00:00:00
11. 大厂也扛不住Tokenize浪费了。 最近,微软内部发邮件,警告工程师不要再搞“Tokenmaxxing”——也就是为了KPI,盲目地、大量地消耗AI模型的Token。 作为AI领域的头号玩家,微软难道不应该鼓励员工尽可能多地使用自家产品吗? 过去一年,大家都在比拼模型参数多大、能力多强、应用多广,Token消耗量甚至一度被视为AI战略落地深度的指标。 这次的内部信其实说明一件事:AI已经从一个需要不计成本投入的“前沿技术”,回归到了一个需要计算投入产出比的“商业工具”。 第一,成本是刚性的。尤其是像GitHub Copilot这样的工具转向按使用量计费后,每一行AI生成的代码、每一次调用,背后都是实打实的算力开销。当这种开销乘以微软数万名工程师时,就成了一笔无法忽视的运营成本。 第二,产出是模糊的。大量消耗Token,并不直接等同于创造了商业价值。工程师可能只是用它生成了大量低效或无用的样板代码。当成本变得清晰可见,而产出却难以衡量时,任何一个理性的公司都会踩下刹车。 当行业领头羊开始精打细算,意味着“烧钱换增长”的狂热期正在退潮。所有企业都必须从技术狂欢中冷静下来,思考如何让AI真正服务于业务,并带来可量化的回报。 当AI的电费账单送到每个人面前时,真正的考验才刚刚开始。 #人工智能##微软##科技评论#
今日头条 2026-08-31 00:00:00
12. AI用量越大越烧钱?这个开源项目专治
今日头条 2026-09-01 00:00:00
13. GPT-6灰测Demo刷屏:一个提示词造出完整舰艇,9月4日见
今日头条 2026-09-02 00:00:00
14. 一个隐藏方法,大幅降低Codex的Token消耗
哔哩哔哩 2026-09-02 00:00:00




-
 移动8元卡,实现6G流量,老用户20G+,30分钟通话87 242
-
 懂车帝刹车断裂视频下架,尊界一夜反转131 950
-
 免费!!让你的上古打印机支持手机打印80 73
-
 全网掀起踩刹车大赛!小米6月直播意外火了,连续50次刹停117 560

已收藏
去我的收藏夹