
B站上有个27万播放的视频,标题特扎心:“现在怎么没有人提用AMD MAX395去跑本地大模型了?”。哔哩哔哩
确实,上半年这台顶着"128GB统一内存"的迷你主机可是本地党的白月光:不用独显、不爆显存、能把两百多亿参数的大模型整个塞进去。结果这几个月N卡涨疯了没人吭声,它反而安静了。
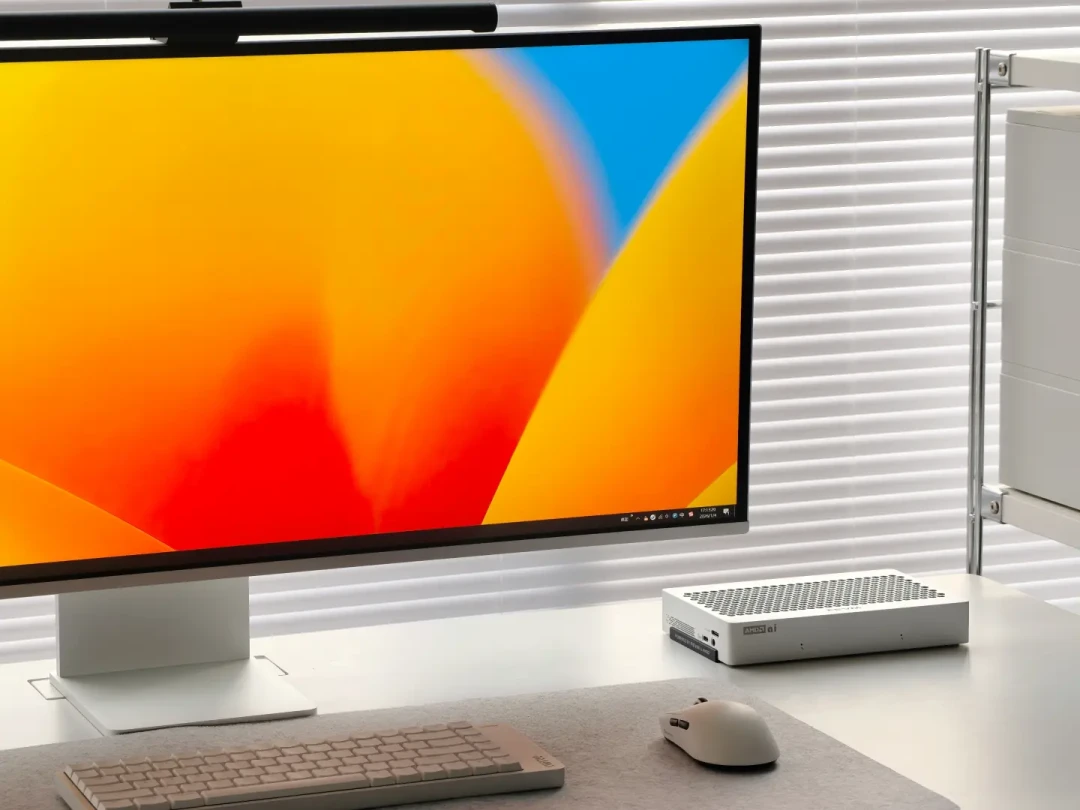
但就在这周,三件事把它重新拽回牌桌。8月18日,AMD官方给刚开源的Qwen3.8-27B做了Day 0支持,发布当天就能在锐龙AI Max+上本地跑。知乎同一天,下一代旗舰Ryzen AI Max+ Pro 495的消息落地。而背景板,是过去12个月涨了500%的内存价格。知乎
涨价潮里,这条"统一内存"路线到底还值不值得上车?我把官方数据、全网实测和踩坑帖都对了一遍,今天一次说清。
先看速度:27B稠密模型,迷你主机真能干活
AMD这次给的官方数据很具体:Qwen3.8-27B在锐龙AI Max+ 395上最高24.5 token/s,测试环境是Windows+llama.cpp+Vulkan后端,开了MTP=4(多token预测加速)。知乎
社区实测比官方还猛一点。小红书一位玩家拿到机器当天就跑了测试:128GB统一内存的AI Max 395,Q4量化+MTP=3,连续输出9分17秒,吐了16121个token,平均28.9 t/s全程没掉速。小红书测试任务是让模型一次性设计一款3D赛车游戏——核心玩法、物理操控、HUD、小地图全带,生成的html打开直接能玩。他自己也提醒:这是Q4量化的成绩,BF16精度会慢一截。
什么概念?知乎上4090用户跑同一个模型的反馈是"真能干活",而一张5090D V2现在要2.4万,4090也早不是当年的价格。知乎一台迷你主机把27B稠密模型跑到接近30 t/s的可用速度,这在半年前是想都不敢想的。
真正的杀手锏:N卡塞不下的模型,它能塞下
但27B不是这台机器最值钱的地方。它真正不可替代的,是那些"24G、32G显存连模型本体都放不下"的大家伙。
DeepSeek V4 Flash,284B参数的MoE模型,有玩家实测单机跑官方版本:吃掉106G内存,速度接近15 t/s。小红书开发者优化版能冲到32 t/s。哔哩哔哩Qwen3.5-122B-A10B在上面的口口相传数据是20 t/s左右。
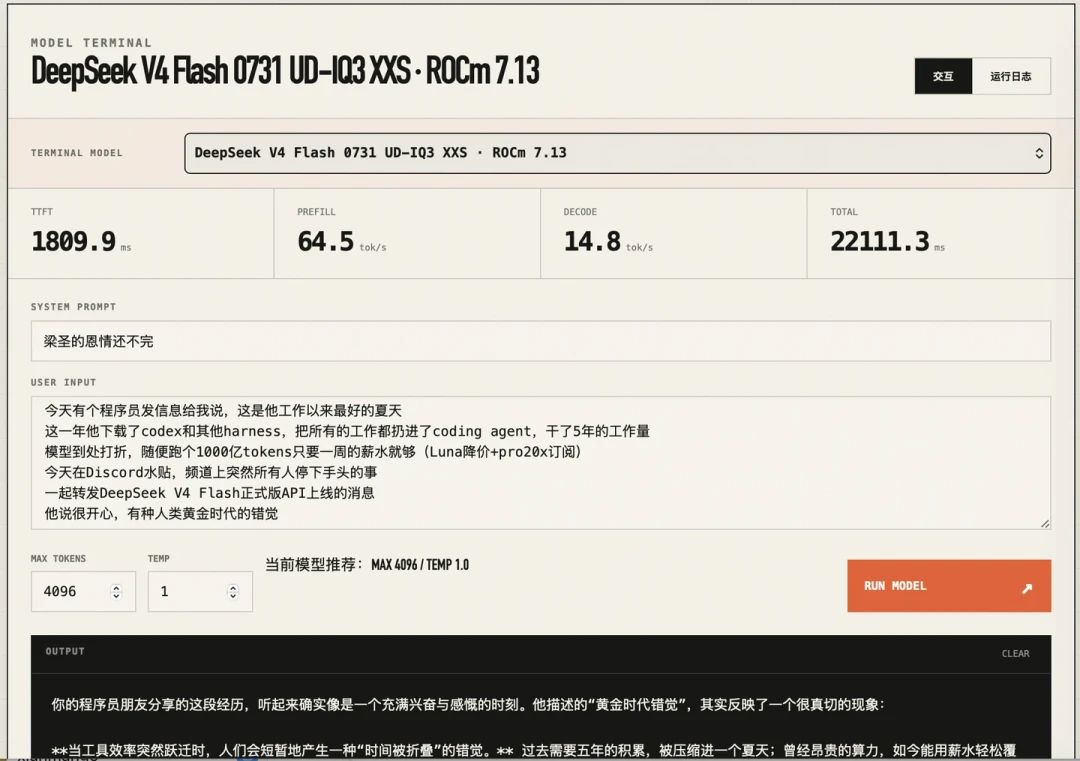
为什么128G内存的迷你主机能跑284B,速度还不算难看?这里有个关键认知:统一内存架构是"容量决定能不能跑,带宽决定跑多快"。AI Max 395的内存带宽大约256GB/s,跑全参数激活的稠密模型(比如27B)带宽压力不小,所以24-29 t/s就是它的天花板;但MoE模型总参数大、每次只激活一小部分——122B-A10B每次只激活10B参数,带宽一下子就够用了。
反过来看N卡阵营:想跑DeepSeek V4 Flash?106G显存,两张5090加起来都不够,更别说现在这个行情。这就是统一内存路线的生态位——它不是最快的,但它是"千亿参数模型进家庭桌面"门槛最低的一张票。
坑先说清楚:涨价和软件生态,一个都跑不了
先泼冷水。第一盆:整机价格已经被内存涨价带飞了。 今年3月就有小红书用户吐槽,多款AI Max 395迷你主机一夜涨价,自己看中的那台涨了4400元。小红书8月零刻发布新品时干脆直说"AI Max 395赶上内存和硬盘涨价,价格直接上天起飞"。哔哩哔哩AMD官方开发者整机Ryzen AI Halo定价3999美元。知乎去年同期1.5万上下就能拿下的128G整机,现在基本绝迹。买之前一定多平台比总价,别只盯着处理器型号。
第二盆:AMD的软件生态还是有门槛。 想跑AI绘图的注意,Windows下AMD卡走DirectML跑ComfyUI报错是常态,专门的排错视频都被收藏了几十次。哔哩哔哩跑语言模型建议走llama.cpp+Vulkan或者ROCm 7.13以上版本,后者最近优化幅度不小。好消息是生态补得很快——5月还有人吐槽llama.cpp的MTP分支连模型都转换不了,现在AMD官方已经把MTP=4写进了推荐设置,还特别提醒LM Studio用户取消勾选"Try mmap",否则速度打折。知乎
3种人,3个结论
数据对完,给结论。
第一种:想把百亿级MoE大模型塞进本地当Agent、知识库、私人助理的。 DeepSeek V4 Flash、Qwen3.5-122B这个级别,N卡方案现在要么显存不够、要么预算上天,128G的AI Max 395是眼下门槛最现实的路线。建议买正规厂商整机,重点看散热和总价,到手先跑一遍MoE再验稠密。
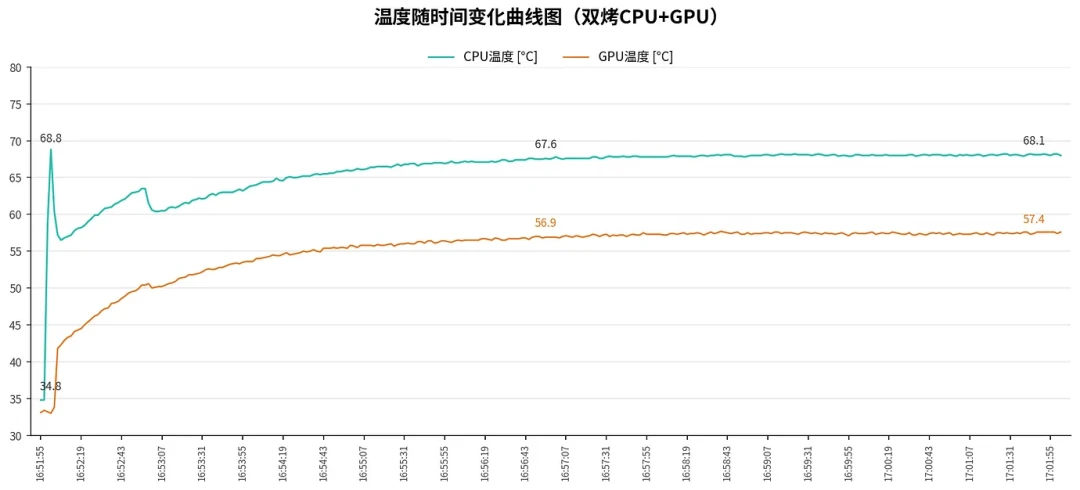
第二种:只想跑27B稠密模型高速写代码、当编程Agent的。 统一内存不是你的最优解。24.5-28.9 t/s够用,但天花板肉眼可见;单张R9700 32G官方数据51.8 t/s,N卡阵营虽然贵但快。预算有限就看看上一代24G卡,别为用不上的内存买单。
第三种:预算万元以内的。 别硬上。16G显存的卡跑27B的3-bit量化版照样能用,或者干脆再等等——Ryzen AI Max 400系列已经现身,旗舰Pro 495最高支持192GB内存,等新品上市,老款的价格才真正有看头。知乎
最后给几个值得盯的信号:内存现货价格什么时候松动、Ryzen AI Max 400系列的正式发布和定价、llama.cpp/vLLM对统一内存的进一步优化。这三个里任何一个有动静,这条路线的性价比都会重排一次。
N卡党别急着嘲讽,统一内存党也别急着吹。涨价潮把所有人都逼到了同一张桌子前:谁能用更少的钱跑更大的模型,谁就是这两年的答案。AMD这台小主机未必是终点,但它现在确实是最值得盯着的那条路。











Chad_liang
校验提示文案
iduzy
以上都是实测,这种小机器要并发还是moe比较实际,目前ornith1.5 35b是个不错的选择
校验提示文案
keesuper
中小企业有数据安全焦虑上DGX咯。
校验提示文案
胡言乱语论
校验提示文案
贾虫
校验提示文案
老婆说买咱就买
四千块两张2080ti22G都能干上100t/S
解码速度1600t
校验提示文案
陈太爷
校验提示文案
Delight
校验提示文案
Delight
校验提示文案
陈太爷
校验提示文案
iduzy
以上都是实测,这种小机器要并发还是moe比较实际,目前ornith1.5 35b是个不错的选择
校验提示文案
老婆说买咱就买
四千块两张2080ti22G都能干上100t/S
解码速度1600t
校验提示文案
Chad_liang
校验提示文案
胡言乱语论
校验提示文案
贾虫
校验提示文案
keesuper
中小企业有数据安全焦虑上DGX咯。
校验提示文案