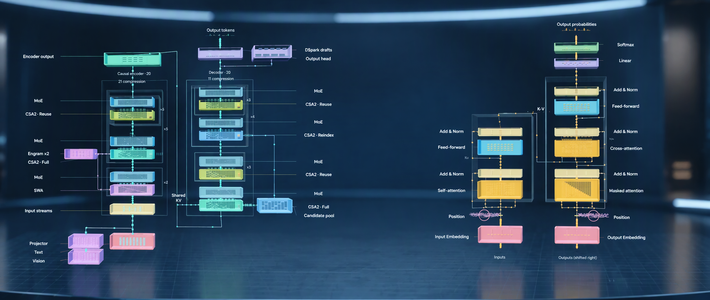
11月5日一早,知乎冒出一条分量极重的消息:DeepSeek V5 将采用华为昇腾950芯片作为核心训练算力。先别急着欢呼——这是"曝",是计划不是战报,而且按爆料里的说法,乌兰察布智算中心还在初期建设,顶级大模型全程放在国产芯片上训练要是做成,那是头一回。但把最近一个多月的时间线摆在一起看,这句话的含金量就完全不一样了。知乎
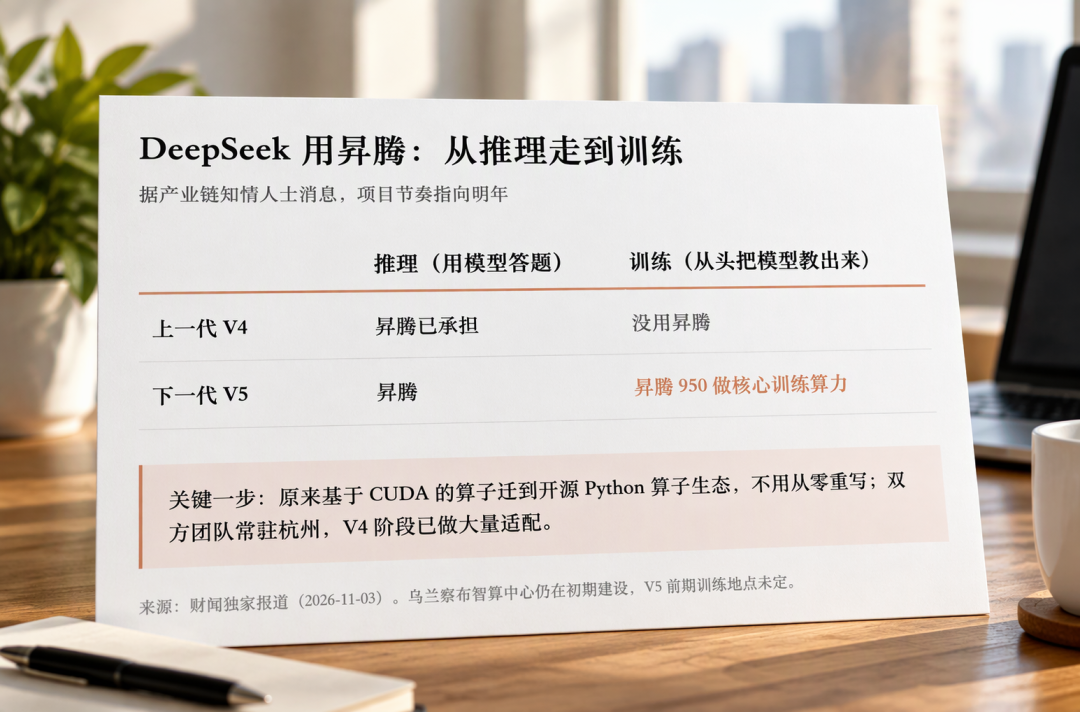
9月30日,DeepSeek官宣开源昇腾基础组件,话题里还写着"华为给予了毫无保留的支持",相关微博拿下786个赞,评论区一句"英伟达、CUDA不可替代?笑话"刷屏。另一边更直白的说法是:所有组件与英伟达一一对应。10月20日,DeepSeek开源大规模云服务推理框架DeepInfer,使用条件里白纸黑字写着英伟达和昇腾两条路,而且现在国内英伟达又贵又缺货,昇腾几乎是现成的另一选项。10月底到11月初**,昇腾950超节点拿下世界互联网大会领先科技奖,它干的事是把1024张NPU通过灵衢互联组织成一套超节点,配合跨物理节点的统一内存编址,让大模型能在这套系统里协同运行。微博微博知乎知乎
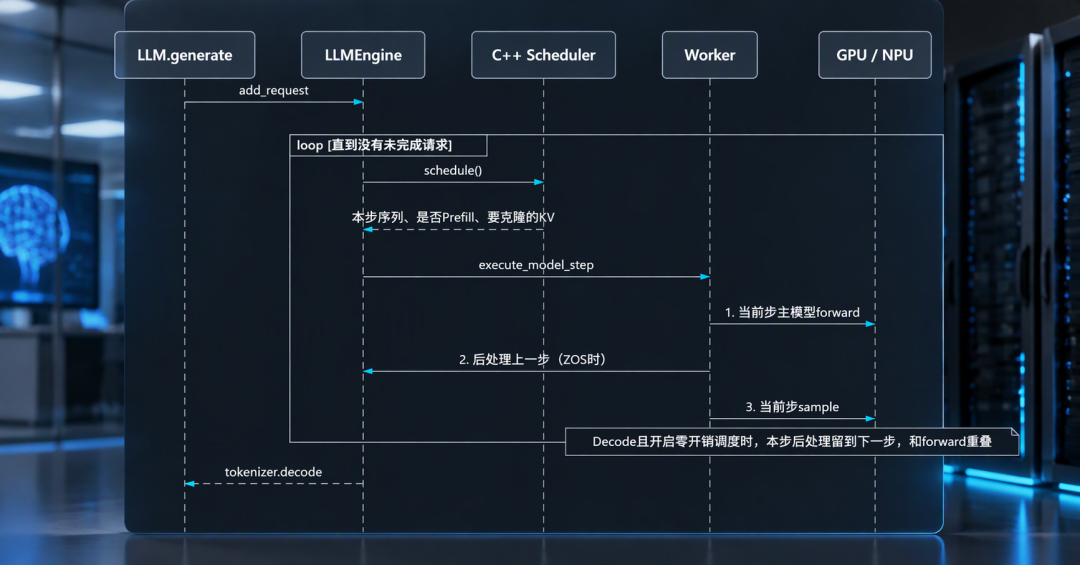
现在,轮到训练了。 为什么训练和推理不是一个量级?有知乎用户说得很直白:推理是坏了删掉重跑、损失顶多几块钱的活儿,训练是成千上万张卡连在一起、要连续跑好几个月,最底下的某个算子算得不稳,几个礼拜的活就可能白忙。顶级大模型全程用国产芯片训练,要是做成,那是头一回。知乎
CUDA的护城河到底是什么?不是别的芯片算不动,而是十几年的代码、优化、肌肉记忆全都围着CUDA写。 一位知乎用户的亲身经历:以前图方便在Mac上跑视频模型,一个镜头要三十四分钟、电脑还被拖死过两次,折腾到头还是回去用英伟达的卡。硬件差距可以追,生态差距得自己趟。知乎
而DeepSeek这次撬石头的方式很"工程师":双方研发团队常驻杭州,从V4阶段就开始逐个适配底层算子,磨了一年多。原本写在CUDA上的算子,已迁到开源的Python算子生态。这条路走通,受益的不光是DeepSeek自己——后面的人有路可照,绕开CUDA不再从头趟雷。知乎
当然,泼冷水的也不少:950的良率和产能受质疑、英伟达Rubin一代压着代差、"用的其实都是英伟达卡"的嘲讽没断过。证据覆盖到哪里,结论就说到哪里:目前坐实的只有"推理上昇腾+工具链开源","训练当主力"还得等V5真正放出来。
对玩GPU并行计算的你们,这事儿其实没那么遥远:
靠CUDA吃饭的人:不是死刑。开源出来的昇腾基础组件就是现成教材,多一个生态就多一份议价权;
调API、跑本地权重的人:DeepSeek一直开源权重,它换什么芯片训练,不妨碍咱们拿到权重后继续用手上的英伟达卡。反过来,训练算力少受出口管制牵制,API价格和供应反而更有盼头;知乎
见证历史的人:国产卡从"能用"到"能当主力",中间差的从来不是发布会,是V5跑完那一刻的效果对比。
护城河的厚度,从来不由一块芯片的TOPS决定,而是由有多少人愿意为它重写每一行代码决定。DeepSeek动手写了,剩下的交给时间。