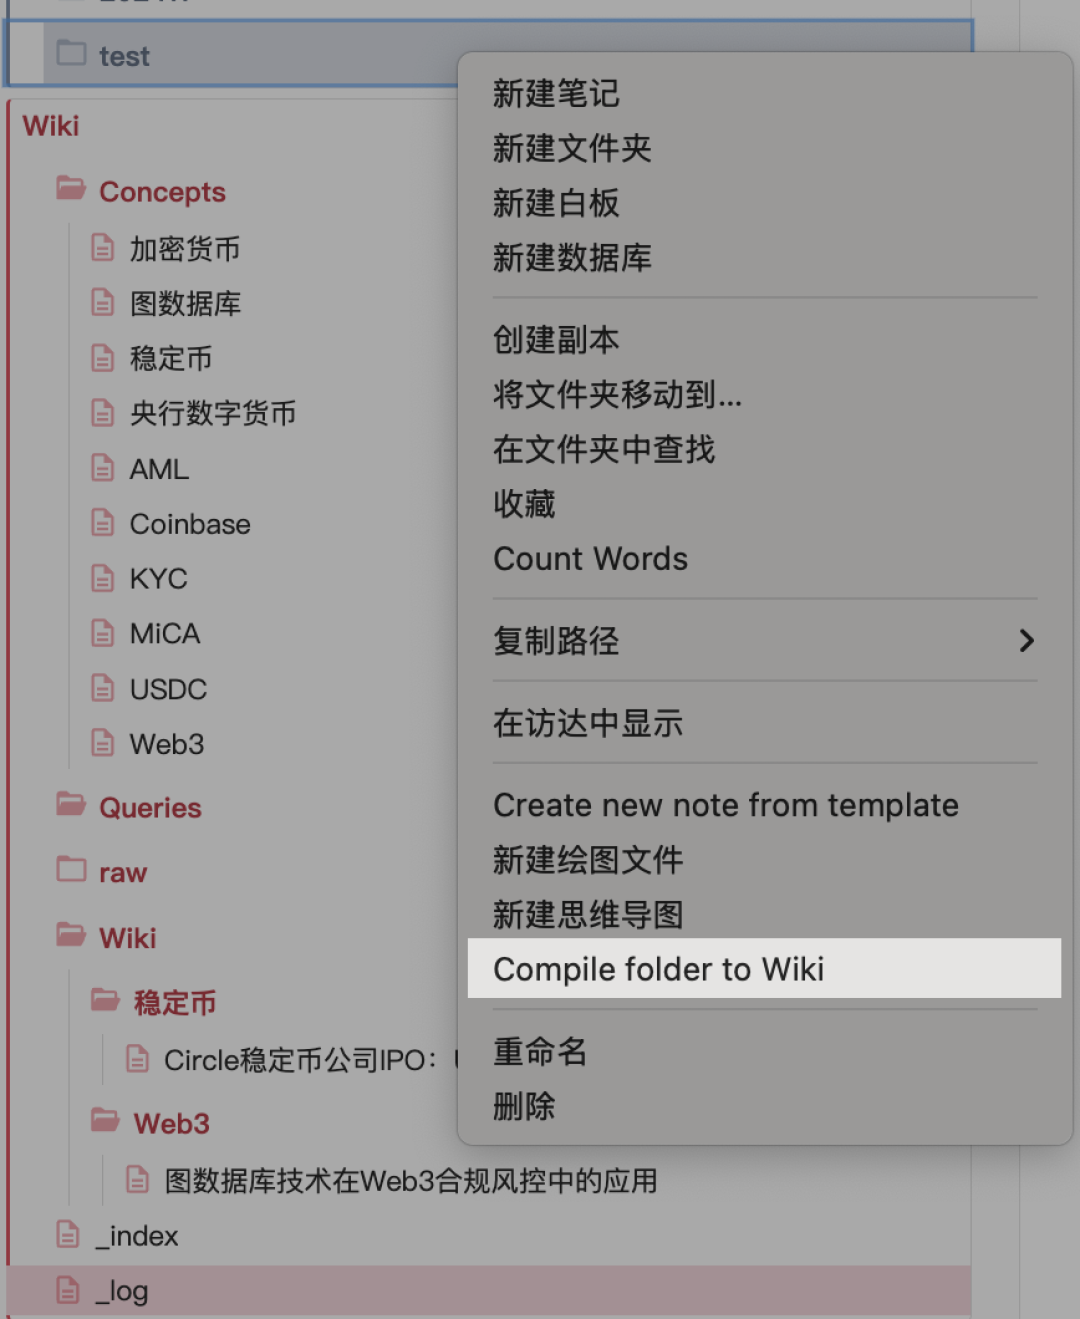
凌晨一点,你右键一个文件夹,选中 Compile folder to Wiki。
过了一会儿,AI 把里面的文章拆成一批概念页,互相链上,写回 Wiki。你合上电脑,觉得这个知识库终于活了。
第二天你问它一个问题,它答得很顺,还带 [1][2] 引用。你没注意到,其中两条结论原本是打架的。
这不是某个插件的 bug。它来自 AI 整理知识的方式本身。要看清这一点,得先回到旧问题:知识库为什么总是死。
维护是一道平方题
几乎每个人都建过知识库,也几乎每个知识库都死过。知识管理圈流传一个数字:82% 的个人知识管理系统会在 6 个月内被放弃。知乎专栏
多数人把这归咎于懒。可它更像一道数学题:每新增一条笔记,理论上都要检查它和此前每一条的关联。
维护成本按平方涨,你能感知到的价值却几乎不涨。两条曲线在 500 到 2000 条笔记之间交叉。过了这个点,你不是在用知识库,是在给它打工。知乎专栏
卢曼是少见的反例。43 年,9 万张卡片,70 本书。但他每天写 6 张卡片,翻旧卡、找位置、建引用,几乎占掉一整天。知乎专栏
他没有消灭维护,只是把维护变成了全职工作。这办法普通人学不来。
AI 把矛盾写顺了
今年 4 月,Karpathy 提了另一条路:别每次提问都从原始资料重新检索,而是让 AI 把资料编译成一个持续维护的 Wiki。
原始资料层不动,AI 在上头写互相链接的 Markdown 页面,再加一份 Schema 规定怎么分类、怎么输出。知乎知乎
每进一篇新资料,更新十几张旧页面。知识不是堆积,是编织。知乎
这也是 Markdown 在 AI 知识库里吃香的原因:结构干净,模型不用跟排版较劲。知乎
这份只讲思路的 Gist 拿了 5000 多 star,评论区长出 20 多个衍生项目。知乎
看起来,维护终于可以外包了。但外包出去的不只是劳动。
你给它两条打架的笔记:一条说间隔重复有效,一条说复杂理解上没用。人可能老老实实写“存在争议”,模型更可能写成“这是一种有效的学习策略,尤其适用于简单记忆任务,在复杂概念理解上效果有限”。知乎专栏
争议变成了限定条件,读起来顺多了。
可知识库需要的不是连贯,是准确。一个过度连贯的知识库比一个充满矛盾的知识库更危险。矛盾至少让你停下来,通顺让你直接往下走。下面这张图里的回答就是这样:结构完整,引用齐全,读不出它绕过了什么。知乎专栏
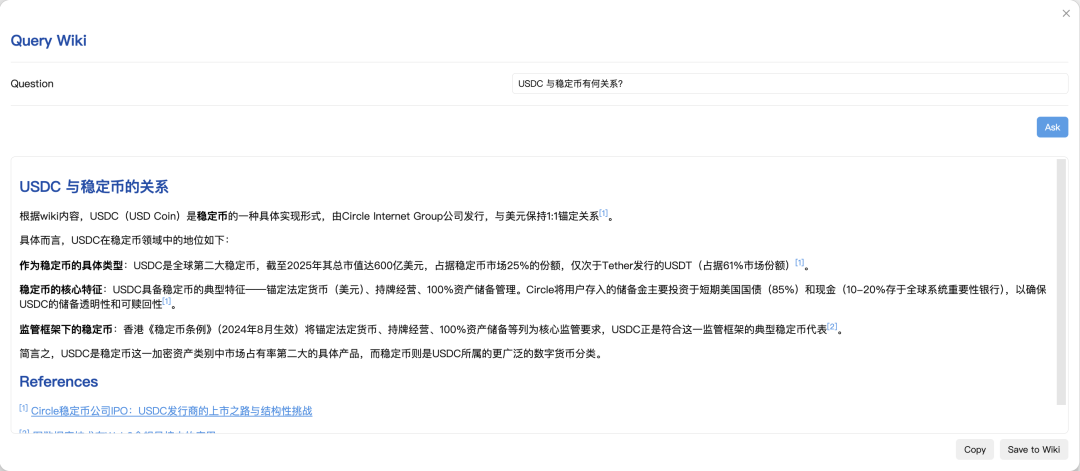
更麻烦的是自我强化。模型周一写进一个错误结论,周三的 Lint 再让同一个模型检查,它倾向于认为自己的输出内部一致,于是放行。知乎专栏
错误就这样拿到了“已检查”的标签。
Obsidian 联合创始人 Steph Ango 的建议很直接:把 AI 生成的内容放进单独的 vault,跟原始笔记隔开。这等于承认,AI 产出的是潜在污染源。知乎专栏
把围栏先立起来
第一条,原文不动。Raw Sources 层不可变,AI 写的东西全在下游。Wiki 说“某方法有效”时,你得能一路退回那句话最初来自哪篇文章、哪次实验。
第二条,分类收紧。一个 Obsidian 插件作者试过把分类完全交给模型,同一个主题被分进“加密货币”“区块链”“数字资产”三个目录。知乎
后来他改成预定义列表,模型只能选,选不到就进兜底类。Schema 不是建议,是围栏。
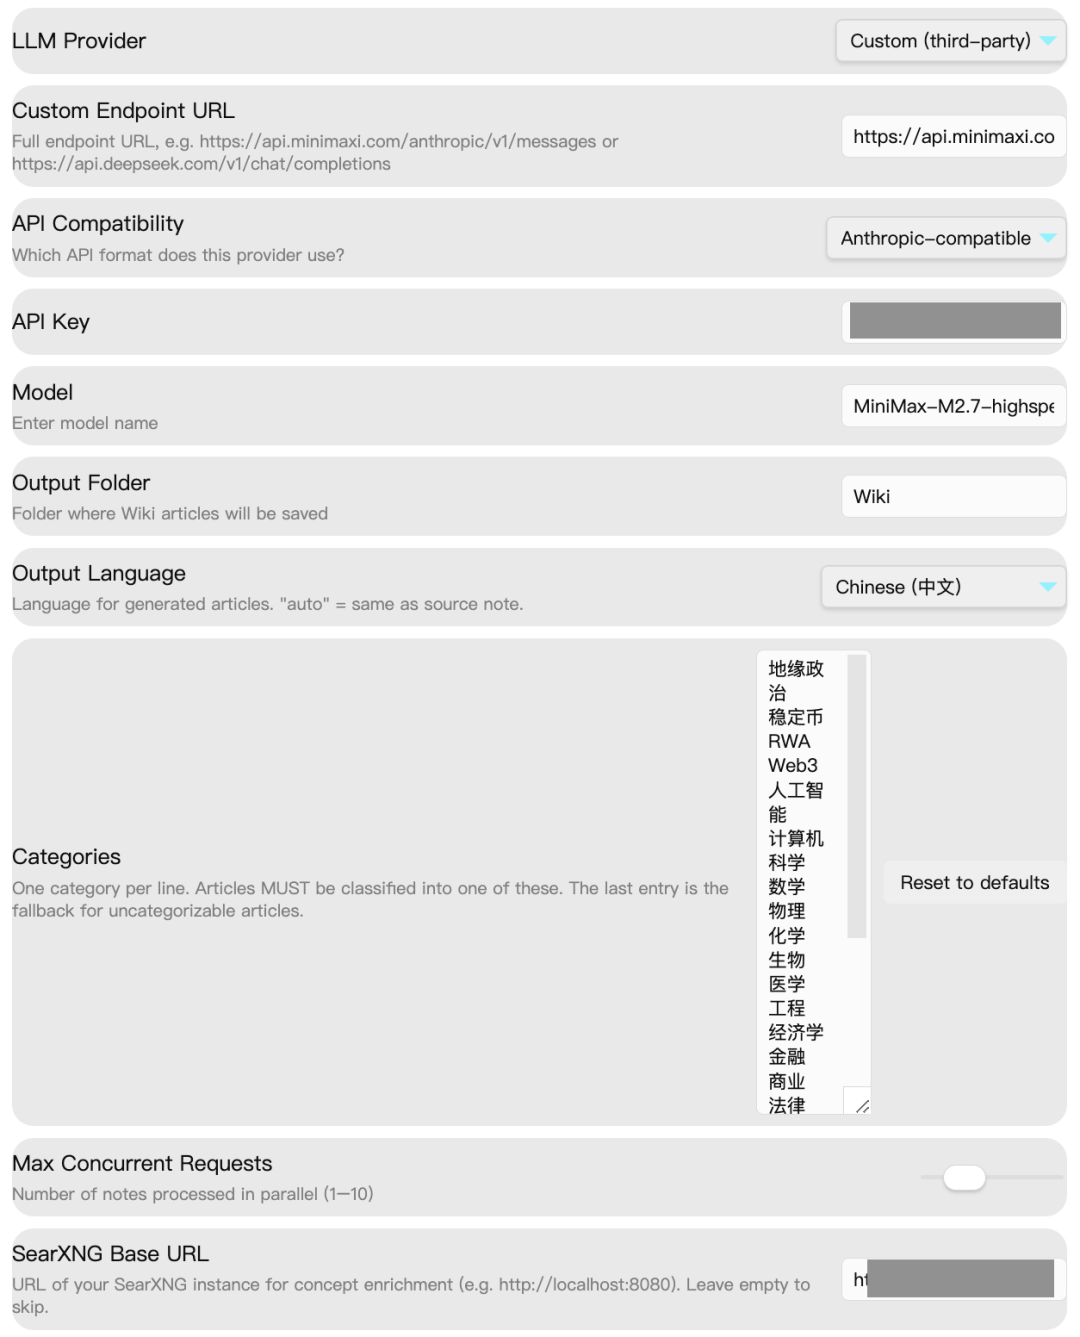
第三条,Lint 查矛盾,不查文笔。该看的是哪些页面互相打架、哪些三个月没更新、哪些是没人链接的孤儿页。
有插件会把巡检结果写成一份报告,列出矛盾内容、孤立页面和过时信息。不好看,但比漂亮的摘要有用。知乎
还有个土办法:所有 AI 写入都放进 Git,每次自动 commit。模型把两个文件写串了,git reset 就能回去。知乎
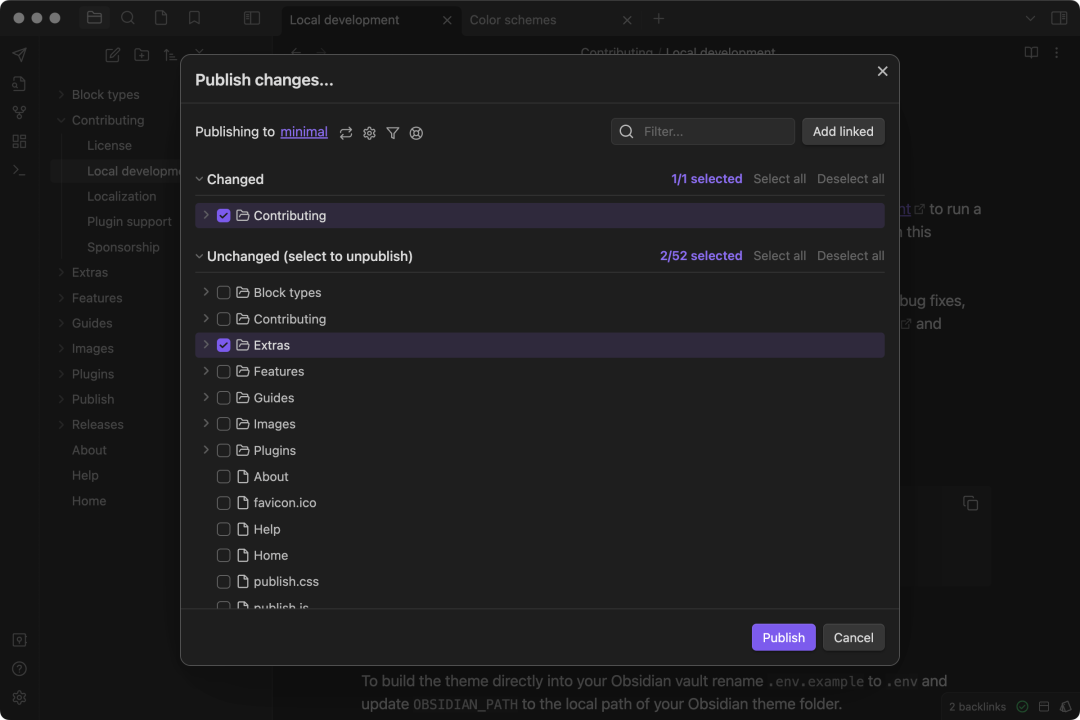
发布前也一样,先看 diff:哪些改了一处,哪些五十多条没动,选中了才发。
别数笔记,也别看图谱多漂亮。看它有没有改变你的动作。
有人用它记项目流水账。写周报时让 Agent 读一周记录出初稿,五分钟搞定原来一两个小时的活。知乎
场景不高级,但它是活的:知识被调用,变成一份要交出去的东西。
反过来说,如果一个知识库今年只增加过收藏,没帮你做过一个决定、改过一版方案、写过一段东西,那它再整齐,也只是被妥善保存的遗体。
AI 可以替你整理,不能替你判断什么值得留下。这条线得自己划。