传统箱线图和小提琴图各有局限,云雨图巧妙融合了数据分布、原始观测点和统计摘要三大要素,成为科研论文中的高级可视化利器。这份完整教程带你从零开始掌握R语言绘制云雨图的完整流程,让你的数据分析结果以惊艳方式呈现。
 智能速览
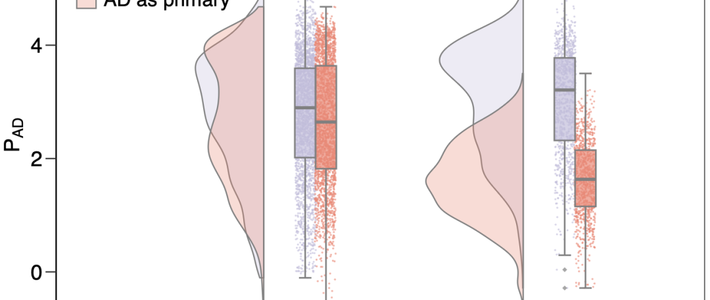
云雨图结合半小提琴图、箱线图和散点图三重信息
提供完整R代码实现,包含逐行详细注释
从数据导入到出版级图形输出的全流程指南
内置统计分析功能,自动添加显著性标记
专业配色方案和细节调整技巧
适合展示小到中等样本量的组间比较数据
 精华内容
云雨图之所以能在科研界迅速流行,源于它完美解决了传统可视化方法的痛点:既保留了数据的完整分布特征,又提供了清晰的统计摘要,还能展示每个原始数据点。
云雨图原理
云雨图得名于其独特的视觉构成:左侧半小提琴图像云一样展示数据概率密度分布,右侧散点如雨滴般落下代表每个原始数据点。这种可视化方法由心理学期刊率先推广,特别适合行为科学研究中展示个体差异和整体分布。
相比传统方法,云雨图具有三大优势:透明度展示所有原始数据点,避免黑箱操作;完整性同时呈现分布、摘要和个体数据;美观性视觉层次丰富,易于理解。当样本量适中时效果最佳,过大时可通过调整透明度优化显示效果。
环境配置
绘制云雨图需要加载四个核心R包:tidyverse提供数据处理和可视化框架,readxl专门处理Excel数据导入,gghalves用于创建半边图形效果,rstatix简化统计检验流程。这些包的组合构建了完整的可视化工具链。
代码示例:
library(tidyverse)
library(readxl)
library(gghalves)
library(rstatix)
每个包都有明确分工,协同工作实现从数据到图形的完整转换。
数据准备
云雨图要求使用长格式数据,包含分组变量和数值变量。示例数据包含三列:group(实验分组)、treat(处理条件)和value(测量值)。这种结构便于ggplot2进行分组比较和映射。
关键步骤:
data <- read_xlsx(“data_0116.xlsx”)
数据导入后,需要将字符变量转换为因子并指定显示顺序,确保图形按逻辑顺序而非字母顺序排列。
统计分析
在绘图前需要进行统计检验确定组间差异显著性。使用rstatix包可以轻松实现:
stat_test <- data %>%
group_by(group) %>%
t_test(value ~ treat) %>%
add_significance(p.col = “p”) %>%
add_xy_position(x = “group”, dodge = 0.8)
这段代码按实验分组拆分数据,对每组内不同处理条件进行t检验,自动添加显著性星号标记(*, **, ***)并计算标记位置。
图形绘制
云雨图由四个层次组成:第一层geom_half_violin绘制左侧半小提琴图,设置position_nudge向左偏移0.2;第二层geom_point添加抖点图,避免数据重叠;第三层geom_boxplot绘制箱线图,显示五数概括;第四层stat_pvalue_manual添加显著性标记。
每层都有精确定位:半小提琴图在左侧,散点和箱线图居中,显著性标记在顶部。通过position参数精确控制各元素位置,确保视觉层次清晰。
美化输出
专业配色采用淡紫色(‘#c1bddc’)和珊瑚粉(‘#f88172’),既美观又满足色盲友好。主题设置使用theme_bw()配合自定义调整:去除网格线减少干扰,设置坐标轴字体大小为17,图例置于左上角。
最终保存为PDF格式确保矢量质量:
ggsave(“diff_raincloud_2.pdf”, width = 8, height = 5)
PDF格式可无限放大而不失真,适合学术出版要求。
云雨图作为科研可视化的新兴利器,完美平衡了信息完整性和视觉美观性。掌握这一技能,不仅能提升论文图表质量,更能让数据分析结果更具说服力。随着数据可视化在科研中的重要性日益凸显,云雨图值得每个研究人员掌握和运用。