






89
27
Super-agent 跑到第十步就乱
2026-11-03 22:18:26
0点赞
0收藏
0评论
“跑到第十步就乱”通常不是模型突然变笨,而是上下文里几类内容的挤占关系发生了变化。要判断是历史太长还是工具结果塞得太多,先把上下文占用拆成三块分别计量:系统提示、对话历史、工具结果(含工具调用参数)。只看总 token 数没有意义,因为三条曲线的增长斜率不同——历史按轮数线性增长,工具结果则是脉冲式增长,某一步一个接口返回一大段 JSON 就能顶掉前面十几轮的信息。先做一次分段统计,再决定压哪一块,是成本最低的排查顺序。
建议先把单次运行的上下文按系统提示、对话历史、工具结果三类分别计数,确认大头在哪;再核对截断策略是按轮数、按长度还是按消息类型生效,看关键信息是否最先被丢。工具结果入上下文前做摘要化,保留状态、关键值与错误类型,压缩掉冗余正文。设置占用阈值并记录触发次数,用两次运行的占用曲线对照失败步骤位置,只记录现象,是否因果需结合环境确认。
拆开统计上下文占用:系统提示、历史、工具结果各占多少
统计的目标不是算准模型侧的 token 数,而是拿到可复算的三段占比。建议用一个通用分词器(例如 tiktoken 一类的本地分词库,或直接按字符数近似)对最终发给模型的 messages 数组逐条计数,并按 role 和是否为工具结果打标签。脚本里的分词函数是唯一替换项,换成你实际使用的模型对应分词器即可。
# 按消息分类统计占用,输出三段占比
import json, collections
try:
    import tiktoken
    enc = tiktoken.get_encoding("cl100k_base")
    count = lambda s: len(enc.encode(s))
except ImportError:
    count = lambda s: len(s)  # 退化:按字符数近似,仅供横向对比

def classify(msg):
    if msg.get("role") == "system":
        return "system_prompt"
    if msg.get("role") in ("tool", "function"):
        return "tool_result"
    content = msg.get("content") or ""
    if isinstance(content, list):
        content = json.dumps(content, ensure_ascii=False)
    return "history"

msgs = json.load(open("messages_dump.json"))
bucket = collections.Counter()
for m in msgs:
    c = m.get("content") or ""
    if isinstance(c, list):
        c = json.dumps(c, ensure_ascii=False)
    bucket[classify(m)] += count(c)

total = sum(bucket.values()) or 1
for k in ("system_prompt", "history", "tool_result"):
    print(f"{k:15s} {bucket[k]:>7d}  {bucket[k]/total:.1%}")
print("total", total)
跑之前把每次请求的真实报文落盘成 messages_dump.json,这是后续所有复算的基准。验证方式:把脚本输出的总数与网关或客户端日志里记录的 prompt tokens 对照,差异通常来自分词器不一致和消息框架开销;只要差异稳定,占比结论就可以用。如果 tool_result 占比在后期步骤明显抬升,优先怀疑工具结果塞得太满。
确认截断策略是按轮数、按长度还是按消息类型
占用高本身不致命,致命的是“谁先被丢”。多数框架的默认行为是保留 system、从最早的历史消息开始丢弃,但这依赖具体配置,需要你去看实际生效的规则。检查清单按顺序过:
① 找到上下文管理代码或配置项,确认是基于消息条数(max_turns)、基于 token 长度(max_tokens)还是基于消息类型白名单;
② 确认工具结果是否被整条丢弃,还是只截断内容字段;
③ 确认最新一条用户指令是否被强保护;
④ 确认截断发生在拼装前还是请求失败后重试时。
一次触发截断时的日志证据通常长这样,重点看被丢弃的消息 role 和长度,而不是只看条数:
[ctx] before=24 msgs / 41820 tok
[ctx] policy=max_tokens limit=32768 strategy=drop_oldest
[ctx] dropped msg#3 role=tool len=6120 reason=oldest
[ctx] dropped msg#4 role=tool len=4880 reason=oldest
[ctx] after=22 msgs / 30820 tok
[ctx] warning: first_user_instruction dropped=false
[ctx] warning: tool_result_ratio=0.61
如果日志显示被丢的是一整段工具结果,而模型后面还在引用其中字段,跑偏就很可能从这一刻开始。反过来,如果历史按轮数被砍、最早期用户约束消失,问题会表现为“忘了最初的任务边界”。这两种走偏的症状不同,需要结合日志确认,不要凭感觉归因。
把工具结果摘要后再入上下文,保留哪些字段
工具结果原文进上下文的性价比很低:结构化数据里真正被后续推理用到的,通常只有状态、主键、关键数值和错误类型。建议在工具调用返回后加一层摘要函数,把大字段压缩成短文本再写入 messages,原文另存到文件或键值存储,并保留一个可回查的引用 ID。
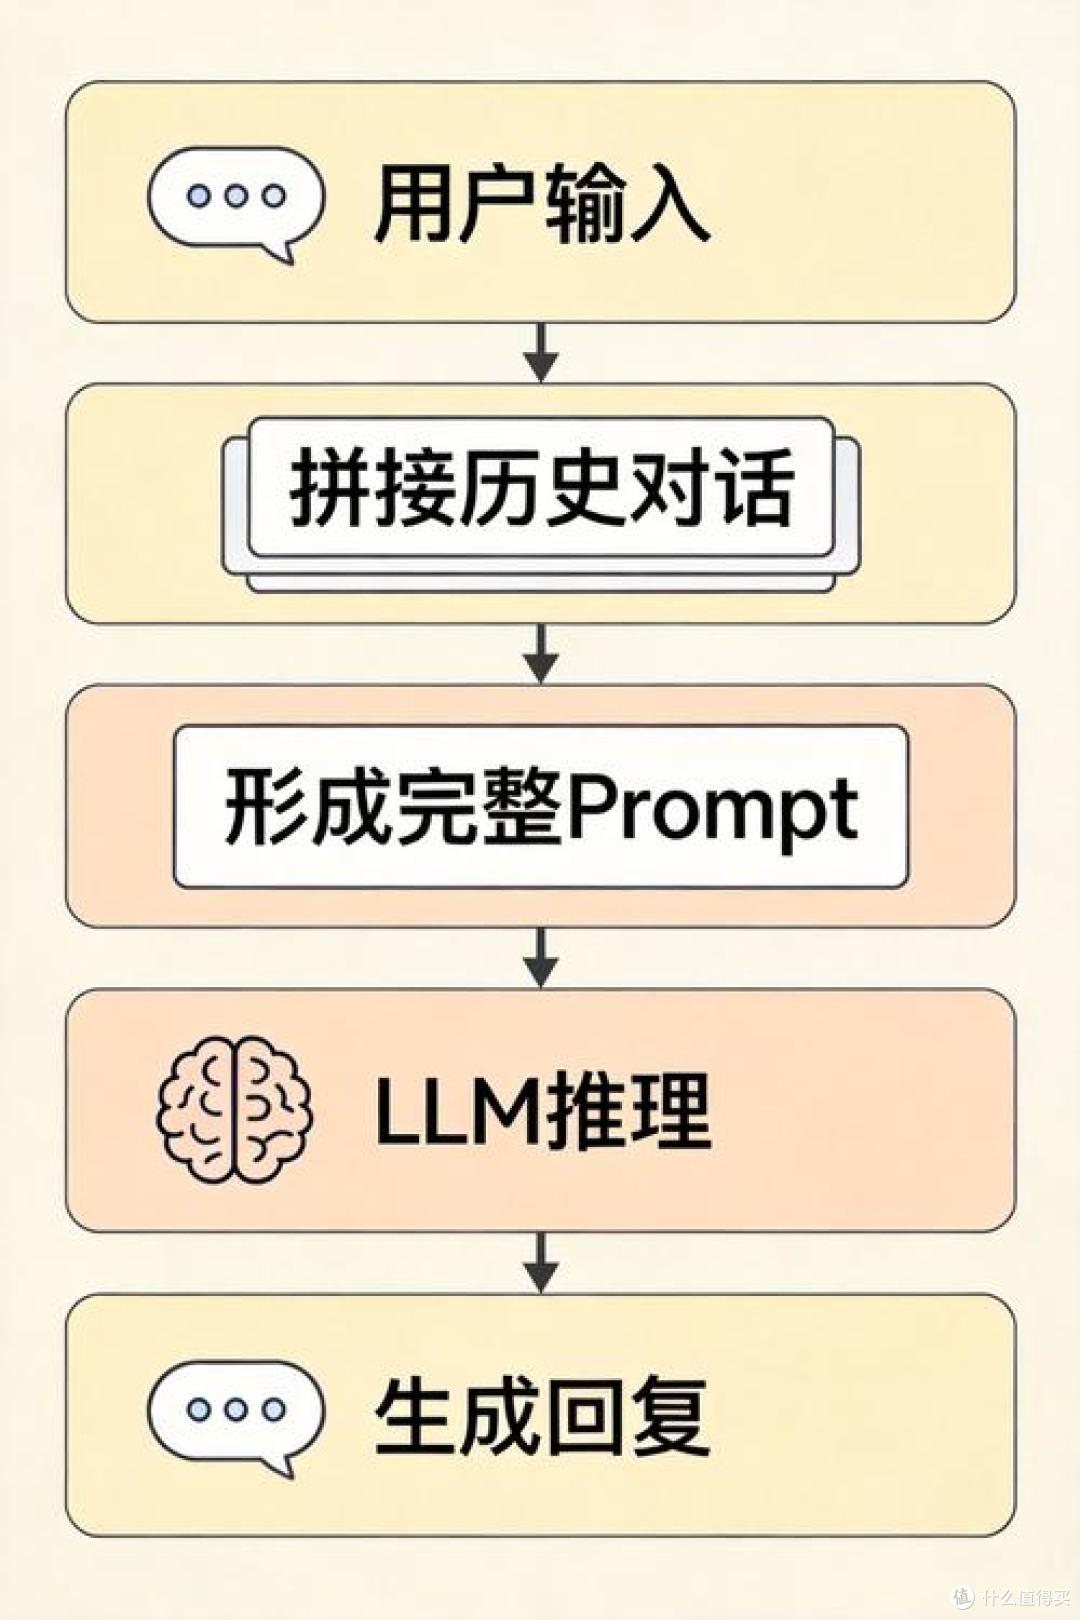 Super-agent 跑到第十步就乱——是历史太长还是工具结果塞得太多?
字段类别处理方式理由状态码 / success 标志保留决定下一步是否重试或换路径错误类型与错误消息首行保留区分可重试错误与参数错误主键、ID、URL保留后续步骤常需引用关键数值与单位保留,最多前 N 条影响判断,但通常只需头部样本完整列表 / 大段正文 / HTML压缩为条数与摘要占用大、复用率低重复字段、嵌套元数据丢弃不参与推理时间戳、分页游标视是否需要翻页决定无翻页需求时价值低
def summarize_tool_result(raw: dict, keep_n: int = 3) -> str:
    return json.dumps({
        "ok": raw.get("ok"),
        "error_type": raw.get("error_type"),
        "error_msg": (raw.get("error_msg") or "")[:120],
        "ids": [x.get("id") for x in raw.get("items", [])[:keep_n]],
        "count": len(raw.get("items", [])),
        "ref": raw.get("ref"),  # 原文回查句柄
    }, ensure_ascii=False)
风险边界要说清楚:摘要会丢失细节,凡是被模型用来精确定位(如按某个字段逐条比对)的场景,需要把该字段保留或提供回查工具,否则会把“占用问题”换成“信息不足问题”。摘要规则上线后,用上一次失败的同一任务复跑,对比是否还在同一步失去关键上下文。
设一个占用上限并记录触发次数
把“跑太长”变成可观测事件,做法是设一个阈值(例如占总窗口的一定比例,具体比例需结合所用模型窗口和任务长度确认),在拼装请求前判断,超限时打日志而不是静默截断。触发点建议放在上下文管理模块的唯一出口处,避免多处判断互相覆盖。
CTX_LIMIT = 28000  # 通用示例值,按模型窗口调整
used = count_context(messages)
if used > CTX_LIMIT:
    logger.warning("[ctx] threshold_hit used=%d limit=%d step=%d tools=%d",
                   used, CTX_LIMIT, step_idx, tool_msg_count)
    messages = compress_and_trim(messages, target=CTX_LIMIT)
一次触发记录大致如下,重点是可回查:哪一步、哪类消息占比最高、触发了多少次。
[ctx] threshold_hit used=29140 limit=28000 step=9 tools=7
[ctx] breakdown system=1400 history=9800 tool_result=17840
[ctx] trimmed 2 tool msgs, after=26310
[ctx] threshold_hit used=28420 limit=28000 step=11 tools=9
观察触发次数与失败步骤是否重合:如果每轮都触发、且触发点集中在第 8 至第 11 步,说明任务后期上下文已持续处于压缩状态,模型看到的输入被动变形。这是可观测现象,不等于已证明因果,需要下一步对照实验确认。
对照两次运行,看失败位置是否随占用前移
控制变量做一次 A/B:同一任务、同一工具集,只改一项——比如给工具结果加摘要,或调低/调高占用阈值。记录每次调用的累计占用和当步是否出错,绘制成简单的步骤对照表即可,无需复杂工具。
step | run_A ctx_tok | run_A ok | run_B ctx_tok | run_B ok
  1  |     3200     |   Y     |     3100     |   Y
  5  |    14800     |   Y     |    11200     |   Y
  8  |    23600     |   Y     |    15400     |   Y
 10  |    28900     |   N     |    19100     |   Y
 11  |    31200     |   N     |    20800     |   N
需要记录的现象有三条:失败首次出现的那一步编号;该步之前是否触发阈值或截断;两次运行失败位置是否随占用抬升而前移或后移。如果 run_B 的失败步从第 10 步挪到第 11 步且占用更低,只能说明“压缩与失败位置存在同步变化”,仍不能排除任务本身在该步进入更难的分支。建议至少重复两三次并换一个任务形态再观察,避免把单次巧合当成规律。