11月3日,《科创板日报》从多名产业链人士处得到消息:DeepSeek 下一代大模型 V5 计划基于昇腾芯片做预训练。 另一路报道把芯片指向昇腾 950,时间指向明年,确切时间取决于训练进度。截至发稿,双方都没有公开确认。财联社
消息里最容易被记住的是另一句:过去基于 CUDA 开发的算子链路已经迁到开源 Python 算子生态,不用从零重写整套底层代码。 传着传着,就变成了“不用重写 CUDA 代码”。经理人杂志
这句被压缩过的话,只对了一半。对的那一半,是 DeepSeek 确实不用再为昇腾从零重写一遍模型底层。错的那一半,是它并不说明 CUDA 代码可以原样跑在昇腾上。TileLang 不是 CUDA 翻译器;它更像一种用 Python 写的算子描述语言:同一段算子代码,换一个编译目标,就能分别生成 CUDA C 和 Ascend C。 能复用的前提,是你一开始就写在 TileLang 里。DeepSeek 在 V4 阶段已经把大部分训练算子搬到了这一层,所以到昇腾时,换的是编译目标,不是把 CUDA 源码逐行翻译过去。知乎
真正的迁移成本,也没有消失。TileLang 把“重写算子”降成了“补后端调度”,但补调度仍要一项项做:矩阵核和向量核怎么分工,数据在片外内存、片上缓存和寄存器之间怎么搬,行主序的布局怎么转成矩阵单元要的分形格式,搬运和计算怎么排成流水。在 GPU 上,这些多由硬件缓存和统一共享内存代劳;到了昇腾,每一步都要在软件里显式决定。裸写 Ascend C 比写 CUDA 难,难就难在这些地方;TileLang 的自动调度把大部分活接了过去,难度才回到接近 CUDA 的水平。
DeepSeek 说,训练中用到的每一个 TileLang 算子,在昇腾上都有对应的高性能实现。 这句话的分量在于“每一个”,不在于“不用写”。机器之心
V4 那一代的代码关过了,后面才是硬仗。昇腾 950DT 的账面规格是 144GB 片上内存、4TB/s 带宽,8 位精度算力约 1 PFLOPS。内存不小,带宽也不弱,短板在算力密度:这个数字是英伟达 B200 的两成多。 同等模型、同等工期,卡数就要堆到四到五倍。这个差距不会因为软件栈开源而消失,它直接把问题从“能不能跑”变成了“能不能堆出一座更大的集群”。36氪
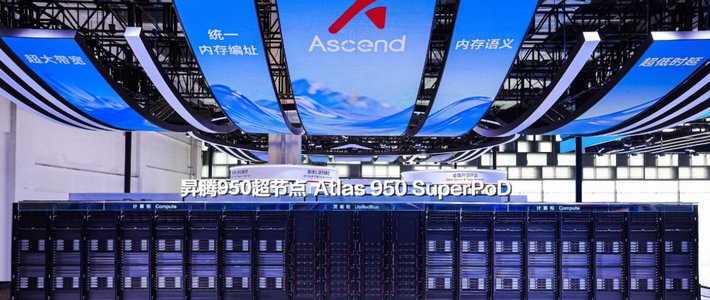
昇腾的应对是把单卡问题变成系统问题。950 超节点目前把 1024 张 NPU 连成一个域,提供 256TB 的统一内存地址空间,跨节点访问的往返延迟约 3 微秒。 在这个域里,1024 张卡在软件上更像一台机器。可一场前沿预训练不是一个域就能装下的:卡数翻到四到五倍,就得跨多个超节点。域内的统一编址和低时延,到了域间要重新面对光模块、交换机和网络协议。超节点把最难的一段路修平了,但没有把整条路修完。知乎
通信是下一个关口。DeepSeek 为昇腾写的 DeepEP,在 128 卡全互联的 UBL128 方案上,Dispatch 带宽 375 GB/s,Combine 347 GB/s,官方说接近硬件上限。 这个数字很漂亮,但它测的是一组条件受控的通信算子。真实训练里,MoE 的专家路由是动态的,热点专家会被挤爆,冷门专家闲着;专家之间的全交换流量忽大忽小,还要和计算抢时间。测试用例接近上限,不等于万卡集群里的有效带宽接近上限。机器之心
最后是最不性感、也最要命的一关:稳定性。Meta 训练 Llama 3.1 405B 时,1.6 万张 H100 平均约 3 小时中断一次,靠快速恢复把有效训练时间维持在九成左右。 按同样故障率外推,10 万张卡大约半小时就会断一次。到了几万卡,还可能遇到比特翻转这类静默错误:数值看着正常,其实已经算错。预训练一跑几个月,任何一张卡、任何一条链路、任何一次未发现的数值异常,都可能让最后一段训练作废,甚至要回滚到更早的检查点。36氪
国内并不是没有跑通过。美团官方称,LongCat-2.0 已经在五万卡国产集群上完成 1.6 万亿参数 MoE 的从零预训练,并披露 30T+ tokens、全程无回滚,训练耗时月余;第三方按公开指标估算,MFU 约两成。 这说明国产集群能撑住一次万亿级预训练。但 LongCat 用的不是 950,而是上一代国产芯片;V5 要上的 950 是新一代平台,软件栈、互联和集群管理都要重新磨合。V5 还要在更大的集群上跑,两成的 MFU 说明效率还有一段路要走。知乎
算子这一关主要是软件问题,卡数、通信、稳定性都要在集群里解决。DeepSeek 的开源把算子关的难度降了不少;但单卡差距要靠卡数补,卡数一多,通信和稳定性就会跟着恶化。这三件事是连着的:算力越不够,越要堆卡;卡越多,网络越难,故障越密。没有哪一项能靠一次开源解决。
如果 V5 真的在昇腾上跑完预训练,它的意义不会是“CUDA 被替代了”。更准确的说法是:DeepSeek 第一次把旗舰模型的预训练,放到国产芯片上跑完。这个里程碑不写在“不用重写代码”里,而写在连续几个月的有效算力利用率(MFU)曲线里。代码只是入场券,考试在集群里。