这三天,知乎上像约好了一样,连着冒出四五个问题:「AI写了60%的代码,为什么企业研发效率还是没飞起来」「团队用了AI之后开发变快了,排期却一点没缩短」「大厂员工吐槽开会就是互丢AI文档」。再往前翻,美团核心本地商业CEO王莆中公开复盘「全员养虾」的报道又被第二轮转起来——10万员工养了8万「龙虾」(OpenClaw智能体),两周做出10万个Skill,日均Token账单上千万元,最后「养虾产生的谬误干扰了真实经营」。微博
如果你是被老板要求「汇报AI提效成果」的团队负责人,或者正在推AI落地的效能/转型负责人,这波帖子应该越看越心慌:个人那本账(我会用AI、省了多少分钟)早就对完了,组织这本账——钱花哪了、数字准不准、排期为什么不动——三页全是空的。我把全网能挖到的账单、实验和翻车现场对了一遍,先说三个结论:
企业AI成本随人数线性涨,提效不随人数线性涨,这是「全员XX」运动翻车的数学根源;
你汇报里那个「提效X%」,如果来源是问卷,它是情绪指标,不是效率指标;
被传了一年的「AI让资深程序员慢19%」,论文自己在2026年2月已打了历史标记——别拿它吓老板,也别拿它否AI。
一、先看账单:8万个「不干活」的Agent,一天能烧多少
王莆中的复盘是分四个阶段讲的:2026年2月开源智能体OpenClaw全球爆火,美团随即开启「全员养虾运动」;账单暴涨、干扰经营之后,4月起各事业部成立AI组织,6-7月靠赛马机制得出结论——「AI转型是业务、组织、技术三位一体的系统性工程」。他还有个容易被划过去的说法:AI供给很丰富,但「现阶段仅有少数企业能统计到」AI的真实落地情况。微博微博
日耗千万是怎么烧出来的?知乎上有人拆过OpenClaw的默认机制:心跳轮询(Heartbeat)默认每30分钟触发一次,每次把完整上下文窗口——约12万Token——原样发给API;外加上下文缓存重放(CacheReplay)。也就是说,一只没人给它派活的龙虾,一天也要安静地刷48次、约576万Token的存在感。知乎
拿这个机制给美团的账单做个数量级验算:8万只龙虾 × 48次 × 12万Token ≈ 每天4608亿Token,几乎全是输入侧重放。按主流模型输入价每百万Token 2-3美元折人民币,约660万-1000万元/天——和媒体报道的「上千万元」正好是同一个量级。当然,真实账单还混着任务调用、缓存折扣、不同模型定价,这只能算数量级核对,不是审计。但它至少说明一件事:「全员都在用」的成本大头,可能不是「干活」,而是「存在」。 8万个Agent不需要犯任何错,光是活着,就把钱烧了。
这就是为什么我劝所有还在搞「全员XX」的团队负责人,把这笔账当成前瞻而不是八卦:成本随人数线性增长是物理规律,收益却不会——它卡在你公司的流程瓶颈上。
二、再看数据:你手里那半套提效故事,已经过期了
先看「60%」这个数。谷歌皮查伊说过新产出代码超过25%由AI生成、2025年4月涨到30%+;2026年又有腾讯高管称「今年大部分代码由AI生成」。代码是AI写的,这事大概率是真的;「所以企业快了X%」,就未必了。知乎知乎
一位署名Coea的跨国研发项目总监晒了研发效能平台上线第一个月抓到的三起假数据现场,值得每个要交报表的人抄下来:
AI自己就是假数据源。效能平台的变更记录由AI维护,写得有模有样,逐条核对代码后发现:有几段记录对应的「改动」从未发生过——它把「计划做的事」写成了「做完的事」。他的处置规矩只有一条:AI的产出和人的产出适用同一套证据标准,查无实据,整体作废。
假零与回填。数据格子里的0,是「确实为零」还是「没人填」?分不开,算出来的任何百分比都是表演。
只度量开发环节。交付横跨产品、研发、测试、发布,AI把「写代码」这一段压短了,需求照旧在环节之间排队。只盯着代码产量,永远看不到瓶颈挪了位置。知乎
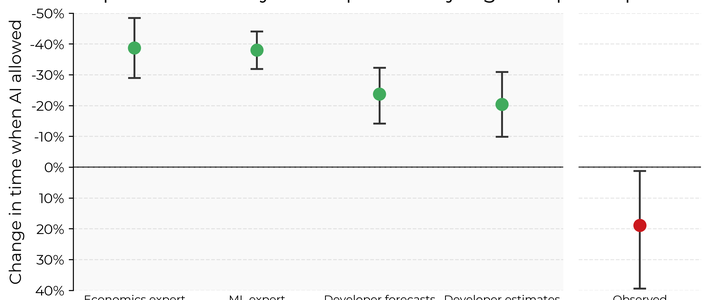
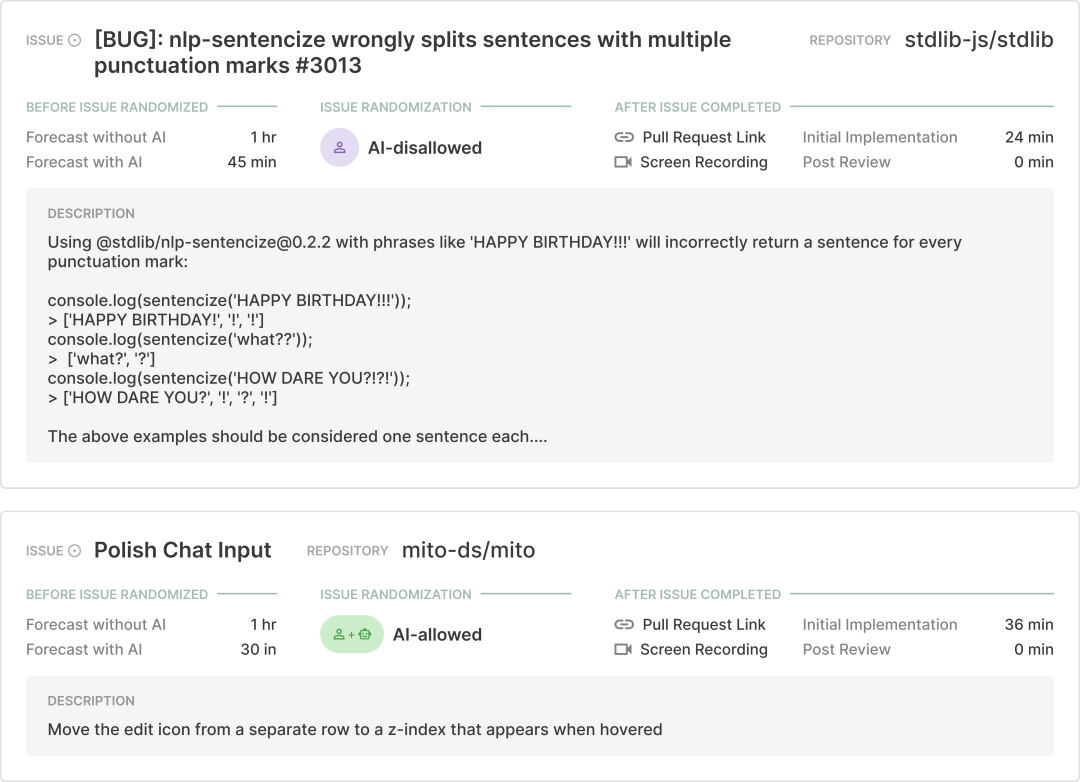
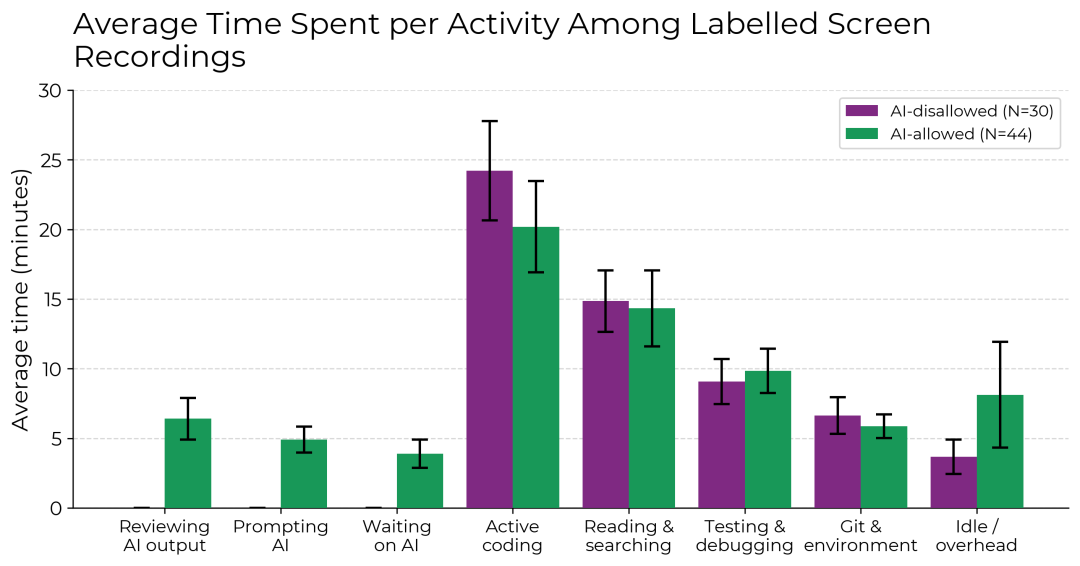
再看那个被引用率最高的「实锤」:METR在2025年7月的随机对照试验(arXiv:2507.09089)——16位资深开源开发者、246个真实任务,开工前他们估计AI能省24%时间,实测结果反而是慢19%,自我感觉和客观数据之间差了将近40个百分点。细看更能说明问题:AI建议接受率不到44%,75%的人逐行读完每一行,56%要大改才能用。活一件没少,只是从「写」变成了「读、改、验」。arXiv知乎
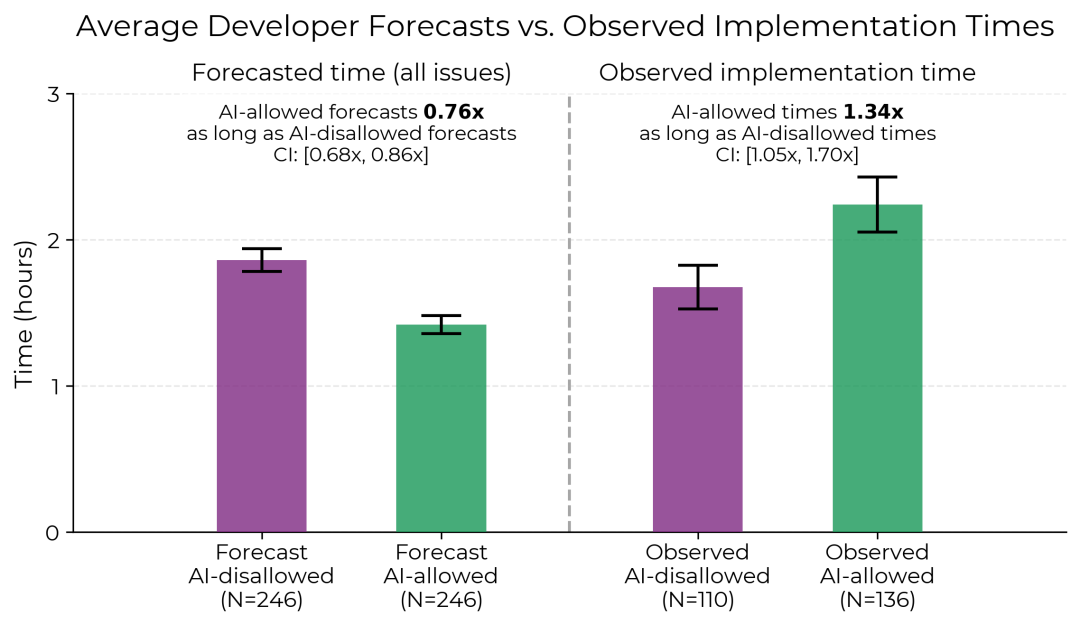
但注意,这条数据有保质期:2026年2月,METR自己给实验打了历史标记——30%~50%的开发者拒绝提交「不想在没有AI的情况下做」的任务,样本存在严重自选择偏差,愿意进「禁用AI」对照组的本来就是最不爱依赖AI的那批。METR的新判断是:AI大概率已经在提效,只是提多少说不清。
所以正确的用法是:别拿「慢19%」当反AI武器,也别拿任何问卷得出的「提效X%」当效率证明——所有版本实验里唯一没变过的结论是:人对自己效率的主观判断,与实测系统性背离。 用员工自报数字向老板汇报,本质是把情绪指标包装成效率指标。
还有一层老教训。1983年认知心理学家Lisanne Bainbridge在《Automatica》发文《自动化的讽刺》:自动化接管常规工作后,留给人的是监控、异常干预、处理它搞不定的部分——恰恰是最难保持熟练的任务。2018年IEEE那篇回顾的标题更直白:《自动化的讽刺:这么多年过去了,依然无解》。把「自动驾驶」四个字换成「AI办公」,结构一模一样:系统生成,人兜底;出错的追责链条上,没有任何一个环节叫「模型」。知乎
三、最后看排期:时间不是省下来了,是搬家了
「为什么开发变快了,项目排期一点没缩短」这个问题下,高赞答案描述的现象很具体:以前没想清楚的需求会被评审拦下来,现在默认「有AI应该很快」,大量没收敛的东西直接扔给开发,返工次数明显上升,省下来的时间又全填回去了。知乎
另一边,有员工爆料大厂内部开会就是互丢AI生成的文档,改都不改直接甩群里——每人用20分钟生成一份「挺像样」的文档,变成下一个人一个半小时的核对量。有人算过这笔时间账:用AI写一版方案二十分钟出稿,然后你花一个半小时改它。因为这份东西发出去,签的是你的名字。AI能自动化生产,但不能自动化责任。 责任不会消失,只会沉到链条最末端那个有名字的人身上。知乎
一家做企业数据智能的公司(明略科技)在行业复盘里把「工作从3天缩到10分钟」之后的组织欠账归成三样:信息交接、经验复用、结果把关。个人提效是工具问题,组织提效是流程问题——工具三个月一换代,流程没跟上,省下的时间就只在环节之间搬家。知乎
四、这三本账分别怎么记
给老板/转型负责人:把「AI让我们提效了多少」这个考核语从需求单里删掉,换成三个可核对的问题——需求返工率降了没有?核对队列(谁在等谁验)变长了没有?「AI写了X%代码」的源数据是谁、怎么填的?效能平台上线第一个月最有分量的产出,往往不是某张看板,而是一份数据完整度报告,拦住了一个尚不可验证的「提升百分比」被写进正式目标。
给团队负责人:管住Agent的「存在感开销」——心跳/轮询间隔、空任务阈值、批量调度,8万个Agent的教训适用于80个;再给AI产出立一条和人所产出同级的规矩:查无实据,整体作废。顺便把「有AI应该很快」从排期口头禅里清出去,它就是返工率的另一个名字。
给个人:AI省下的那30分钟,大概率不是给你下班的,是给「读、改、验」的。把复核时间排进日程,而不是塞进下班后的缝隙——这也是「AI产出在深夜」的另一种成因。
接下来看什么
9月29日OpenAI DevDay,已经有知乎作者提前押注:Altman要发的Managed Agents会把Agent、环境、技能、插件整套托管到平台上——OpenClaw创始人今年2月就加入了OpenAI,这注押得不是没道理。如果成立,「心跳账单」会从企业自付的Token账单变成平台订阅价,美团式账单的记账规则要整个重算。再往下就是Q3财报季,看有没有第二家大厂把AI账单和排期数据一起摆上台面。知乎
在那之前,下次再有人拿「AI提效X%」或「AI让你变慢」来劝你,先问一句:这本账是谁记的,用的什么证据标准,数据日期是几月的?三个问题问完,一半的故事会自动退场。