同一模型,成本差70倍:这周三件事说明——你的Agent"降智",可能真不怪基模
先对个时间轴,几个"降智"瞬间你大概率全遇到过:
任务跑到十几轮,它突然不再遵守你开局立的项目规矩;
换了个时髦新工具,明明同一个模型,积分就是烧得肉眼可见地快;
你去吃个晚饭回来,它已经把需求聊忘了,开始自由发挥。
长期以来,这口锅都甩给"模型不行"。但这周发生的一串事,把矛头齐刷刷指向了同一个方向:模型外面那一层——框架、上下文、说明书。
一周三件事,全撞在"模型之外那一层"
第一件事:Claude Code"低头"了。9月19日上线的2.1.277版本,正式支持在没有CLAUDE.md时自动去读AGENTS.md。GitHub上这条Issue从2025年8月挂到现在,攒了5200多个点赞、300多条留言,是全仓库票数最高的功能请求,比第二名高四倍。 现在AGENTS.md一份通用——这个格式由OpenAI推出,Codex、Cursor、Copilot、Gemini CLI、Devin都认,全球超过6万个开源项目已经在用。这对同时用多款AI的人是个实打实的止损:以前张三用Claude Code、李四用Codex、王五用Cursor,同一个项目得备两份几乎一模一样的"AI说明书",改了这份忘那份,AI就照着过期那份干活。36氪

第二件事:DeepSeek亲自下场造"马具",还开源了。8月中旬开源的Agent执行框架DeepSeekHarness,公测两天拿下近十万GitHub Stars,口号是"Model+Harness=Agent"。9月18日36氪的解读文章里引了一组更狠的行业数字:生产环境Agent的失败率在70%~95%区间,其中六成失败归因于数据质量、上下文缺口和治理缺失,而不是模型本身。要打个折听:这是厂商软文里引用的行业口径,但方向和第三件事对得上。36氪
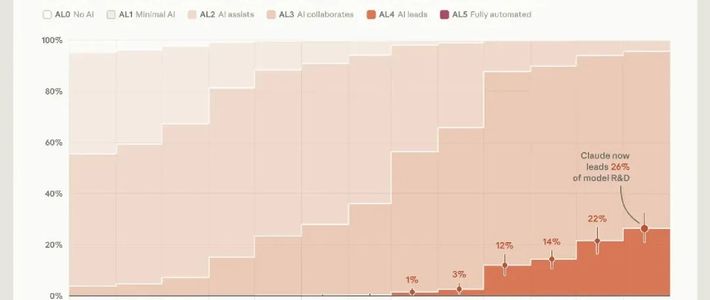
第三件事:Anthropic首次公开自己的底牌。9月17日发布的数据:到8月,Claude已能"主导"Anthropic约26%的AI研发工作,超过90%至少达到"AI协作"水平。 其内部使用最广的Agent平台上,约3万个Agent同时在跑研究和工程任务,而今年2月Claude能"主导"的比例还不到1%。更有意思的是管理细节:让3万个Agent不乱来,靠的不是换个更聪明的模型,而是两条工程纪律——每个Agent独立身份、行为全记录,Agent之间必须走共享消息系统通信,每条消息绑身份、可溯源。最信模型智力的公司,正在用"模型之外那一层"给模型上秩序。36氪
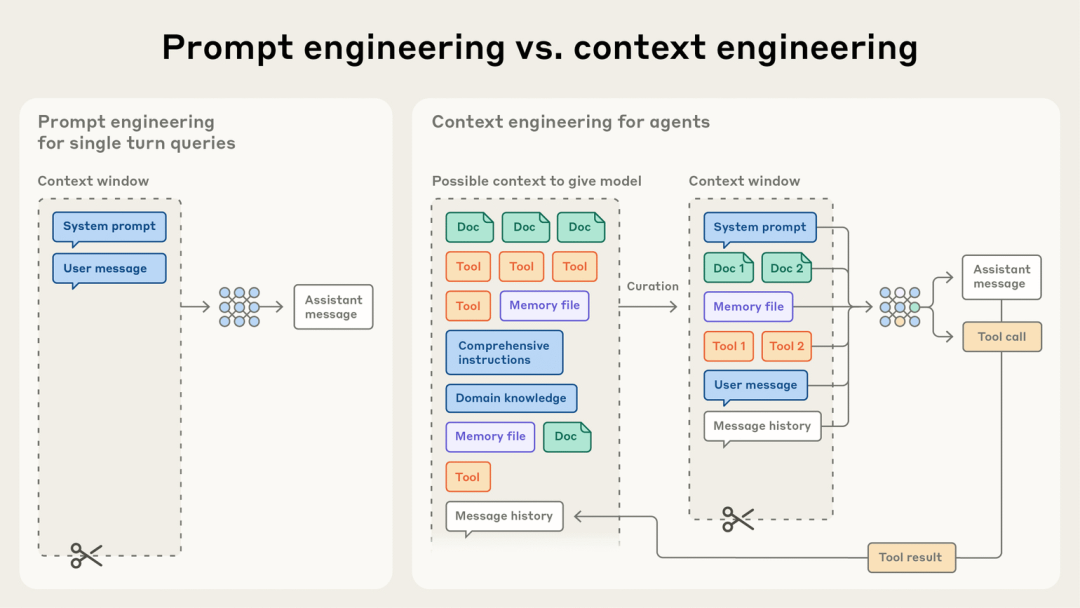
用户端的反应同频。9月15日知乎那篇《别再只卷Prompt了,真正拉开Agent差距的是Context Engineering》,和李博杰开源的《深入理解AI Agent》,后者单篇被收藏1682次。这篇文章里描述的那堵墙,很多人上周刚撞过:工具返回值越堆越多,有用信息被淹没,系统提示写得再好,也扛不住上下文被"稀释"的侵蚀。 这一周的热点讨论,已经从"哪个模型强"挪到了"这匹马到底该怎么管"。知乎
70倍硬数据:成本黑洞藏在"启动税"里
概念之外,这周最值得收藏的是9月9日36氪汇总的三项基准实测,第一次把"框架决定成本"量化了:
同一个模型、同样的12个Python任务、12种Agent配置走同一个API对比:单个任务消耗token从约3500个到29.2万个不等;
8个框架、30个企业工作流、240次运行:每次成功任务成本从PiAgent的0.028美元到Claude Code的0.195美元;DeepAgents通过率和Claude Code持平,成本只有它的四分之一;
差距的来源被命名为"启动税":框架在你开口之前,要先把它自带的系统提示词和工具说明发一遍——最少约700 token,最多约2.6万,而且每轮重发。一个每轮带2.6万token的框架跑15轮,光脚手架就吃掉约39万输入token。回归检验显示"启动税×轮数"足以预测单任务成本,R²高达0.99,且换两个毫不相干的模型排名几乎不变。36氪
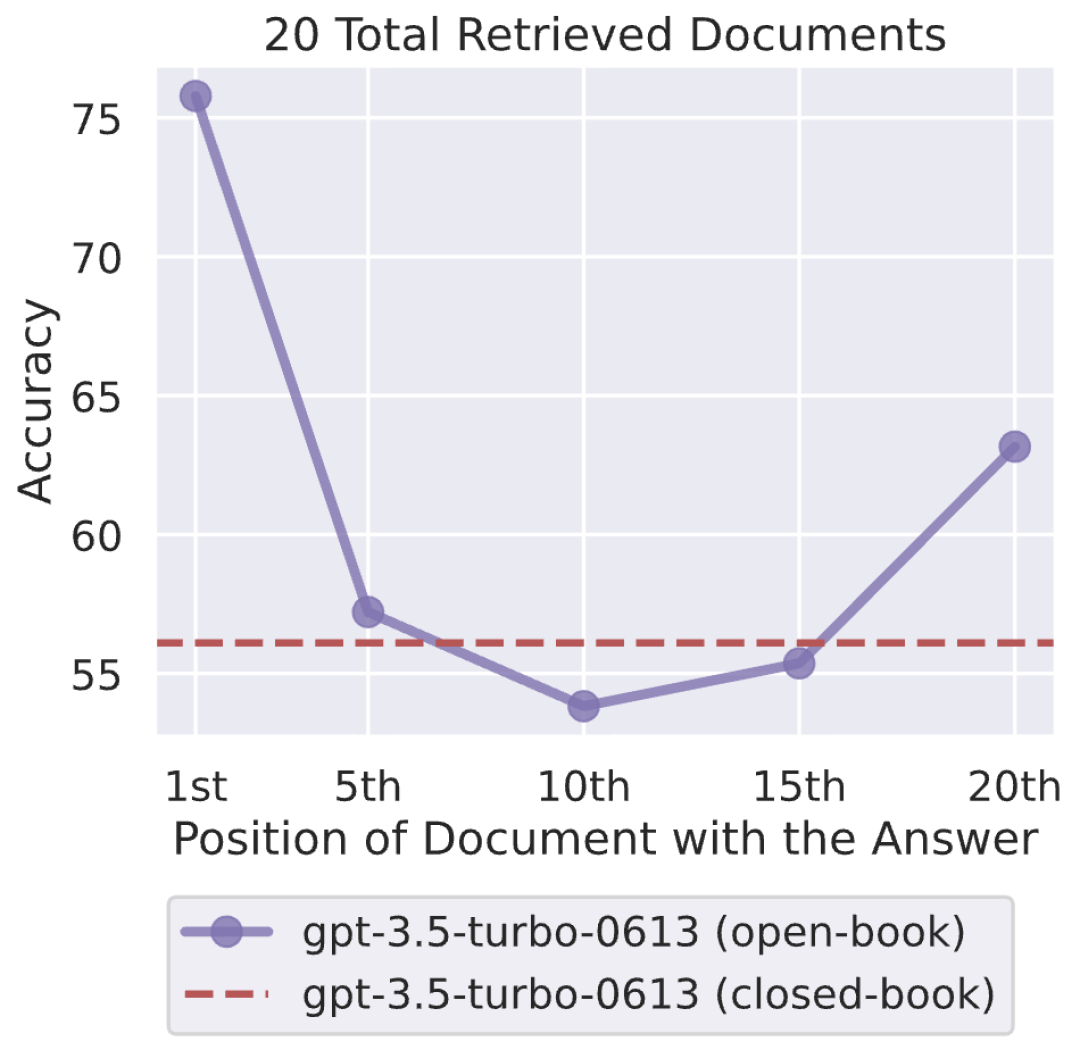
诚实标注一个限制:6月那组测试每个组合只跑了一次、没有方差估计,原文自己也提示,看ArtificialAnalysis那个326任务、每项跑三遍的综合指数更稳。但两组数据指向一致——差异来自框架软件,而不是模型行为。更反直觉的是:各框架的上下文每轮增长都差不多快,"窗口更长、塞得更多"根本不是省钱键,每轮固定开销才是。塞得多甚至可能更糟:这张经典的"Lost in the Middle"实测图显示,喂进20篇检索材料时,答案文档放在上下文中间位置,准确率从放开头的约76%掉到约54%——比干脆不给材料(约56%)还低。
给自费提效党的三本账
1. 多轮跑任务的人:查账单,再怀疑智商。打开usage面板看每轮input token数——如果远超你实际喂的资料量,你就是在替启动税买单。这时候换轻框架、减少轮数、长任务中途主动总结交接,都比等下一代模型立竿见影。知乎上周"为什么越来越多人放弃Claude Code转Pi"的帖子和小红书那条"豆包工作和WorkBuddy到底选哪个"(883赞)的热度,都是同一个情绪的两种问法:选型焦虑的尽头,是对隐性开销的失控。
2. 同时用多款AI的人:今天就可以只写一份AGENTS.md。软链接、@导入、启动钩子这些土办法统统可以下线。团队零成本统一,顺手把"改了说明书AI不知道"这个降智源头堵掉。
3. 不用入坑的人:这轮跟你关系不大。单轮聊天党、提示词模板收藏党,上下文工程只在"多轮、多工具、真的让AI干活"时才有成本问题。别被"Harness时代"的叙事拽着买课。
一个共同提醒放在最后:Agent执行力越强,信任问题来得越早。这周知乎同时热着"ZCode被曝上传用户git仓库"和"搭了Agent流程最后切回人工",后者最高赞回答的结论很冷静:"不是基模不行,是行业缺可复用、可评估的接入方案。"越想用AI替你干活,越要先看权限和数据边界那一栏。
接下来盯什么
Claude Code这次更新的真正伏笔不是AGENTS.md本身,而是官方首次示范了用mod插件改自己运行框架——这次AGENTS.md的支持就是用mods做出来的。 “读什么、怎么读"开始不由一家说了算。后面盯两个信号:其他工具会不会跟进默认读AGENTS.md,那才是标准统一的分水岭;计费叙事会不会从"模型token单价"卷向"框架启动税”——就在这个周末(9月20-21日),爆火的Jev宣布向所有用户开放,注册就送5美元额度、约合1.2亿token。 低价token战开打之后,第一个按"每次成功成本"明码标价的框架,会把70倍的差距从论文里搬到你的账单上。36氪36氪

你的Agent可能一直很聪明,只是给它套马具的人,向来不太讲究。