这个秋天,测速帖的量词从"张"变成了"卡"
如果你九月还混本地大模型的圈子,应该已经发现风向不对:以前帖子标题是"16G卡跑XXB行不行",这两周密集冒出来的是"8卡3080跑753B"“8卡2080Ti部署GLM-5.3-Flash”“四卡V100 NVLink水冷装机”“8台华硕GX10跑DeepSeek V4.1”。9月11日到14日这四天里,B站科技区至少四五条多机多卡实测视频,连96G魔改5090那条吃瓜视频都冲过了1.5万播放。8卡2080Ti实测视频底下,有人问"现在2080Ti多少一张啊"——当年炼丹退役的卡,正在被攒集群的人回头扫货。哔哩哔哩
单卡玩家为什么突然开始组队?原因不神秘:这一轮开源旗舰全是"大块头MoE"。GLM-5.2 753B、DeepSeek V4.1-Flash约748B(552B主干+196B Engram),激活参数不大,但权重总量摆在那——任何一张消费级显卡都装不下。以前"一张卡跑27B"的显存速查表突然不够用了,而新卡这条路又贵得离谱:评论区流传的行情是5090逼近5万、RTX PRO 6000一张10万+、DGX Spark这种盒子也要3.5万+。 于是第三条路火了:手里的老显卡、闲鱼上的退役卡,插到一起凑容量——最早把这条思路跑通的,就是把服务器退役卡用转接板"焊"进家用机箱的那帮人。哔哩哔哩哔哩哔哩
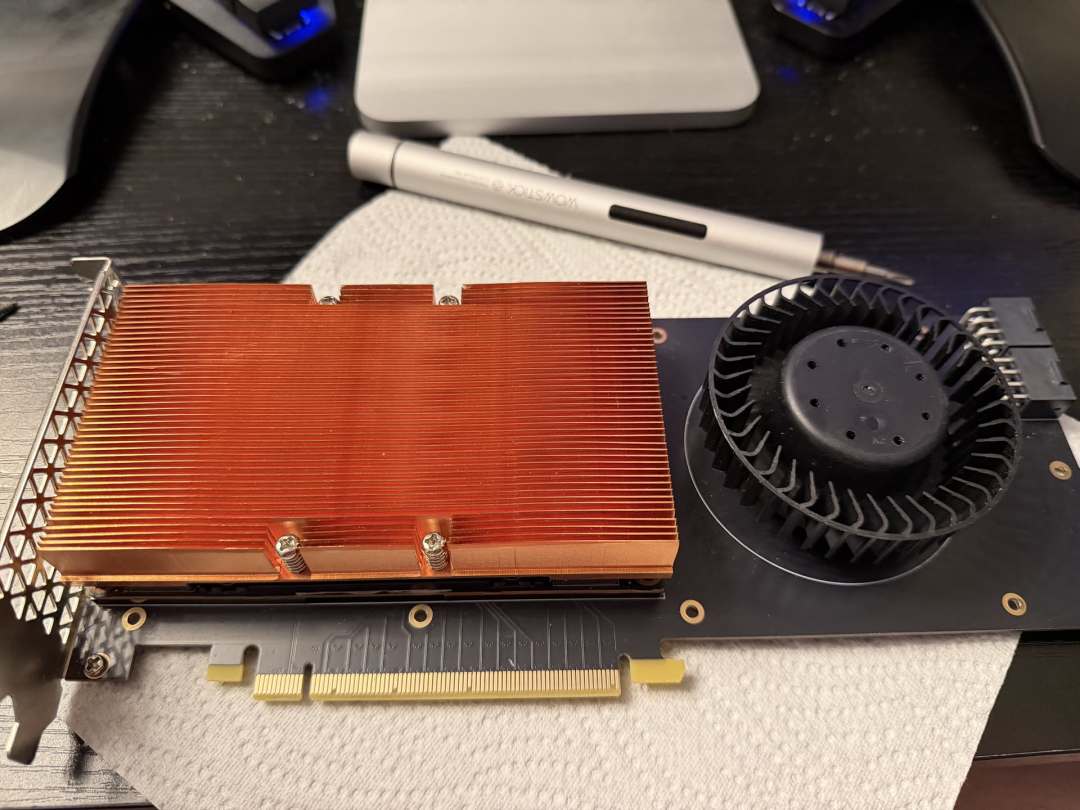
但把全网能找到的十来个独立实测摆在一起看,结论并不一律乐观。这篇就干一件事:替你把这波"组队潮"的实测数据拉通,然后把上车前的三笔账算清——容量账、速度账、电费账。
全网实测拉通:同样是"8张卡",结果差了八倍
先把散在各处、单个UP主只给自己配置的实测整理成一张表(全部来自近两周公开发布的自测数据,速度均为发布者口径,未复测):
配置 | 显卡总容量 | 模型与量化 | 框架 | 实测表现 | 发布源 |
|---|---|---|---|---|---|
8×RTX 3080 20G | 160G | GLM-5.2 753B,FP8→INT4(约350GB权重) | ktransformers+SGLang | 解码12.6 t/s,64K上下文,连续生成4315行代码不崩 | Ryan_W_lab |
8×2080Ti 22G | 176G | GLM-5.3-Flash,Unsloth IQ4_XS分5片 | llama.cpp | 短文本约30 t/s;33K上下文预填充约180 t/s、解码18 t/s | 春日野穹b |
2×2080Ti(NVLink) | 44G | Qwen3.8-27B | vLLM/llama.cpp | NVLink带宽+61%,解码39→53 t/s;180W限电不掉速 | 廿二一一一 |
4×V100 16G | 64G | Qwen3.8-27B FP8 | vLLM | 约110 t/s | 智冷算力工作站 |
2×RX 7900XTX 24G | 48G | Qwen3.8-27B IQ4_XS | ROCm+llama.cpp | 双路独立实例并发114 t/s(单路58-63),114K上下文仍80+ | 玩客笔记 |
8×华硕GX10小主机 | 1024G分布式 | DeepSeek V4.1-Flash约748B | vLLM/SGLang,TP/PP/EP组合 | C1解码中位数:计数108、代码83、正文37.5 t/s | MagicBear |
5060Ti×2/3/4 | — | 多并行模式对比 | llama.cpp | 折腾一个月,重点结论在P2P开没开 | 飞鸟大叔 |
这张表里藏着两个单看任何一条视频都得不出的信息。
第一,“8张卡"三个字背后的体验差距是数量级的:同样跑大MoE,8卡3080给你12.6 t/s,8卡2080Ti给你30 t/s,8台GX10在正文类任务上给37.5 t/s,但跑27B级别的双7900XTX能上到80+。模型规模每上一个台阶,解码速度对折再对折。指望集群"既跑753B又快"的人可以散了——这一波的物理规律就是:容量换来了"能不能跑”,换不来"跑得快"。753B这个量级在八卡3080上的完整战绩是:64K上下文下连续生成4315行Python代码、最高12.6 t/s、最后没崩。哔哩哔哩
第二,AMD和N卡的多卡思路完全不是一个物种。N卡的牌是NVLink和P2P:2080Ti加桥接器带宽涨61%、解码39到53。 5060Ti那个作者折腾一个月,标题里专门留一行讲"P2P安装要注意的点"——消费卡默认不开P2P,多卡通信全走主板,这是很多人双卡反而更慢的元凶。AMD没这个选项,7900XTX那位干脆放弃了张量并行(并发时互锁、掉到1.1 t/s),改用"双卡各跑一个独立256K实例":不追求单条对话更快,而是同时喂两个本地Agent,总吞吐反而做到了114 t/s。 这是本周评论区最有信息量的一条路线之争——“并行"和"并联”,是两个方案。哔哩哔哩哔哩哔哩
第一笔账·容量:决定你买几张卡的,是你想跑什么
这波集群潮的需求端是清晰的:GLM-5.2的INT4权重约350GB,Ryan_W_lab用160G显存加768GB DDR4内存才把它喂进去(ktransformers走的就是显存放权重、内存放专家的路线);GLM-5.3-Flash压成IQ4_XS分5片,8张2080Ti的176G刚好兜住。换句话说,卡的张数不是"多多益善",是跟着权重大小倒推的:跑27B,两张2080Ti的44G都绰绰有余(llama.cpp Q4量化单卡16G就装得下);想碰753B,160G起步还得配几百G内存。先确定模型和量化档位,再数卡,顺序反了就是白插。
"凑容量"这条路最早的爆款样本其实不是八卡巨机。今年5月,一位海外博主晒出200镑方案:eBay上一块150镑的退役Tesla V100 SXM2(2017年数据中心货色,连PCIe接口都没有)加一块50镑的山寨转接板,插进游戏机,和自己原有的RTX 4080拼成32GB显存,跑27B模型到32 tok/s。 这张卡自带的HBM2带宽有900GB/s,反而比4080的GDDR6X高22%——大模型推理的瓶颈从来不在核心算力,在显存带宽和容量,过气服务器卡的技能点恰好全加在了刀刃上。微博tymscar博客
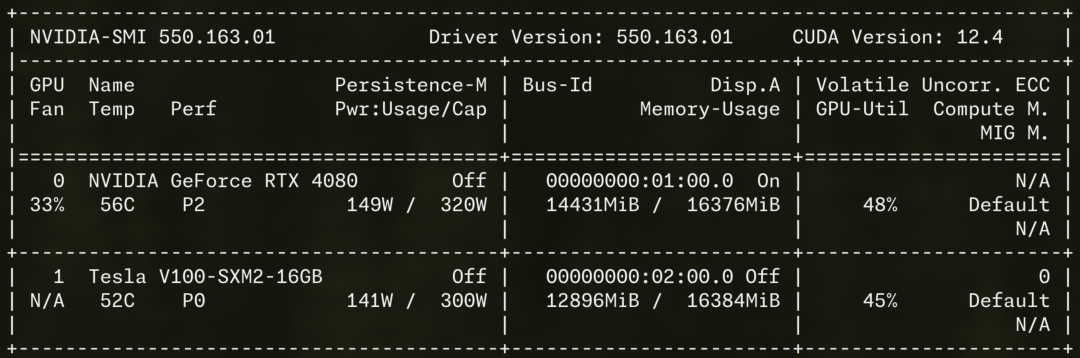
这套组合在nvidia-smi里长这样:一块4080(16376MiB)和一块V100-SXM2-16GB(16384MiB)并排挂载,llama.cpp按层把模型拆分到两张卡上跑。 同一思路放大,就是本周那些四卡V100、八卡老20系:显存是按GB堆出来的,不是按单卡型号等出来的。tymscar博客
第二笔账·速度:预填充才是集群的照妖镜
评论区对8卡2080Ti那条吵得最凶的一句话是:"dec不过百,prefill不过k,玩不了智能体。"这话刻薄,但戳中了要害:对话看解码,Agent和长文档看预填充。33K上下文的文档,按180 t/s的预填充速度,光"读完题"就要3分钟,然后才开始以18 t/s吐字;而云端API的prefill是几千t/s量级。 8卡3080那位作者的调优记录也印证了天花板在哪:deferred 8提升7%、numactl interleave再榨3-6%、热专家缓存+6%——纯软件优化把11.8磨到12.6,距离DDR4-2133平台的理论极限15已经没剩多少,“再快只能换硬件”。哔哩哔哩
所以速度账的正确算法是:你一天到底喂多长的上下文。纯聊天写代码补全,18-30 t/s够用;要本地Agent反复啃几十万字资料库,这波的家用集群还接不住。MagicBear那期的结论同样值得抄进小本本:GX10八机计数类任务解码破百,但"计数破百不代表所有聊天任务都能达到这个速度"——他给的是三个任务的中位数(108/83/37.5),不是单个最漂亮数字。 看集群实测,先问是不是中位数、任务类型是什么,再心动。哔哩哔哩
第三笔账·电费和那些没人报价的配件
“这个电费跑得赢API吗?”——这是8卡2080Ti视频下面点赞最高的质疑,而UP主在简介里特意写了一句"本视频电费不用UP主出,不用计算电费"。 这句自嘲恰恰是这波集群潮最大的隐藏变量:相当一部分玩家晒的集群,电是公司的、机是宿舍的、空间是不算租金的。哔哩哔哩
电费到底多少,MagicBear给了目前全网最诚实的一组数:8台GX10整机电力预算按500W、四卡RTX方案按1600W,每天在线8小时、每度8毛,年电费约1168元 vs 3738元,差约2570元——他还特意标注这是独立预算情景、不是同任务token/J对比。 拿这个模型套一下8卡2080Ti:单卡TDP 250W级别、满载八张就是接近2kW的取暖器,若全天挂机,一年电费四位数起步,够买不少API额度。反过来,如果你的集群只在本地"下班时间"跑,那这笔账又另说。哔哩哔哩
比电费更容易漏报的是配件:四卡V100那位晒的方案是"300G底板直通、免拆分8749整机、240水冷静音"——服务器主板、拆分流器、水冷,这些在显卡预算之外。GX10评论区的老哥补了一刀:多机互联还需要一台配置不错的高速交换机,不然极大影响互联速率,他自己就是4机+812交换的实战用户。 攒集群之前打开购物车,把平台、电源、交换、散热全算上再和"一张5090"或"一台DGX Spark"对比,别只数卡价。哔哩哔哩
运行功耗也别靠想象。知乎上月那位把两块SXM2版V100装进一个机箱、自称"32GB巨大显卡"的作者算了笔细账:满载跑大模型时功率计特写拍到450W出头,大约两三个小时消耗一度电,一天下来10度上下、电费5到10块——他自己的结论是"放公司里问题不大,个人长时间挂机需要认真考虑"。 还有更直观的坑:V100转接板自带的风扇是为机房设计的,那位200镑玩家实测82分贝、“介于垃圾处理器割草机之间”,最后是用两块钱的跳线接上主板PWM把转速压到10%才消停——噪音、散热、供电,每一样都有各自的隐性账单。知乎
魔改卡这波:一半真香,一半是骗局
容量焦虑直接抬高了大显存魔改卡的热度,这里必须做个反证辟谣:本周刷了15万播放的"96G显存魔改5090、不到3万",评论区已经被华强北从业者拆穿——发布者是国际站引流号、链接已下架,“真出来说明书得7万起步”。 有人算了原料账:3Gb的GDDR7颗粒半个月前单颗报价就一千多,卖你三万是做慈善?哔哩哔哩
但魔改这条产业链本身不是骗局,成熟度和型号强相关:2080Ti 22G是最老牌的成熟方案(今年8月知乎实测作者报的行情约2300元一张,双卡加NVLink跑27B解码能到50+)。 再往上是4080改32G、4090改48G,4080的32G涡轮改版卡今年8月已经批量出现在闲鱼、报价普遍过万。 圈内人的判断标准很朴素:"改显存主要看VBios支不支持,不支持改上天也没用。"一句话:老卡魔改可以按成熟型号的上车,5090改96G这种"未来卡改未来容量"的,目前只存在于引流话术里。知乎IT之家

谁该组队,谁别动,以及正在发生的另一条路
把三笔账合起来,适用性其实分得很开:
手里已经有两张以上2080Ti/3080/V100级别卡、电费不计入自己成本、刚需是隐私和本地长文档的——这波集群值得玩,双7900XTX"双实例喂两个Agent"的玩法甚至值得抄作业;手里只有一张16G、想靠买三四张二手新卡凑集群跑大MoE的——大概率是给贩子抬价,你的钱不如先等量化格式和流式加载成熟;至于指望家用多卡跑重度Agent的——这周的数据摆着,prefill这一关没过,再等半年。
值得继续盯的信号也有两个:一个是colibri这类把744B参数塞进25GB内存的流式推理项目刚开源,“不插满显卡、插满内存"的路线如果跑通,组队潮最贵的部分(卡)可能明年就变便宜。 另一个是B站已经有Strix Halo用户开始"双节点张量并行踩坑”——小主机串集群,可能是下一波把门槛打到万元内的玩法。哔哩哔哩
这波老显卡组队的本质,不是显卡不够用了,而是"想跑的模型"和"买得起的卡"之间裂开了一道容量鸿沟。鸿沟是真的,填法也在快速迭代——所以先算账,再插卡;先看中位数,再看宣传图。你手里的老卡,正在等你决定是让它继续吃灰,还是给它找个队友。