
十月的本地部署圈,风向变了。
以前社区聊本地大模型,话题是"你的卡能塞下多大参数";现在打开B站、知乎、Reddit 的 LocalLLaMA 板块,高频句式变成了"部署 Qwen3.8-27B 之后,我的 DeepSeek 可以退休了(吗?)"、“我蹬了 50 亿 token,体感比云端旗舰好用”。云端 API 从主力降成了备胎——这不是某个 UP 主的暴论,是评论区里一堆人真金白银跑出来的共识苗头。哔哩哔哩
但同一时间,另一批人晒出来的是完全不同的画面:看了一晚上"打字机",烧了 4 度电,才等到一个坦克大战游戏完整输出;12G 显存党反馈上下文一长就漂移、复读、突然开始说纯英文。知乎哔哩哔哩
159 tok/s 和 17 tok/s,说的都是这颗 27B。到底信哪个?这篇文章把这两周的实测帖全翻了一遍,把账算给你看。
159 tok/s 的标题,和它没写在标题里的三个前提
10 月 9 日,Reddit LocalLLaMA 板块被一条跑分刷屏:Qwen3.8-27B Q4 量化,代码提示解码速度接近 160 tok/s,很多人当场宣布"本地编程零延迟时代"。知乎
但把原帖的测试链路拆开,这个速度至少要踹三个门槛:
硬件不是游戏卡:Sapphire Radeon AI PRO R9700,专业工作站显卡;
引擎不是 Ollama:LemonSeed Engine(LSE)0.5.8,底层做了 GEMM 算子融合和注意力双查询瓦片优化;
关键外挂:DFlash2 投机解码(Q8 草稿),小模型先猜一串 token,27B 主模型批量校验。
对照数据很残酷:同一颗 27B、同样是 Q4,在 Mac Studio M3 Ultra 上用 Ollama 跑,实测约 14 tok/s,光权重就吃掉约 17GB 内存。 AMD Strix Halo(Radeon 8060S)原生基准 14.0 tok/s,换上 LSE 也就回到 64.4。知乎
所以"159"和"14"之间差的不是模型,是引擎和投机解码。这波速度革命的真实名字叫:本地推理的瓶颈正在从"卡够不够贵"转到"你装没装对软件"。

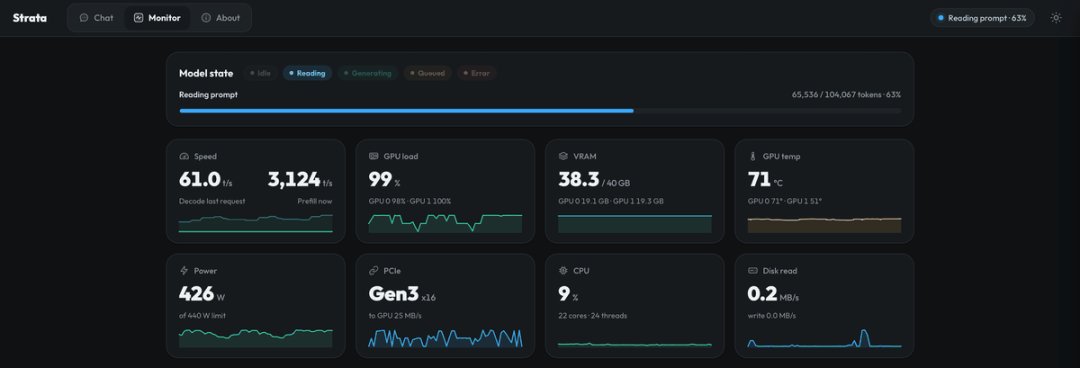
还要提醒一句:那张刷屏的评测里 1,634 tok/s 是预填吞吐——喂长文档时的读数,不是你对话框里的出字速度。同一个开源监控面板画面里,预填能冲到 3124 t/s,出字那一栏只有 61 t/s,量级差一目了然。
地表实测:从 90 tok/s 到 17 tok/s,差距是硬件档位
把 B 站"部署 27B 后 DeepSeek 能退休吗"那条视频(504 条评论)和知乎实测帖里带配置的数字拣出来,能排出一条很清晰的档位线:
双 5090D + 192GB 内存:llama.cpp 纯文本聊天 90–100 tok/s;挂上 Agent 框架调用工具后掉到 70 左右;换 BF16 全量约 45 tok/s。 该用户原话是"为了精度,能接受";哔哩哔哩
4090 单卡 + 专用引擎优化:评论实测 100+ tok/s;
双 4090 + vLLM:知乎教程跑通了 128K 上下文、10 路并发加工具调用,这是"给全家/工作室供 API"的玩法。知乎
AMD 显卡 + HIP + llama.cpp 常规部署:约 17 tok/s,作者跑 OpenCode 做坦克大战,卡 Thinking 一小时没出活,降级回 llama-cli 直出,模型自己修了几轮 bug 后代码一次跑通——质量在线,速度劝退,外加"一晚 4 度电"。知乎
4060Ti 16GB + LM Studio:27B 只能 15 tok/s 左右,同机器换 llama.cpp 起服能到 50。 工具栈本身就是瓶颈,LM Studio 多卡支持差是社区老槽点;
连"过时"的双 3080 20G 都有活干:PolyStrata 仓库里 10 月 8 日的社区实测,两张 3080 开 512K 上下文池,监控面板上出字稳定 109.4 t/s。GitHub

结论一:27B 当主力不是"行不行",是"你在哪个档位"。 4090/5090 级加对引擎,写代码、跑 Agent 是真跟手;12–16G 卡硬上 27B,体验就是"看打字机"。
那为什么还有人把云 API 降成备胎?因为账不在跑分上
翻评论区,把 27B 升成主力的理由反而很朴素:
有用户拿 Qwen3.8-27B-FP8 单月跑了约 50 亿 token,说疑难 task 只有约 5% 需要回落到云端旗舰;
有人拿 27B 挂 DeepSeekHarness 跑长任务,3800 万输入 token 没切过前沿模型,还给了量化取舍:Q8 换 Q6 精度只掉 0.2%,Q5 掉 1.4%,32G 内存能开约 13 万上下文。哔哩哔哩
对云端最扎心的吐槽是:“做视频的速度跟不上 DeepSeek 调价的速度”。DS 后来降价了,但这位用户没回去——“它现在只能当备胎了”。哔哩哔哩
API 涨价、宕机、限流反复教育用户之后,本地部署的卖点已经从"省钱"变成了确定性:电费可预测、速度可预测、数据不出门。跑分慢一点,换来的是不用每周重算一笔 token 账。
先别下单:两类人被劝退的画面,也很真实
12G 显存以下党:3060 用户实测上下文一长就漂移、复读、冒英文,且新量化版比上代更吃上下文(有双 3060 用户反馈 Qwen3.8 只能开 88K,3.6 反而能开 190K+)。知乎那篇标题说得直接:“显存有 12G 就别研究 27B”。 这个档位现在更理性的路线是 Flash 类 MoE:125B 的 Qwen3.8-Flash-Next 配 Strata,48G 内存加 5070Ti,实测输出 120t/s。知乎
准备新买硬件入场的:内存价格这一年还在往上走,27B Q4 权重就要 17GB 起,涨价涨的不只是显卡预算。买卡前先问自己每天云端账单是多少——月消费不到几十块的,本地化的回本周期会长得离谱。
接下来盯什么
这波"27B 主力化"能不能站住,看三件事就够了:
引擎军备竞赛:LSE 之外,hipfire 号称 27B 目前速度最快的推理引擎,DeepSeek 也在 10 月 21 日开源了自己的推理框架 deepinfer,官方曲线把"单人速度"和"整卡吞吐"的取舍直接摆上了台面。 投机解码正在从博主教程走进默认安装器,软件门槛在塌;知乎哔哩哔哩
MoE 跟进:MiniCPM-V4.7-35B-A3B 这种 3B 激活的多模态 MoE 已经来和 Qwen3.8-27B 掰手腕,小激活量 MoE 是下个月中端卡的主线。知乎
官方动作:社区已在传 Qwen4-Max 和 Qwen4-27B,老玩家的说法是"我做好准备了"——按这代节奏,27B 档半年内还会洗牌。知乎

一句话收束:27B 当主力,对 24G 显存以上、每天重度消耗 token 的人是真机会;对 12G 以下和新买卡的人是伪命题。 先量自己的档位,再看引擎更新,最后才是要不要退订云端——顺序别反。














