昨天(美东时间 10 月 6 日),谷歌 DeepMind 放出了一个 740M 参数的开源模型 EmbeddingGemma 2。它不聊天、不出图,做的事只有一件:把文字、代码、图片、视频、音频统统塞进同一个 768 维向量空间,让"用一句话搜你的相册和录音"第一次可以在手机本地离线完成。微博
先给结论:这不是又一个"发布即巅峰"的聊天模型新闻,而是端侧 RAG(本地检索增强)拼图里缺了很久的那块——检索这块短板,今天被 567MB 内存补上了。 但它不是开箱即用的消费级产品,装之前有几个坑,已经有 B 站 UP 主替你踩过了。知乎
一、先把"它到底是什么"掰清楚
很多标题把它写成"手机变成 AI 搜索神器",容易让人误以为多了个会回答问题的助手。不是的。EmbeddingGemma 2 是嵌入(embedding)模型,相当于一个"图书管理员":把你的照片、语音备忘录、视频片段、文档统统翻译成可比较的坐标,你输入一句话,它负责把最相关的东西找出来——但它不生成答案。
要形成完整体验,它需要和一个生成模型搭档。谷歌给的标准组合是 Gemma 4:EmbeddingGemma 2 负责找,Gemma 4 负责答。两者共享文本分词器和音频编码器,同时运行时总内存占用反而更低。上一代纯文本版 EmbeddingGemma 下载量已超 2000 万次,这代直接把模态从文字扩到了五种。
二、值得记下来的几个数字(多信源交叉核对)
项目 | 数据 | 对你的意义 |
|---|---|---|
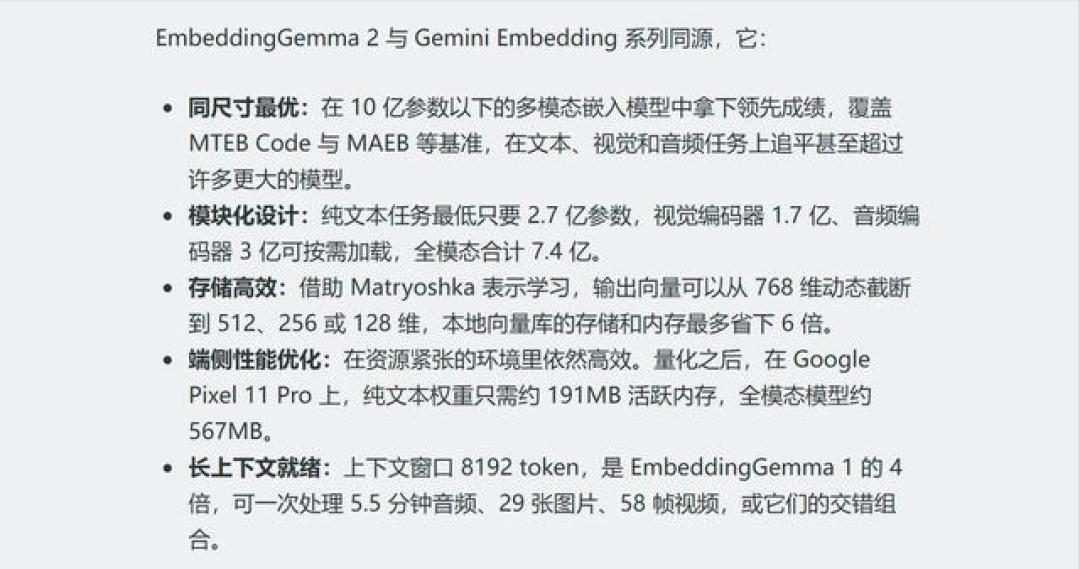
参数量 | 740M,拆成文本 270M / 视觉 170M / 音频 300M 三个模块 | 只用文字检索可只加载 270M,按需付费 |
量化后内存 | Pixel 11 Pro 上纯文本约 191MB,全家桶约 567MB | 中端手机也跑得动,但注意这是量化后数值 |
上下文 | 8K token,单次最多 29 张图 / 58 帧视频 / 5.5 分钟音频,可交错输入 | 一段 5 分钟语音备忘录可以整段入库 |
向量维度 | 768 维,可用 MRL 技术截到 512/256/128 | 截到 128 维,本地向量库最多省 6 倍存储 |
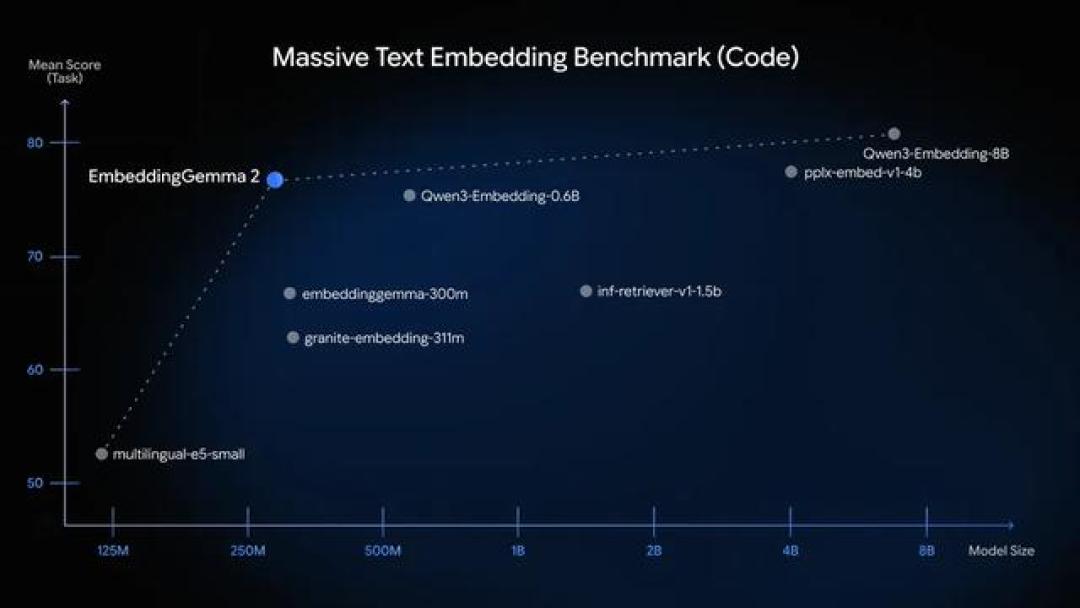
代码嵌入 | MTEB Code 从 68.76 → 78.68,提升近 10 分 | 本地代码库语义搜索第一次有了像样的开源选项 |
许可证 | Apache 2.0,权重已上 Hugging Face / Kaggle | 商用友好,接 Ollama、LMStudio、llama.cpp、vLLM、MLX、Qdrant 都通 |
生态面这次铺得很开:移动端走 LiteRT / MediaPipe,浏览器端有 transformers.js + WebGPU,服务端已接 transformers、vLLM、llama.cpp、Ollama 等主流框架。 这意味着它不是"发完论文就消失"的模型。知乎
三、真实测效果:300 张没打标签的照片,一句话搜出蝙蝠
B 站 UP 主"CodingStartup起码课"昨晚就用一台 DGX Spark 搭了 OpenAI 格式的 /v1/embeddings 接口实测:300 张无标签、无文件名的动物照片,输入"会飞的动物",返回前 9 张全是蝙蝠;输入"黑白色的动物",出来的是斑马和熊猫。零标签、纯语义,这是传统文件名搜索和 EXIF 搜索做不到的。哔哩哔哩
但同一条视频里藏着一个更重要的反常识细节,值得每个准备上手的人抄下来:
别用固定相似度门槛。 他用 score > 0.8 做过滤,结果一张照片都没返回。原因:文字→图片的分数天然偏低(大约 0.6–0.76),而图→图、文→文天然偏高,跨模态和同模态根本不在一个刻度上。正确姿势是排序后取前 N,而不是画一条线。
截断向量省空间,代价不均匀。 "省 6 倍存储"听起来香,但省到最狠那档是要交质量税的:768 维砍到 256 维结果基本还稳,砍到 128 维时压缩比 1:6,但 MTEB Code 从 78.68 掉到 71.41,多语言从 61.36 掉到 57.89,检索质量肉眼可见地变差。今日头条
四、内存数字先泼一瓢冷水
传播最广的"191MB 跑手机"是量化后、且基于 Pixel 11 Pro 的数据:原始精度占用更高,其他机型会有出入,量化本身对嵌入质量的影响谷歌没有公布具体曲线(模型卡里所有跑分都是全精度权重测的)。另外 8K 上下文对长视频、大文档仍然要分段处理,“5.5 分钟音频"是单次输入的上限,不是"任意长录音都能整段搜”。还有一点要说在前面:官方口径是多语言文本能力保留前代水准(多语言 MTEB 61.15→61.36,只涨 0.21 分),且这代把代码、图像、视频、音频全部打通进同一个向量空间、支持 100+ 语言。 也就是说这代的增量几乎全押在代码和图像/视频/音频上。拿它搜中文笔记问题不大,但"用中文描述搜出对的那张图"这种跨模态中文效果,谷歌没有给分语种数据——建议先拿自己的相册和笔记跑个小样本,或等社区基准出来再加权重。微博
五、装还是等?按人群拆开说
已经在用 Ollama / LMStudio 折腾本地知识库的: 今天就可以装。先用纯文本模块(270M)把你现有的笔记→向量库→Gemma 4 问答管线跑通,确认收益再加视觉和音频模块,内存成本可控。
做端侧应用的开发者: 值得进技术评估。Apache 2.0 商用无碍,跨模态检索(用文字定位视频某一秒、用语音搜相册)在 1B 以下参数里目前没有同质量-参数比的开源对手,对标腾讯 2025 年底开源的百亿参数 KaLM-Embedding(MTEB 多语言榜第一),这是"端侧 0.74B"对阵"云端 10B"的路线之争。
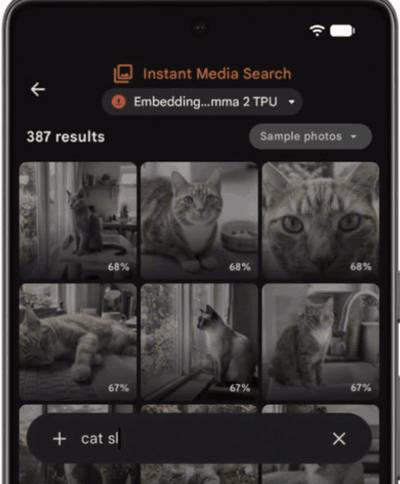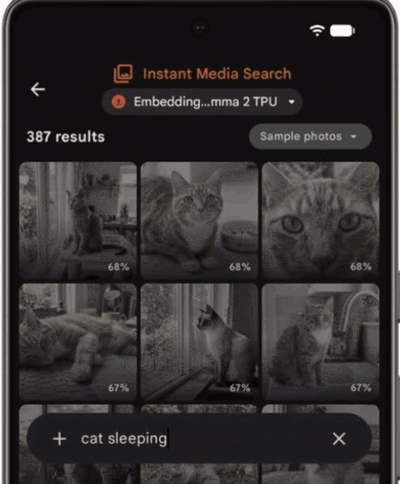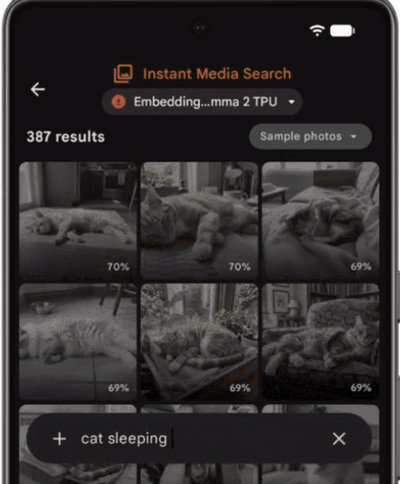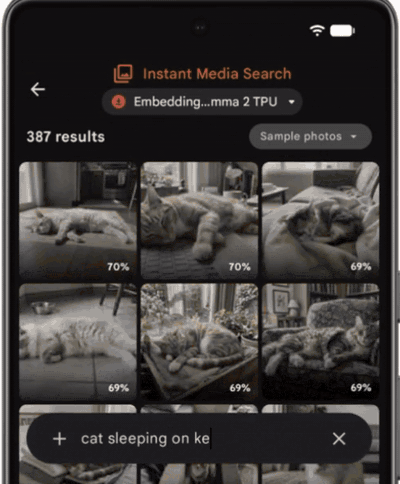
期待"跟相册聊天"的普通用户: 别急着换手机。它只是检索件,消费级 App 把 Gemma 4 这类生成端一起打包好还要时间——谷歌已经在 AI Edge Gallery 里放了"即时媒体搜索""视频时刻查找"两个演示,Mac 端还有能离线处理会议录音的 Foresight 实验性应用,Android 侧计划未来几周通过 ML Kit 开放接入。 官方链路在铺,但目前体验仍属于尝鲜层。今日头条
重中文场景用户: 缓一手,等 CMTEB 类榜单和一轮 Unsloth 中文微调案例出来再说。
六、接下来盯这几个信号
中文/多语言嵌入的第三方评测(尤其相册中文描述检索);
与 KaLM-Embedding、Jina 等路线的跨模态实测对比;
骁龙峰会这类端侧芯片发布会后,非 Pixel 机型的真实内存占用数据;
Unsloth / Qdrant 社区出现的"个人全模态知识库"现成方案——那才是普通用户该上车的时刻。
这次发布没有惊艳的 demo,但"把五种模态塞进同一个向量空间、还能塞进手机内存"这件事,是过去两年端侧 AI 最缺的基础设施。检索自由先于生成自由——对喜欢把数据攥在自己手里的人来说,这比又一个聊天模型值得记。