














 深耕数码、AI兴趣领域




9
7
英伟达用CPO连576颗Rubin Ultra GPU,打造全球最高能效巨型GPU
2026-10-24 22:02:44
0点赞
0收藏
0评论
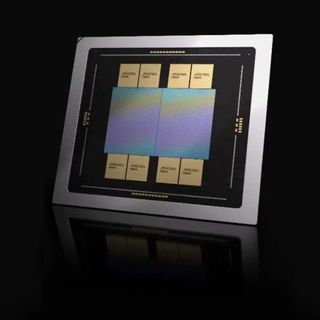
英伟达将于明年使用CPO技术连接576颗Rubin Ultra GPU,打造全球"每瓦性能最高"的巨型GPU,以驱动10万亿参数AI模型。Rubin Ultra是继Rubin之后的下一代平台,Vera Rubin "VR200"平台基于Oberon NVL72服务器构建,而Vera Rubin Ultra则将搭载在更庞大的Kyber机架上,这是一款全液冷设计的产品。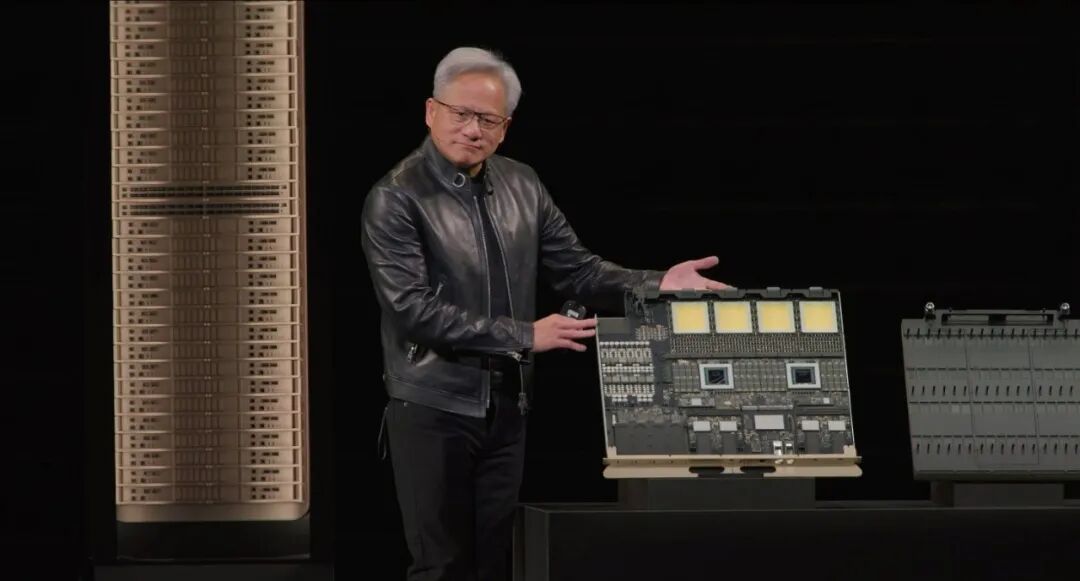
根据英伟达在GTC大会上公布的官方规格,Rubin Ultra NVL576将提供15 Exaflops的FP4(推理)性能和5 Exaflops的FP8(训练)性能,比Blackwell GB300 NVL72提升了14倍。在内存方面,Rubin Ultra将在四倍光罩尺寸的GPU上配备高达1 TB的HBM4E内存,内存容量扩展至原来的8倍,每个机架通过365 TB HBM实现4.6 PB/s的带宽。此外,该平台还将提供下一代1.5 PB/s的NVLink7互连技术,以及一款全新的ConnectX-9 Spectrum芯片,带宽达115.2 TB/s。
在OCP 2026大会上,英伟达副总裁兼超大规模与高性能计算(HPC)总经理Ian Buck表示,Kyber机架内的全部576颗GPU将通过NVLink连接并作为一个整体运行,使其成为地球上速度最快且每瓦性能最高的GPU。
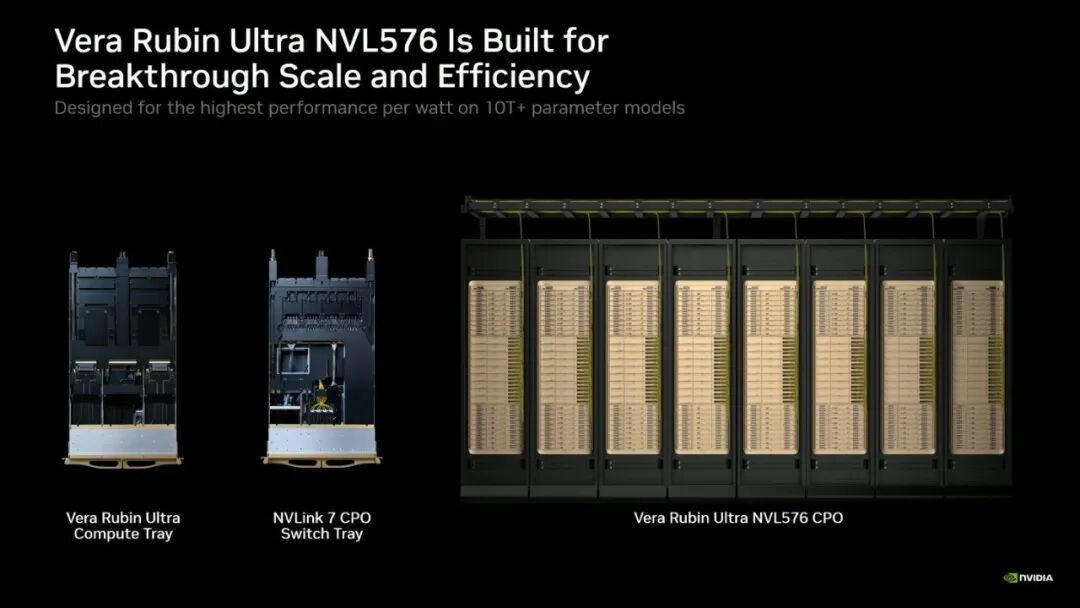
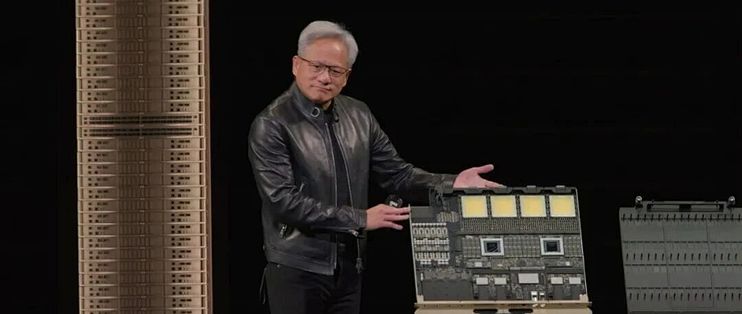
Vera Rubin Ultra计算托盘搭载了两颗Rubin Ultra GPU和一颗Vera CPU,全部采用液冷散热。英伟达还首次展示了其NVLink 7 CPO交换托盘。此外,该设计将基于OCP标准,采用了与Vera Rubin相同的模块化、即插即用设计,将安装时间从数小时缩短至几分钟。
同样重要的是,每个机架都将配备下一代NVLink CPO交换托盘。英伟达首席执行官黄仁勋刚刚在柏林GTC大会上宣布,CPO机架现已进入量产阶段,打破了有关CPO延迟的传闻。下一代英伟达光学解决方案的速度将大幅提升,而Rubin Ultra将是首个充分利用这一技术的机架级系统设计,该技术未来将成为行业标准。
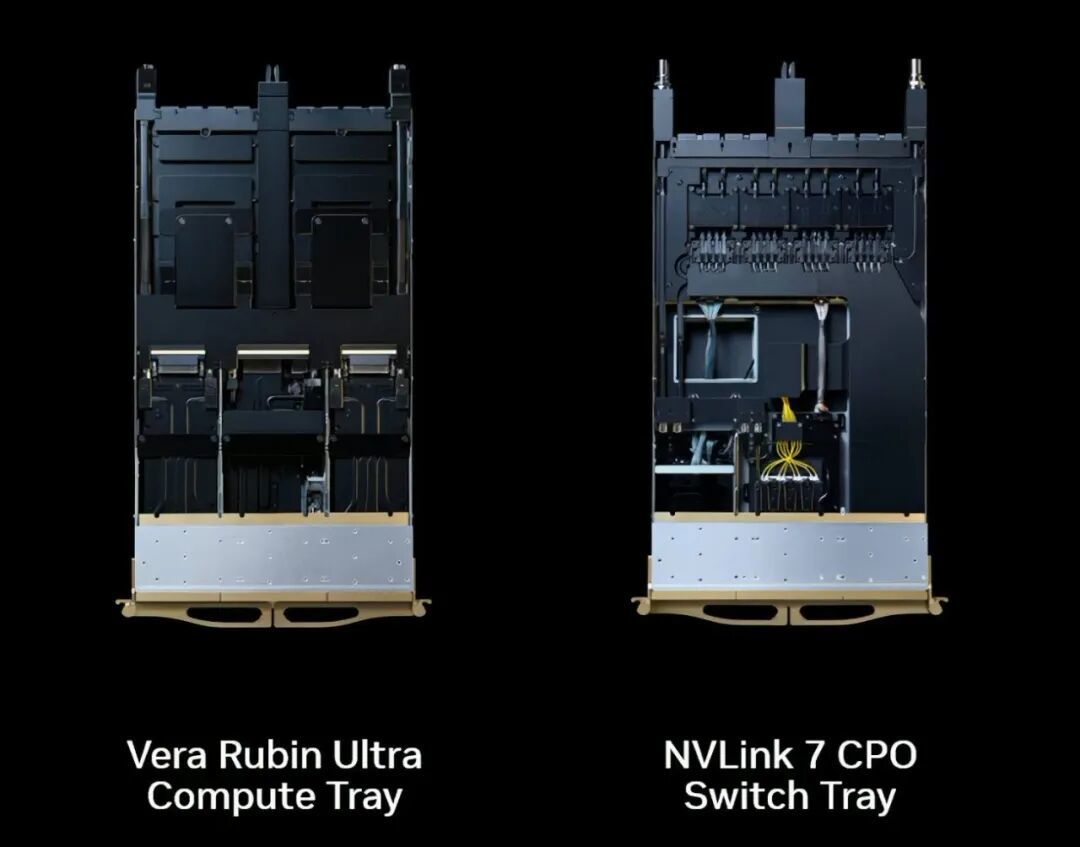
英伟达的Rubin Ultra NVL576 GPU旨在应对规模达10万亿参数以上的超大规模AI模型。此类部署需要巨额资本支出,而英伟达正通过提供DSX Pod等参考设计引领行业,将部署时间从数月缩短至仅14天。
将整个576颗GPU液冷机架视为一个统一超级芯片,其动力来自下一代NVLink和CPO光学技术。
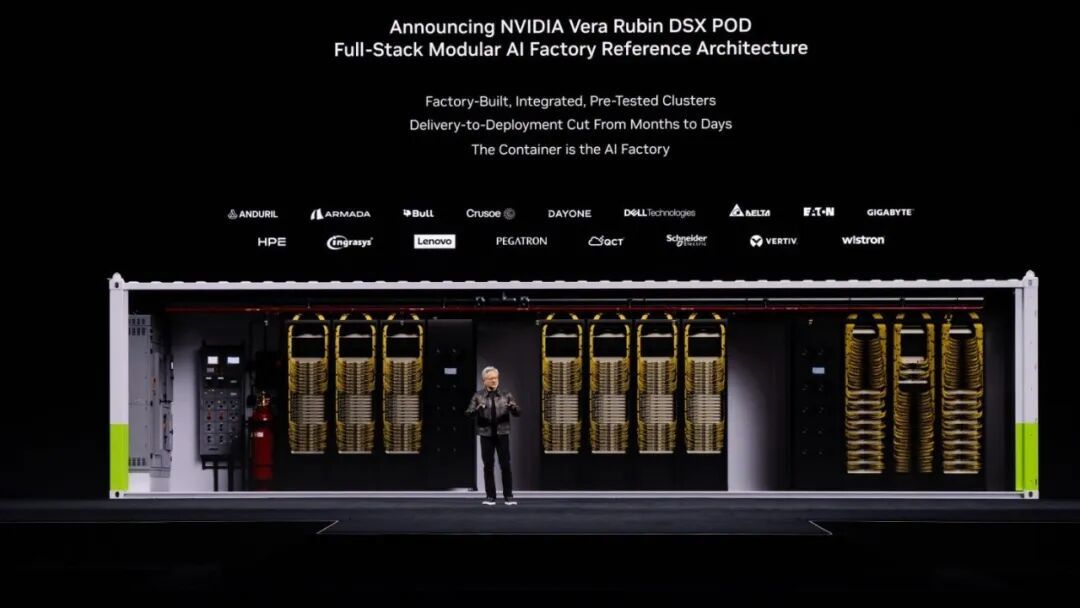
通过融合大规模算力、极致效率和基于OCP标准的模块化设计,英伟达得以提供运行10万亿参数模型所需的每瓦性能和快速部署基础,同时将CPO确立为行业新的互连标准。