上周有个PR在Anthropic跑了一整夜:写代码的是AI,审代码的也是AI,两边来回改了50多轮,最后靠人出手才叫停。
这不是段子,是Claude Code团队自己写进官方博客的坑。10月15日,他们把内部的代码审查流程整个晒了出来。背景数字比段子更夸张:Claude Code自己的代码,约90%由Claude写成;全公司共用的大仓库,每天合并的代码改动5月约2500个,9月超过3万个,四个月翻了12倍。靠人逐行看,根本看不过来。知乎Anthropic官方博客
但6到9月,他们合并的PR翻了一倍多,需要回滚的比例反而降了40%以上。看的人少了,错也少了。微博

核心思路:一摞带洞的奶酪片
每道检查都是一片带洞的奶酪:能拦下一些错,也必然漏掉一些。单看每片都漏,叠多了洞就很难对齐,错误想一路穿到底极难。最底下还有一张"几分钟就能回滚"的网兜着,真漏了也能快速捞回来。
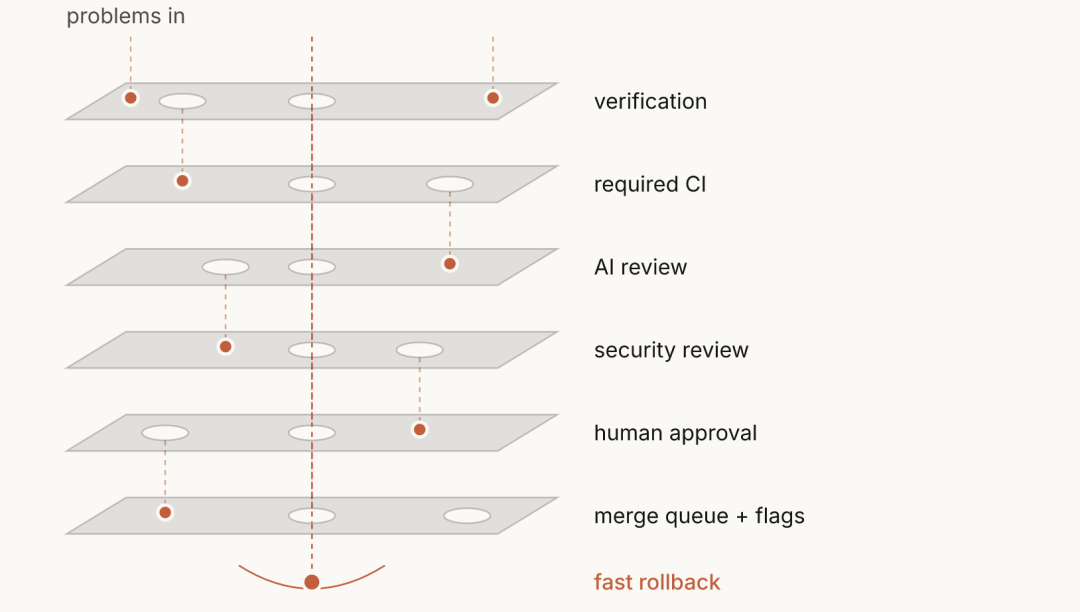
这摞奶酪里,大部分片是机器:AI写完代码,得先自己跑测试、跑构建,把真实输出摆出来,光说"我做完了"不算数;然后再派一个没看过前文的新会话Claude,单独审一遍diff——就像作文写完,找个没参加过讨论的同学来挑错。提交之后,还有多Agent审查加投票过滤误报、独立的安全扫描、合并队列里全量重跑检查、功能开关控制的分批放量。
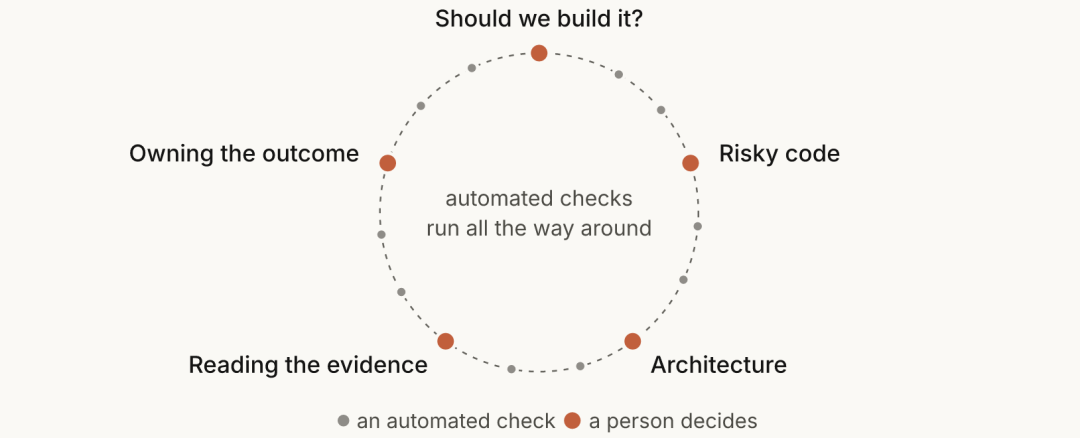
人只出现在最关键的位置,只做5类决定:这事该不该做、高风险代码、会被别人照抄的架构、看懂证据、为结果负责。知乎
几条扎心的规矩
AI的批准,永远不算人的批准;
谁给AI下的指令,谁就是必需的审查人——锅不能甩给模型;
要几个人审,看改动风险不看作者:低风险(文档、文案、开关后面的新功能)0人,中风险1人,高风险2人;敏感路径和CI配置文件,永远要人看。微博
AI审AI没完没了?定个上限
回到开头那个50轮的PR。团队查了下:审查方反复指出的问题,约59%在第一轮时就已经在老代码里了——它很少发现新bug,每轮只是多挖出几个旧的。人看到鸡毛蒜皮的意见,几秒钟划过去;AI会老老实实去改,改完多一个新commit,又触发一轮审查,无限套娃。Anthropic官方博客
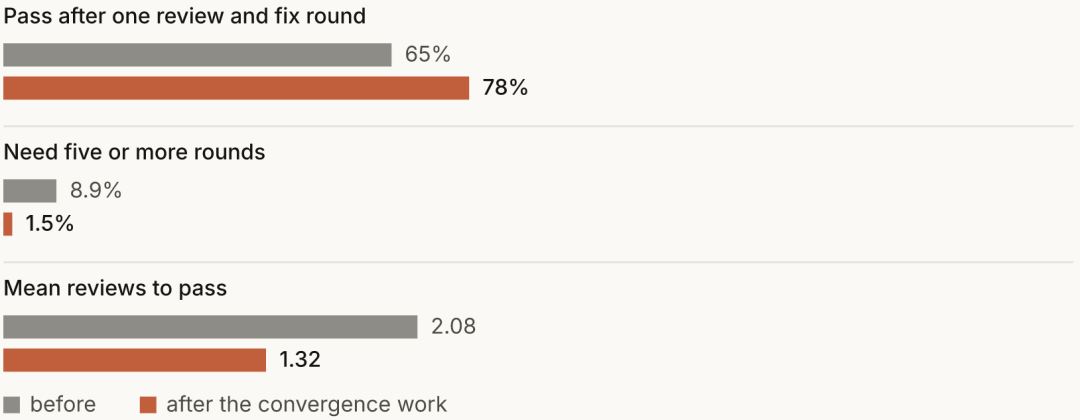
他们的解法很朴素:最多审3轮;超过3轮,让作者退一步重新想方案;之后只审增量diff;提过的问题不再重复。效果立竿见影:一轮就过的PR从65%涨到78%,要5轮以上的从8.9%降到1.5%。微博
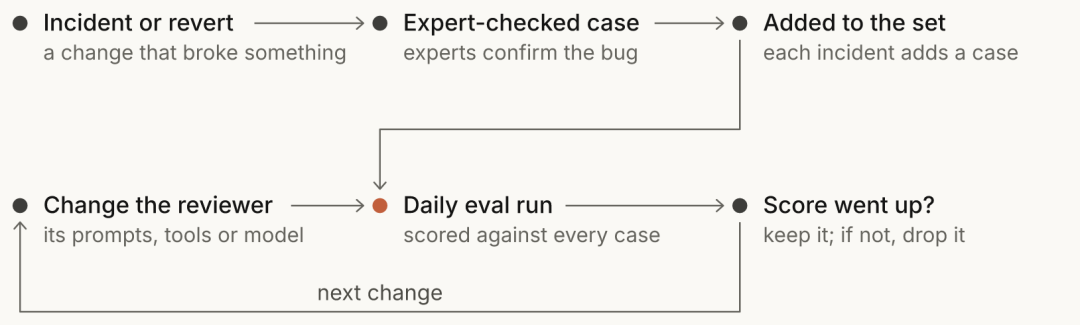
漏掉的洞也不浪费。过去引发过线上事故的PR被收集起来,工程师标注出bug在哪,做成一本"错题集",审查AI每天考一遍;改提示词、换模型,分数涨了才留下。每出一次事故,就多一道题。知乎
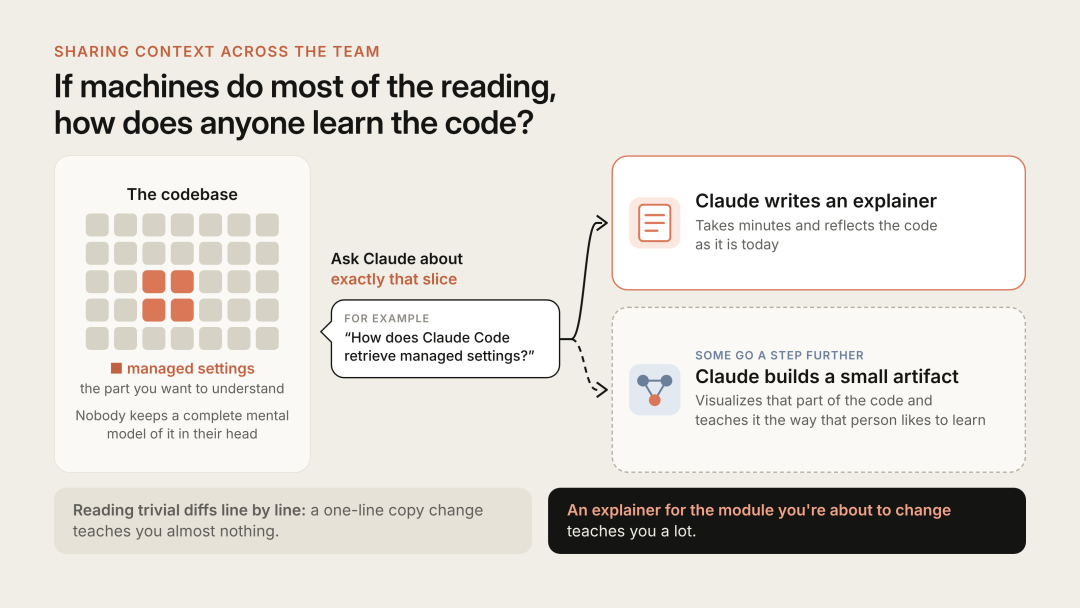
还有个很现实的问题:机器读了大部分代码,人怎么懂代码?团队的答案是——没人需要把全部代码装在脑子里。想弄懂哪一块,就让Claude专门给那块写一份讲解,几分钟就好,讲的还是代码此刻的样子。逐行读一个改文案的diff学不到什么,但马上要动的那块代码,有一份现写讲解,能学到很多。Anthropic官方博客
普通人能抄的作业
不需要Anthropic的基建也能上手,两件事今天就能做:给你的AI写一份CLAUDE.md,说清楚怎么跑测试、有哪些规矩;交代码前,先跑一遍/code-review。Claude Code创始人Boris Cherny有个判断值得抄在墙上:给AI一个验证自己工作的办法,可能是拿到好结果最重要的一件事,他估计能让结果好两到三倍。知乎
最后提醒一句:以上数字全部出自Anthropic自曝,是一家团队的实践,不代表放之四海皆准。但方向已经很清楚——AI写代码之后,人没有失业,只是换了岗:从逐行把关的审稿人,变成做判断、担责任的人。慢下来确实能少犯错,可那主要是因为你做得少了。更快的发现错误、更快的修好,才是这套打法真正想卖的东西。微博