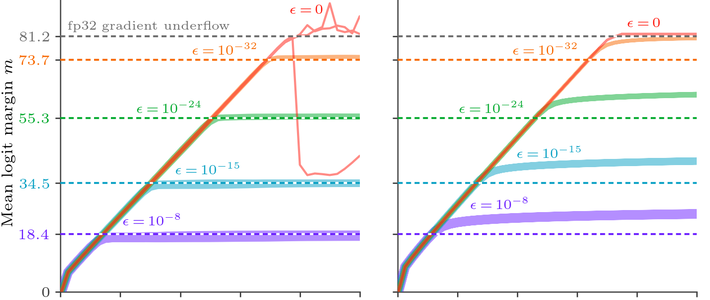
训过模型的人大概都见过这一幕:训练损失在接近 0 的位置躺了很久,突然毫无征兆地飙起来,再跌回去,如此反复。有人给它起了个好听的名字——“弹弓效应(Slingshot)”;更浪漫的解读是,这是模型在"Grokking(顿悟)"前的挣扎。
这周谷歌 DeepMind 的一篇论文把滤镜打碎了:弹弓可能不是什么高级特征,而是一个 bug。深度学习最底层的两个函数 Softmax 和交叉熵,在 PyTorch、JAX、TensorFlow 的标准实现里——也包括大量教科书——一直在特定条件下悄悄把梯度算成绝对零。而按论文作者的说法,最初把这个问题抓出来的,是 Gemini 自己。机器之心
模型越自信,正确的反馈反而消失了
Bug 不在数学定义,在浮点实现。训练分类器时,框架为了防止指数运算溢出,会先把所有 logits 减去最大值再做 softmax——这是几十年来的标准动作。减完之后,分母变成"1 + 一个极小的数"。而这个极小的数取决于模型有多自信:正确答案的分数比别的类高得越多,它就越小。
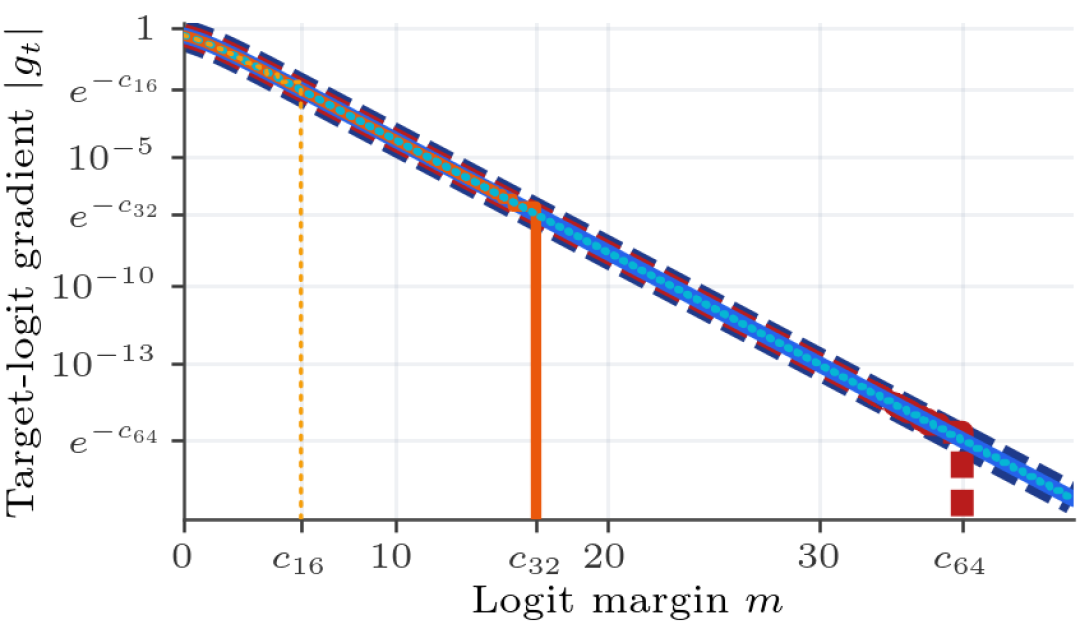
问题在于,数学等价不等于浮点等价。在计算机里,一个足够小的数加到 1.0 上,会被直接四舍五入成 1.0。于是正确类别的概率被算成精确的 1,交叉熵损失变成 0,梯度也变成 0——模型还在学,但正确答案的反馈信号被舍入机制当场抹杀。机器之心报道里给了一个直观例子:三个 logits 取 [9, -9, -9],标准 JAX/Optax 实现算出的损失和梯度都是 0,而修复后的算法给出的损失约为 3.046×10⁻⁸——数字很小,但它维持了"所有类别梯度之和必须为 0"这条数学约束。知乎机器之心
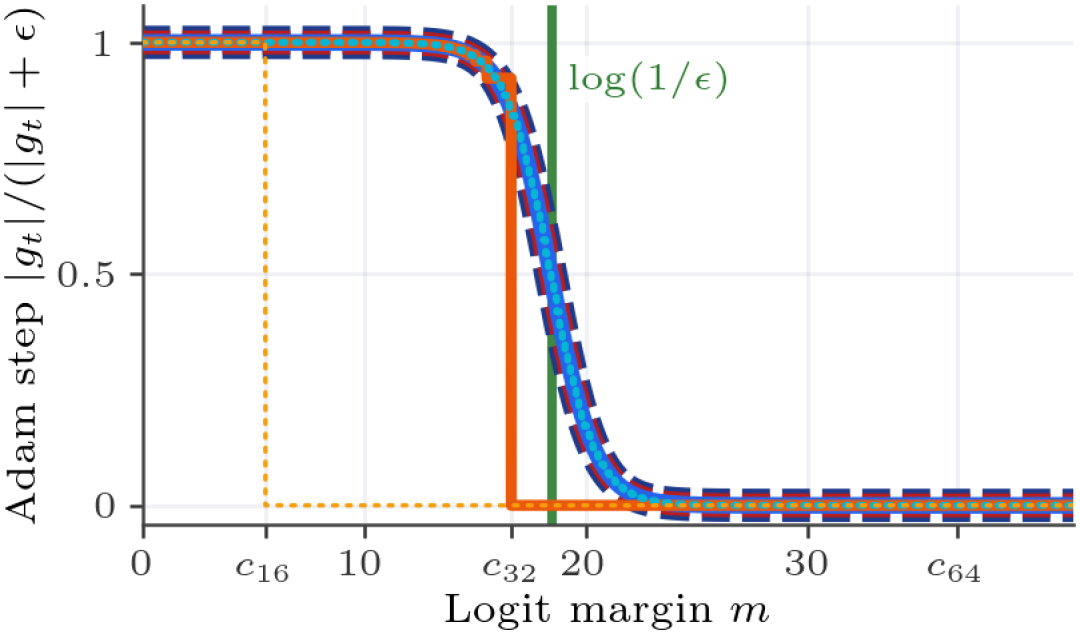
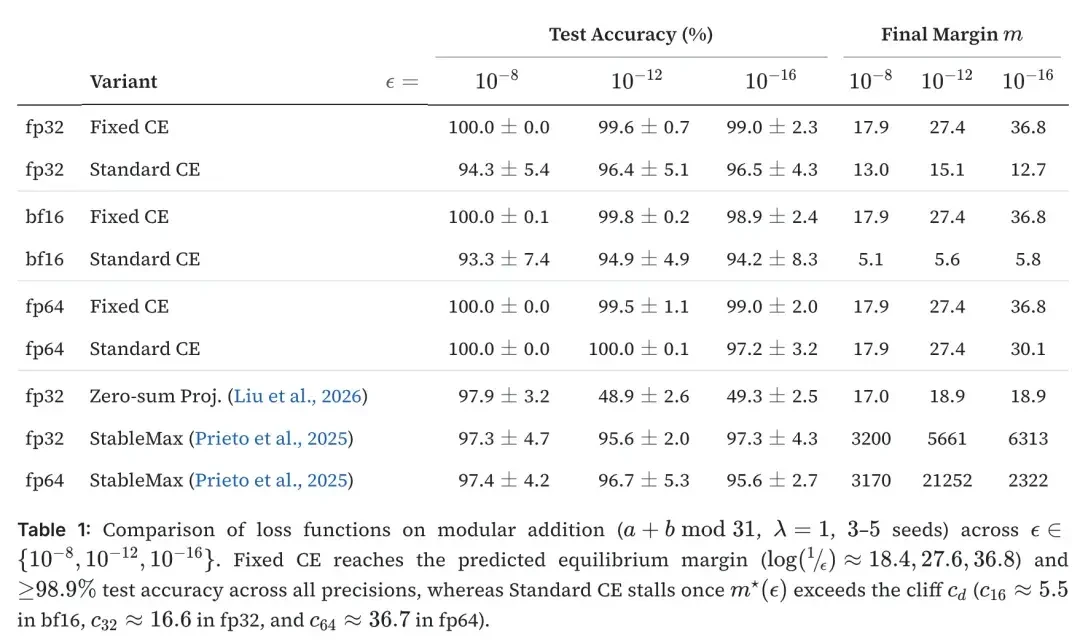
这条线的临界点论文叫"精度悬崖":fp32 下当 logit 差距超过约 16.6 时就会跌下去,此时理论预测概率已经高达 99.9999938%。降级到训练大模型更常用的 bfloat16,悬崖提前到 5.5 左右。越自信,越危险——这大概是今年最黑色幽默的一句话。机器之心36氪
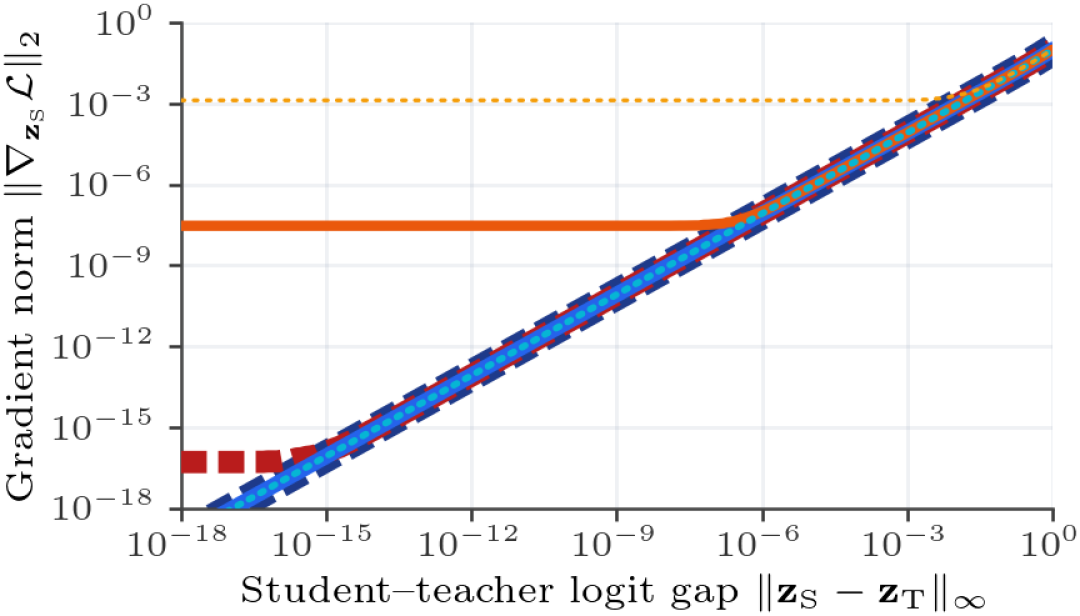
同一个团队还顺手抓了第二个 bug,出在知识蒸馏上:学生模型完全复刻老师时,梯度理论上应该是零,但标准代码分别算概率再相减,舍入误差会留下一个"幽灵梯度",让学生莫名其妙偏离正确答案。36氪
为什么几十年没人抓出来
因为它藏得足够深、后果足够体面。只有在模型训练到很自信的阶段、且用低精度格式时才会触发;触发之后 Adam 会把现象进一步放大——梯度长期归零,优化器里做归一化的二阶矩也跟着衰减,等样本偶然跌回悬崖内、梯度突然恢复时,一次正常更新会被除以一个极小的数,放大成参数猛冲,loss 瞬间飙升。这正好解释了 2022 年 Thilak 等人在 Grokking 研究里反复观察到的"弹弓"。学界以前把它当特征研究,现在论文说:那是 bug 的外显症状。机器之心
不是完全没人发现过。2025 年 Prieto 等人就识别出相关现象,端出了 StableMax 这种"换掉指数函数"的绕路方案。Barron 团队这次选了更直接的办法:把最大 logit 项从指数和里单独拿出来,用数值稳定的 softplus 算负边距,核心原则一句话——“永远不要把一个极小的数字加到 1 上”。改几行代码,不用提精度,不用重设损失函数。论文里的模加法任务(单层 Transformer 学 a+b mod 31)是效果最直白的一栏:bfloat16 下标准实现测试准确率 93.3% 且剧烈不稳定,修复后直接升到 100.0%。机器之心36氪
论文 10 月 22 日提交 arXiv,作者除了 DeepMind 首席研究科学家 Jonathan T. Barron,还有 Dan Gnanapragasam 和 Michael Tschannen。Barron 随后在 X 上官宣了这项研究,10 月 24 日,独立工程师 Satyajit Ghana 在 PyTorch 里做了完整复现、移植了修复,结论是"机制毫无保留地被证实了"。微博技术博主"挨踢牛魔王"那句"世界真是一个草台班子",就是被这条时间线逼出来的。机器之心36氪微博
“AI 抓 AI 的 bug”,几分真、几分炒
这次讨论出圈,靠的是另一个点:抓 bug 的是模型自己。Barron 披露的分工是——Gemini Flash 3.7 发现并修复了这个 bug,论文大部分实验由 Flash 3.8 完成,Gemini 4 Argon 写了论文和图表初稿,他本人"只是极其苛刻地挑刺"。36氪
恰好皮查伊这周做客 BigTechnology 访谈谈"递归自我改进"时,给了同一件事的另一半语境:目前"是智能体协助研究人员开发模型,仍然有人类参与,距离完全自主的递归式自我改进还很远"。他顺带给的配套数字也同样具体:Argon 发布后四周内,谷歌代码变更提交量增加约 30%,回滚次数减少约三分之一。对照着看,这篇论文就是皮查伊那句话最好的标本:AI 干脏活累活,人类负责验收,独立工程师负责第三方复现。所以合理的读法是"AI 参与科研闭环"的首批实锤样本之一,而不是"谷歌已经自我改进起飞"。证据覆盖到哪,结论就只能说到哪——后面那半句现在谁说都算脑补。36氪
对号入座:谁现在就该动手,谁不用
只是日常用 Gemini、AI Studio 的:跟你无关。这个 bug 发生在训练阶段的梯度计算里,推理不受影响,不用做任何事。
在跑训练/微调、尤其是 bfloat16 的:如果你见过 loss 在低位躺平时突然弹尖峰,现在多了一个解释选项;下次起训时可以直接对比论文给的参考实现。论文同时给出了覆盖 Softmax、Log-Softmax 和交叉熵的 JAX 版参考实现。但别给正在跑的实验热切损失函数——换实现会改变数值轨迹,同一份代码训出来的东西就不再可复现了。机器之心
做蒸馏或在线学习的:第二个 bug(幽灵梯度)跟你的关系比第一个更大,学生-教师本该完美对齐的场景现在值得重测。
在学数值计算、准备面试的:把它和 Kahan 求和(1965)、爱国者导弹舍入误差(1991 年 28 名美军丧生)、奔腾 FDIV(英特尔为此计提 4.75 亿美元)排成一条线记。“数字不会凭空消失,它们只是去了你没注意到的地方”——这句是新智元原文的收尾,值得抄进笔记。36氪
接下来要盯什么
三个信号。其一,PyTorch、TensorFlow 会不会跟进合入修复——目前公开可查的参考实现只有论文附的 JAX 版,外加一位独立工程师的 CPU 复现,官方框架侧还没落地。其二,FP4/FP8 这条更激进降精度的路线会不会被波及:微博上已有帖子称 FlashAttention 的反向传播存在同款零和 bug,并说已在 ICLR’27 投稿里修复、解锁了端到端 FP4 训练。但这还是单方宣称,没有第三方复现,先存疑。其三,Barron 团队之后有没有第二篇——一个"AI 找出 AI 底层缺陷"的故事,要么变成系列,要么就只是孤例。微博
至于普通谷歌用户能从这周拿走什么:你那个"模型突然顿悟"的浪漫故事少了一个;而 Gemini 4 上线刚满两周,就先交出了这么一份"AI 帮 AI 打补丁"的答卷。至于是真拐点还是好故事,等上面三个信号出来再下结论。