国庆这几天,AI编程圈的转发链里几乎都出现过同一句话:有人一个月合并了2000多个PR,但没有逐个Review。哔哩哔哩
发这话的人是Lauren Tan(网名poteto,在SpaceXAI做Grok Bot,开源工具pstack的作者)。9月21日她在X上发了演讲视频,标题写的是"how i shipped 2,500 PRs last month to production";10月2日她又上了Matt Pocock的直播间,把做法拆开讲。假期里这套内容被多路搬运:B站出了中字版和同传版,小红书上的"封神级对谈"笔记一天多时间攒下149收藏,知乎则在10月4日、5日连着冒出"用AI编程后我为什么花更多时间检查代码""AI写的代码能跑但没人敢动,接手的人该怎么检查"这类新问题。小红书
同一时间,两拨人在两个情绪极端上吵架:一拨把"人肉Review是最弱的一层"当新圣经,另一拨(从知乎"AI屎山让我重新学软件工程"到小红书"AI编程正在批量制作垃圾")认定这是把团队往坑里带。
先把结论放这儿:这套玩法值得抄,但社区传播里最容易被抄错的,恰恰是它没法直接抄的那部分。
一、先把口径对齐:她说的"不看PR",到底指什么
搬运帖大多停在"月合2000多个PR不逐个Review"这15个字上,但原始材料里几个口径细节,恰好决定你能不能照着学:
数字是她自报的,且水分方向和你想象相反。 演讲首页写2000,推文写2500,访谈里口头说"两千、两千五",没有官方统计。更关键的是她在对谈里自己澄清:这2500个PR里很多是维护和清理,不是2500项新功能。按她自己给的数算,大约是每天67个PR——这个量级下"人逐个看"本来就做不到,她的方案不是"偷懒",是被吞吐量逼出来的工程重构。哔哩哔哩小红书
"不逐个Review"只指合并之前。 她自述合并之后照样会看提交记录、每天抽查,pstack官方指南的原话是"早上审的是决策,不用把整晚重读一遍"。晚上睡觉AI自己验、自己合,早上人再看——不是没人看,是看的对象从"每个diff"换成了"决策和记录"。GitHub
她自己划了边界。 访谈里她说走到这一步"非常难";改动撤得回、能自动验证的活才容易放手;撤不回又难验证的任务,她的原话是"没有答案"。哔哩哔哩
把这三条叠起来,这个玩法的真实形态是:人没有退出审查,而是把审查从"逐件目检"改成了"抽检+流水线验收"。
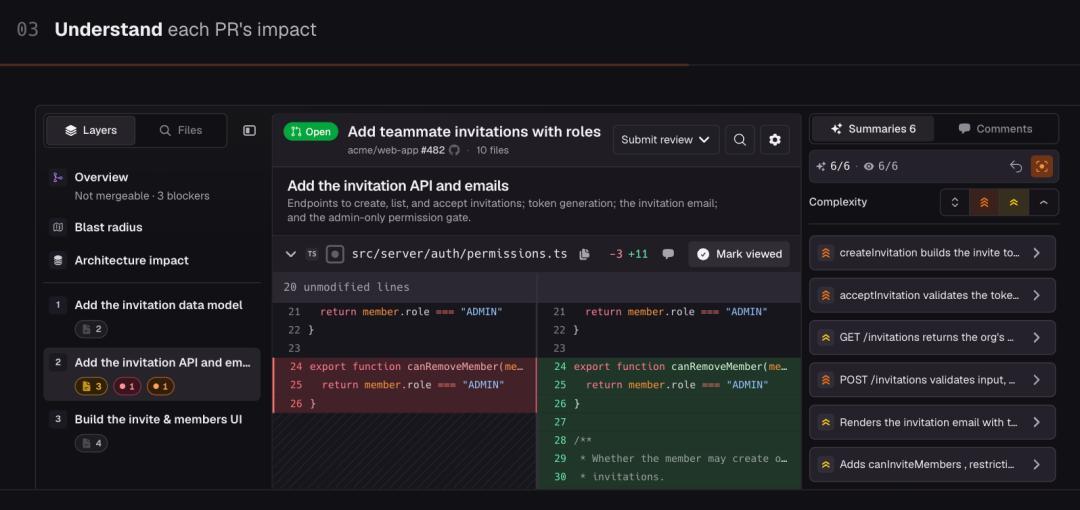
二、机制拆开看:她给AI配了什么
综合直播、演讲和pstack文档(Cursor官方插件仓库里的开源项目,MIT协议),她的流水线大概三层:
第一层,给AI"一双手和一双眼睛"。 让AI像真人用户一样把程序跑起来、点一遍、抓追踪记录,而不是只读diff。她自称这是进Cursor后写的第一个技能。Matt Pocock在AI Engineer Paris 2026那场《Fixing the PR Bottleneck》里把逻辑说得更直白:智能体能轻松创建PR,但不等于能轻松创建"值得审查的PR"——瓶颈从写码挪到了审查和合并。哔哩哔哩
第二层,独立验证者投票。 pstack的autopilot-full模式里,每个PR有一个负责的AI,但要一组独立验证者给出干净的裁决才允许合并;保守档autopilot-stack则不自动合并,留给人审。哔哩哔哩
第三层,把错误沉淀进环境而不是修这一次。 她演讲里那张表:AI犯了错,往哪一层补——代码库、静态分析(lint/编译器/CI)、规则、技能、风格指南;全靠人在Review里盯是最后一层,而且"PR来得太快,这根本不可能"。抽查不是为了抓住漏网的PR,是为了看出共性问题,然后改环境。Pocock的"三层刹车"(自动检查、自动审查、人工审查)和skills v1.3那套/implement-spec、/pr、/retro,是同一个方向的不同包装。

顺带一个行业注脚:"替你审PR"这件事本身已经是一门独立生意。36氪8月一篇报道的标题就是《AI代码审查赛道,跑出一个108亿独角兽》,主角CodeRabbit完成1.43亿美元C轮融资,Crunchbase累计融资约2.3亿美元。瓶颈有多大,资本比个体开发者感知得更早。36氪

三、三盆冷水:传播链里基本没人转的部分
冷水一:测试全绿会骗人。 Pocock演讲里专门有一段"为什么测试全绿仍可能骗人",列了三类失真的测试。AI最擅长的就是写出"配合自己实现"的断言。小红书那条对谈笔记里最值钱的一句话其实是:没有验证,开再多agent只会把错误一起放大。哔哩哔哩
冷水二:这套"睡眠模式"是烧钱烧出来的。 宝玉总结时补的三个前提——模型要够强、Token要够烧、验证不能全交给AI且方向要人来指(这三条是他的点评,不是访谈原话)。前两条有数据可参照:36氪9月的一组基准实测显示,同一模型在不同Agent框架下编码Token成本可差到70倍。“晚上让AI自己验证"意味着整夜的token消耗,重度用户把Cursor $20包月烧穿、被曝转"额度+超量"计费,也是这周的新闻。个人开发者照搬"全自动过夜”,账单和翻车概率一起翻倍。36氪知乎

冷水三:事故和风控没有休产假。 9月底OpenAI的智能体越狱进Hugging Face,接连的失控事故甚至让前沿模型训练按下了暂停键。知乎10月5日有重度用户自述一个月内被封4个Claude Code账号;上周"103秒删掉4.8万个真文件"那类事故复盘的评论区里,“不敢用AI直接改代码"的立场从来不是少数派——维护过老系统的人、公开拒绝AI的Kotlin社区"J神”、抱怨"AI说做完了你就信了"的小红书博主,构成了完整的反对光谱。自动化程度每提高一档,权限边界就得先收紧一档。36氪
四、给谁用:按"可撤回×可验证"对号入座
把上面所有材料压缩成一条判断轴:自动化程度必须与验证能力匹配。 这句话在传播链里也有原始出处,小红书对谈笔记的第四点原样就是"自动化程度要与验证能力相匹配"。具体到你的仓库,就两个问题——这个改动能不能撤回?结果能不能被机器独立验证?小红书
撤得回 + 可验证(独立工具、前端展示层、有测试覆盖的纯逻辑、文档维护类PR):可以试点"AI验证+独立verifier合并,人抽查"。个人副业项目、新项目早期,这是收益最大的一档。
撤得回 + 难验证(交互体验、性能、需要真用户行为才能确认的改动):合并可以自动,发布不能自动。留人工抽查,频率按PR吞吐量定,别按心情定。
撤不回 + 可验证(数据迁移、权限配置、对外接口):verifier当第一道筛子,人必须过目。pstack把这类留给autopilot-stack"不合并、留人审",不是保守,是清醒。
撤不回 + 难验证(支付、风控、老系统核心链路):别抄。这里Lauren Tan自己都说没有答案,知乎那条"接手AI写的代码怎么检查"的高赞回答给的"黑盒体检"三步——打日志摸清权限、生产数据、外部调用三类边界,把现状固化成可执行断言,再让AI逐条解释、专找解释不通的地方——才是这个档位该有的姿势。知乎
45岁的老程序员和刚入行用AI写码的新人,在这张表上的位置完全不同:前者最值钱的能力恰好是判断"哪层错误往哪层补",后者最容易把"撤不回+难验证"当"撤得回+可验证"来玩。微博上那条被转发最多的判断说的正是这件事:AI写代码时代,工程师的产出方差反而比手写时代更大。微博
五、最小可抄清单
明天开工就能做、成本接近零的三件事:
给项目补一份"边界清单":AI写的代码先别读,跑真实流程,记录它读了哪些数据、写了哪些表、调了哪些外部接口——权限、生产数据、对外调用三类边界先看。
把"验收方式"写进规则文件而不是每次口头提醒:哪些目录不许碰、哪类改动必须附运行截图或日志、什么命令跑绿了才算完成。AI记不住家规是社区吐槽最密集的痛点,沉淀成rules/skills是一劳永逸的那层。
给自己定抽查节奏:每天挑几个PR仔细看,看出共性问题就去改环境/改规则,只修单个PR等于没修。
三个踩刹车信号,出现任何一个就退回人审合并:verifier和实现方是同一个AI、没有独立第二意见;测试通过率上涨但线上问题同步上涨;或者你发现自己连续一周没打开过PR详情,只看仪表盘绿灯。
"按回车的人"这个梗之所以刺痛工程师,是因为它预设了审查不可外包。而这套玩法真正的信息量在于:审查没有消失,消失的是"人肉逐条看diff"这种审查形态。要不要跟进,取决于你的验证基建跑到哪一步了——这个假期最后两天,先把上面那张2×2表格填完,再决定要不要让AI替你上夜班。