经常用AI干正经活的人,大概率都遇到过两种情况:一是模型思路跑偏了,你在对话框里怎么纠正都掰不回来,它一边道歉一边继续犯同样的错;二是聊得太久之后,AI肉眼可见地"变傻",车轱辘话来回说,前面定好的条件也忘了。
对付这两个问题,圈子里流传的统一解法一直很玄学:别废话,直接重开一个新对话。就像十几年前电脑卡死了直接重启,没人说得清原理,但就是管用。知乎
10月5日,微软研究院挂出一篇论文《Fork-and-Flush: Escaping Idea Basins in Autoresearch Agents》,把"重启大法"做了系统实验验证。两周后,中文互联网给它起了个爆款标题——“微软最新研究:Agent的长记忆可能是毒药”,在知乎、微博、小红书刷屏。这篇论文到底说了什么、没说什么,值得掰开看看,因为这两件事同样重要。知乎36氪小红书
同一个AI、同一个任务,跑8次差了31.7分
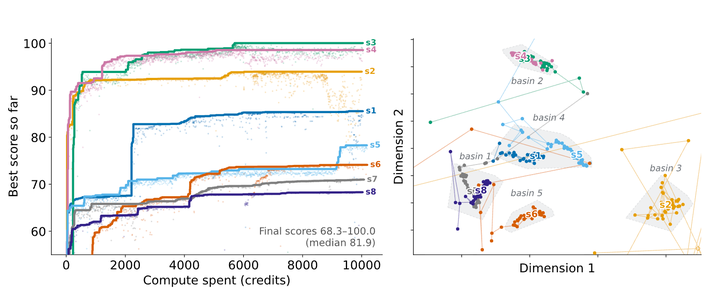
研究团队盯上的是一种"自动做研究"的Agent:提方案、跑实验、看分数、再改方案,一轮接一轮,一跑就是几小时甚至上百小时。他们让同一个Agent在同一个任务上独立跑8次,按理说结果应该差不多——实际最终分数从68.3排到100.0,最差和最好差了31.7分。更扎心的是,给落后的那几次追加算力,差距也基本补不回来,每条轨迹都爬到自己的高度就平了。36氪知乎
为什么?团队把每次运行产出的方案按"功能相似度"投影成一张二维地图,发现每条轨迹都缩在地图的一小块区域里打转,从头到尾没怎么挪窝。8次运行,掉进了5个互不相干的区域。论文给这种区域起了个名字:想法盆地(idea basin)——Agent早期形成的思路就像盆地,后续所有修改、补丁、优化都在盆地里打转,爬不出来。小红书
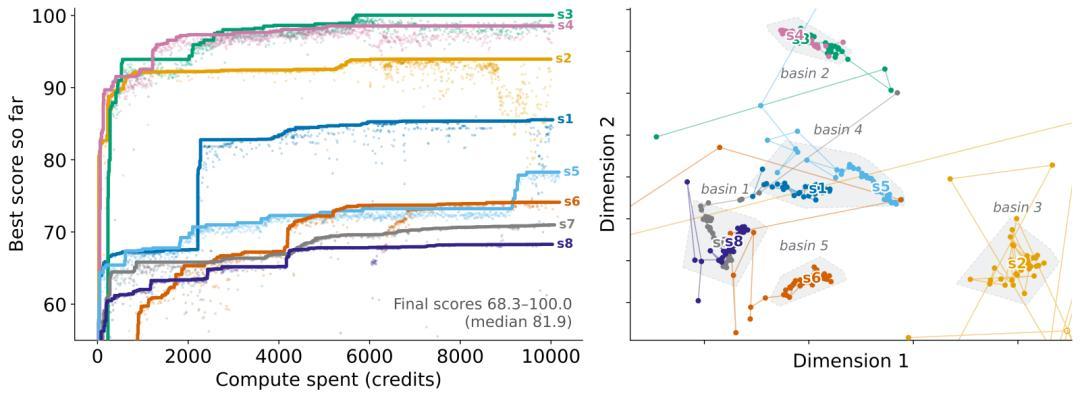
而把Agent困在盆地里的"引力",论文指向了不断变长的聊天记录:累积的对话轨迹会把下一步锚定在早先的推理上。哪怕Agent自带"上下文压缩"机制、定期把历史总结成摘要,也照样跳不出盆地——论文原话是insufficient(不够用):摘要压掉的是长度,压不掉方向,只要摘要里还写着"当前采用方案A",锚定就还在。知乎
药方:文件全带走,聊天记录全扔掉
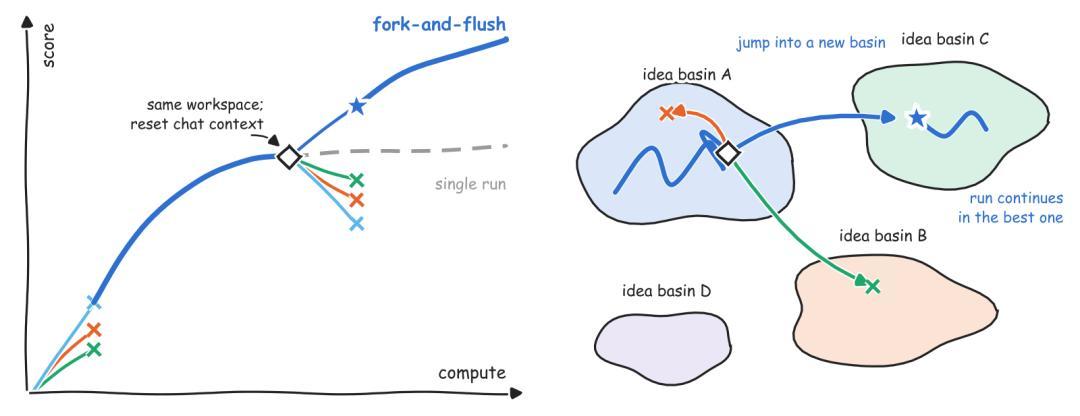
论文的方法叫Fork-and-Flush(分叉+清空),操作思路是把Agent的状态拆成两半:
W(工作区):写好的代码、文件、实验结果——这些是干出来的活,分叉时原样带走;
C(聊天上下文):一路聊过来的推理过程、失败尝试——这些是想过的路,全部清空。
具体流程:从同一份工作区拉出4个并行分支,每个分支的聊天记录清零,从空白对话重新出发(其中两个还被额外提示"换一种思路"),跑一段固定预算后比分,留最好的继续,其余解散。论文里有句话说得很到位:新分支必须从文件里重新推导出自己的意图,这正是它能落到另一个盆地的原因。知乎36氪
效果最戏剧化的一次发生在拼图任务上:预算烧到71%时触发清空,胜出的b3分支第一次提交就跨出了43个单位的距离——而单跑的Agent到这个阶段每步最多挪4.4个单位。这一跳直接落进全新盆地,最终拿下93.9分,比8次单跑的中位数84.6高出一截。36氪
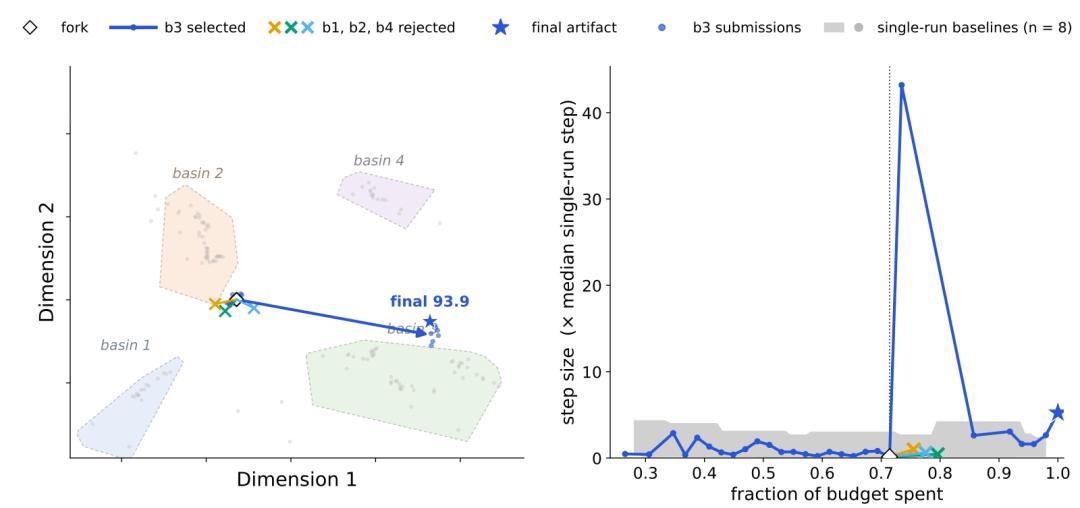
但注意,同一次实验里另外3个清空重开的分支并没有跳出去,每步挪动不超过1个单位,原地留守。清空是一张有用的牌,不是万能钥匙——它提高的是跳出去的概率,保证不了结果。知乎
数据:0.47→0.78,但别只看平均数
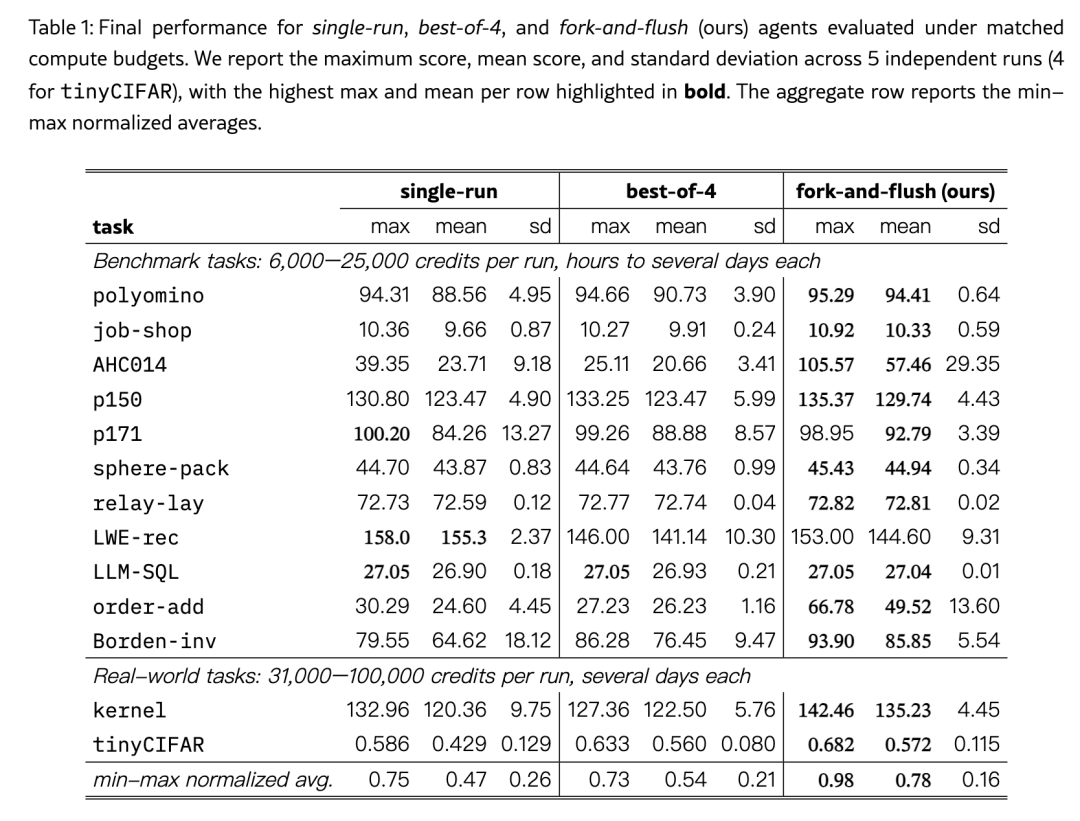
主实验覆盖13个长周期任务(多连块拼图、车间调度、密码破译、压缩图像分类器、内核优化),模型是GPT-5.6-terra和GPT-5.5,统一通过GitHub Copilot CLI调用,算力预算相同。归一化平均分:单跑0.47,跑四次取最好的best-of-4是0.54,Fork-and-Flush达到0.78——比"多跑几次挑最好"这条常规路子还高44.4%,13个任务里12个排第一,标准差还从0.26降到0.16,发挥更稳。36氪
消融实验(11个任务子集)拆得更细:单跑0.45,只清空聊天不分叉0.55(提升约22%),只分叉不清空0.57,两样一起做0.71。两半都在起作用,组合才最强。知乎
不过把任务逐个摊开看,故事没那么完美:只清空对话在11个任务里有5个反而低于单跑,均值的上涨主要靠两个"踮踮脚够得着"的难任务拉动(一个从123.47涨到160.80)。论文第六节给了边界解释:团队用Qwen3.5的三个尺寸在MAX-3-SAT上做难度扫描,发现运行间差异呈倒U型——题太简单大家都做对,太难大家都做不出,差异最大的位置恰好在模型能力边缘,峰值落在"能做对一半"附近(0.497)。换句话说,清空对话对卡在能力边缘的任务增益最大,对模型已经熟练的任务可能反而有害。作者的判断是:模型继续变强,这个现象也不会消失,只是边缘会挪到更难的问题上。知乎36氪
核查时间:论文里"poison"出现了0次
现在说回那个爆款标题。有知乎答主把论文PDF转成纯文本搜了两遍:"long memory"出现0次,"poison"出现0次。全文唯一一次出现memory,还是在第七节的否定句里——这套方法"跨任务不携带任何记忆,也不更新权重"。知乎
论文研究的是单次运行内部越积越长的对话历史,从头到尾没有碰"跨会话持久记忆":没有研究记忆库,也没有做重置持久记忆的对照实验。所以"长记忆是毒药"这个更强的命题,这篇论文提供不了直接证据。传播链条大致是:10月16日公众号"大数据文摘"发稿用了"毒药"标题,36氪授权转载,随后知乎、微博、小红书跟进发酵——媒体标题和论文正文之间,隔了一层转述。顺带一提,流传的"8次运行中位数81.9"在论文统计表里也找不到,更稳的口径是68.3~100.0这个区间。36氪知乎
那"越聊越笨"的体感是不是编的?也不是,只是证据在论文外面,而且分两条线。第一条是方向锚定,就是上面说的盆地机制。第二条是注意力稀释:Anthropic在工程博客里把上下文比作有限的"注意力预算",每塞进一个新token都在消耗它;Chroma的技术报告测了18个前沿模型、19.4万次调用,发现把全量聊天历史(约11.3万token)塞给模型,比只给相关轮次(约300 token)表现更差,哪怕只加一个干扰项成绩都会低于基线;微软自己和Salesforce合作的多轮对话研究(ICLR 2026杰出论文)测了15个模型、超20万次模拟对话,发现完整多轮对话比拆成单轮平均差39%——拆开看更有意思:能力只降了16%且不显著,不可靠性却涨了112%。也就是说,长对话未必让AI变笨,更多是让它忽好忽坏:同样的指令,今天顺明天翻车,中间差的那部分,常常是历史把模型带进了不同的局部状态。知乎
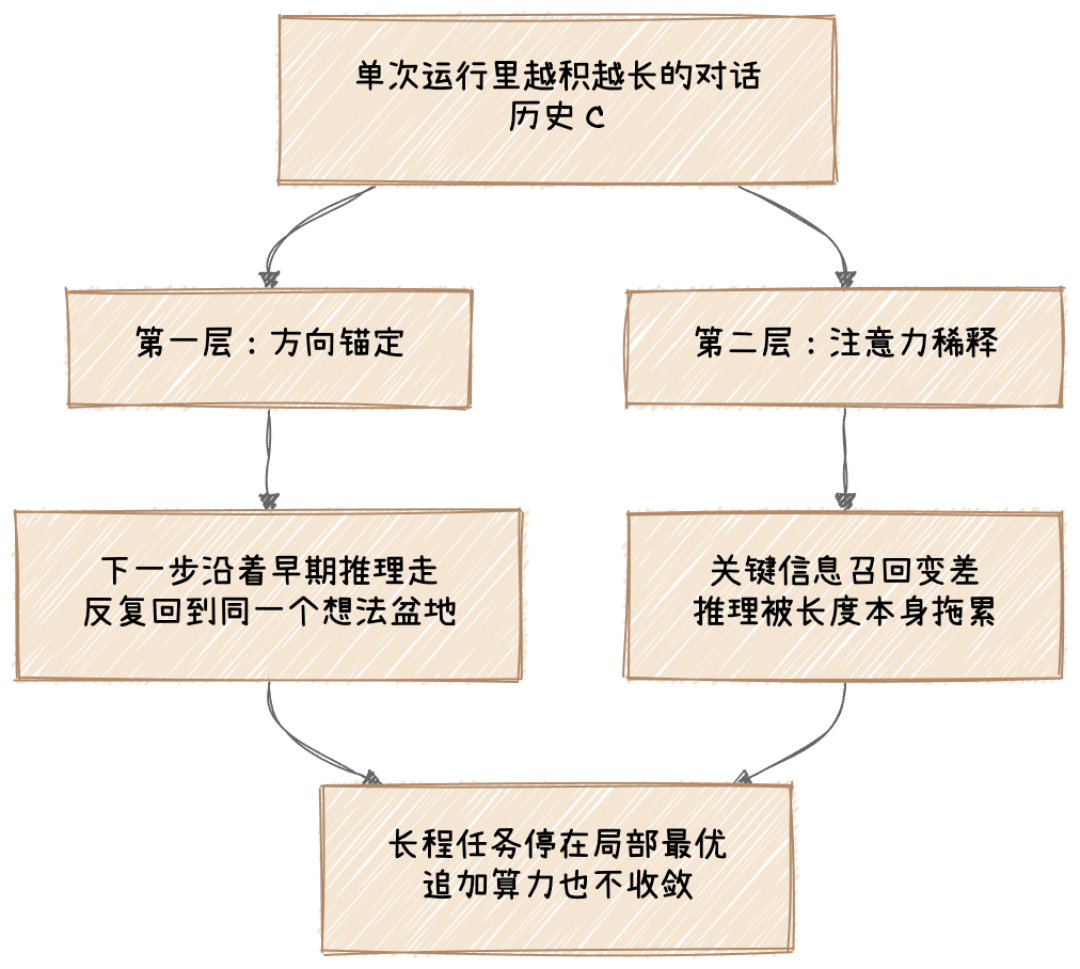
三条能直接用的建议
把上面的材料落成操作,对日常用Copilot、Cursor、Claude这类工具的人:
第一,卡住了就重开对话,但要"带着资产重开"。 论文里新分支从来不是裸奔:任务说明、工作流文档、已验证成果的位置,一样不少地交给新分支。日常照做就行——重开前让AI把当前进度、已确认需求、已完成产出写成一份摘要(或存进文件),新对话第一句贴回去。口诀是:把聊过什么忘掉,把做出来什么留下。知乎
第二,别把压缩当清空。 很多人以为让AI"总结一下上文"就够了,论文实测这招insufficient:摘要只要还保留着当前方案的方向,锚定就还在。要清的是推理轨迹的连续性,不是字数。36氪
第三,记忆功能不用恐慌性关闭,但别指望它救场。 论文没有证明跨会话记忆有害,让它记住格式偏好、命名习惯没问题;但一个已经跑偏的任务,靠的是重开,不是记忆。另外记住能力边缘这条边界:简单熟练的任务频繁清空可能反而降分,重开这招留给真正卡住的时刻。知乎
最后,留两个观察信号
这篇论文本身还有几分成色要交代:arXiv v1预印本、未经同行评审、每条件5次运行、技术栈单一(Copilot CLI 1.0.73 + GPT-5.x),换个模型框架收益未必复现。接下来值得盯两件事:一是微软会不会把Fork-and-Flush产品化进Copilot——比如官方的"分支探索"或"自动重开会话",那这个技巧就从手动挡变自动挡;二是其他团队在不同Agent框架上的复现结果,如果多框架验证一致,"定期清上下文"大概率会成为下一代AI工具的标配设计。知乎
在那之前,先用好这个零成本技巧:下次AI开始胡言乱语,别跟它吵——重开对话,把需求和成果贴回去。重启大法,现在有论文撑腰了,也有论文划的边界了。