10 月 14 日,阿里 Qwen 团队开源了面向视觉智能体的 3D 创作基准 BlenderWorld,给 AI 出了一套 3D 建模大考:223 个任务,判分依据是 2,651 条逐条二元判定的标准。 和"生成一张好看的图"不同,这场考试要求 AI 在 Blender 里交付一个可继续编辑的 .blend 工程文件,并按需输出渲染图、视频或模型导出文件。 考试难度已经写进成绩:13 个前沿模型同台参赛,GPT-6-Astra 领跑全场。 但即便是榜首,把全部标准一次性通过的任务也还不到半数。GitHub新浪科技BlenderWorld项目官网
2,651 条标准不是平均分配:绝大多数躲不掉
拆开看,这 2,651 条标准的分布很不均匀。官方数据集统计图显示,它们分属 13 个评分维度:功能(Function)660 条、几何(Geometry)446 条、构图 310 条、材质 291 条、灯光 203 条、空间布局 157 条,其后是整体印象、布局、物理、尺度、存在感、数量、颜色各 26 到 156 条。换算下来,平均一道题约对应 12 条标准;任务按产品、建筑、自然环境、角色、动画、科学可视化等 9 大类、22 个子类展开。 每条标准只有过与不过两种结果,并按重要性分为 1、2、3 三档权重。 权重分布比看上去严苛:权重 3 的高权标准占 83.3%,权重 2 占 14.9%,最低档权重 1 只有 1.8%。也就是说,绝大多数要求都是"必答且高分值"的,靠少量亮点拉分的空间很小。新浪科技GitHub
更难的一层是没法按考纲复习。任务简报、参考素材和附件只交给答题的智能体,评分标准在生成阶段全程保密,评测检验的是交付的工程是否真正逐条满足要求。BlenderWorld项目官网
判的是"能不能用",不是"好不好看"
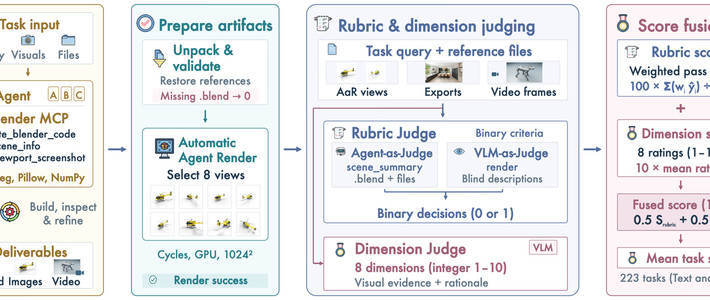
评分由两类裁判分工完成:场景结构类标准交给 Agent-as-Judge,用 Blender 工具直接读取 .blend 工程来查;外观类标准和八项整体视觉维度交给 VLM,依据渲染图和视频帧来判。 这意味着想靠渲染一张漂亮画面蒙混过关行不通——层级、材质、灯光、相机必须真实存在且经得起检查。GitHub
渲染环节同样有工程化约束:独立渲染代理选 8 个自适应视角,以 Cycles 1024×1024、64 采样保留原场景渲染,每个视角最多允许两次纠偏性重渲;提交件里的原始图像与抽样动画帧再作为补充证据。GitHub
最终成绩由两半合成:规则符合度按加权通过率折算百分制,视觉质量取场景保真、物理合理性、风格与配色、真实感、空间布局、比例与尺度、光照与材质、完整性八个维度的 1-10 分均值,两者各占 50%。 没有交上 .blend 或评测失败的提交直接记零分,并且留在计分分母里——逃题、弃答都换不来体面分数。新浪科技GitHub
榜单拆解:丢分丢在三处
第一处,高分不满贯。满贯通过率的梯度非常陡:GPT-6-Astra 42.2%,Opus-5 掉到 25.6%,GPT-5.6-Sol 15.7%,DeepSeek-V4.1-Flash 11.7%,Qwen3.8-Max 10.3%;垫底的 Gemini-3.8-Flash 和 MiniMax-M3 只有 0.45%——223 道题里仅 1 道题通过了全部标准。BlenderWorld项目官网
第二处,达标但不精。规则分与视觉分的差距暴露了质量短板:GPT-6-Astra 规则符合度 87.3 分,视觉质量只有 72.6 分;Opus-5 是 80.9 对 65.1,两项分差近 15 分。头部模型基本学会了"把要求做全",画面却在灯光、材质、真实感上仍欠火候。
第三处,多模态拖累。基准里 78 题纯文字、130 题图文、15 题视频加文字,多数模型在带视觉参考的任务上反而更低:Opus-5 从纯文字 74.8 降到多模态 72.1,GPT-5.6-Sol 从 71.7 降到 65.5,Grok-4.6 从 60.0 降到 55.4;只有榜首 GPT-6-Astra 在图文与视频输入上反超,高出 Opus-5 达 8.6 分。 分品类看,最难啃的是自然风景(13 模型均分 49.4)、角色与生物(49.9)、动态艺术(51.8),得分最高的反而是程序化与游戏资产(63.0)。几何规则清晰、拓扑规整是 AI 的舒适区;复杂自然形态、角色解剖和动画时序,才是真正的硬骨头。BlenderWorld项目官网
Qwen 为什么要出这样一套题
任务几乎全部来自真实生产需求:11 大应用场景就覆盖了 213 题,其中分镜脚本 35 题、产品发布 21 题、电商视觉 20 题;另有 59 题附带 Markdown、YAML、JSON 格式的尺寸、材质或相机参数规格文件。 换句话说,BlenderWorld 想测的是从"读懂需求—操作生产工具—交付可接手资产"的端到端能力,而不是单点的 3D 生成效果。GitHub
裁判本身的可信度也做过验证:主自动裁判 GPT-5.6-terra 在 147 组可形成多数人类偏好的对比中,与人类偏好一致率为 82.99%。 这套基准的工程门槛也不低:生成需 Linux、Blender 4.2.10,评测还需 Node.js 22.17、ffmpeg 与一个可调用的视觉模型服务,但任何生成框架都可以接入跑分。 Qwen 自家的模型也在榜单里接受检验:Qwen3.8-Max 得分 60.6 排第五,Qwen3.8-27B 得分 47.7 排第十,与榜首仍有 19 分以上的差距。BlenderWorld项目官网GitHub
BlenderWorld 的"难",难在把 3D 生成评测从"比图片"改成了"验收工程":可编辑的交付物、2,651 条加权标准的逐项过与不过、全程保密的评分细则、零分进分母的计分规则。79.9 分的榜首与 42.2% 的满贯通过率说明,"把要求做完"已经接近天花板,"做得好看、改得动、接得住"仍在路上。