九月中旬,本地部署圈情绪最浓的词是"眼红"。
Qwen3.8-27B开源刚满月,8月14日放出权重时就号称一张4090能跑,月底Flash、GLM-5.3-Flash接连开源,这一周Flash-Next又进入端侧实测期,于是所有人都在晒速度。晒速度的帖子里,一边是V100配NVFP4加DFlash2喊出"280 token/s"、2080Ti晒"220t/s吞吐的峰值";另一边,一位拿RX580的网友晒出自己的战报:64k上下文、IQ3_XS量化、KV缓存q8,让模型生成一个38k token的HTML页面,跑了29个小时,平均0.4 t/s。哔哩哔哩哔哩哔哩
同一个模型,相差约700倍。
我把B站、知乎、微博、小红书和GitHub上到9月15日为止的15份公开实测(含视频简介、评论区带配置的自测、开源项目的结果图表)对了一遍,先给结论:这些速度数字大多没有造假,但其中至少一半说的不是你理解的那个"速度",另一半则附了一张不会写在标题里的账单。
一、"速度"有三套口径,多数人只听了第一套
第一套:单用户出字速度,还是服务器总吞吐。 知乎那篇双卡80G Hopper压测里,MTP2在8并发下反超其他方案、总吞吐冲到约996 tok/s,而同机单用户短请求跑MTP7也只有199.61 tok/s。再看V100那条"逆天输出280token/s"的视频,标题只说了故事的一半——项目README给出的条件是4张V100-16GB组TP4、约260 tok/s,并且自家写着这句免责话:这是实机演示标题,不是通用的固定解码速度。知乎GitHub
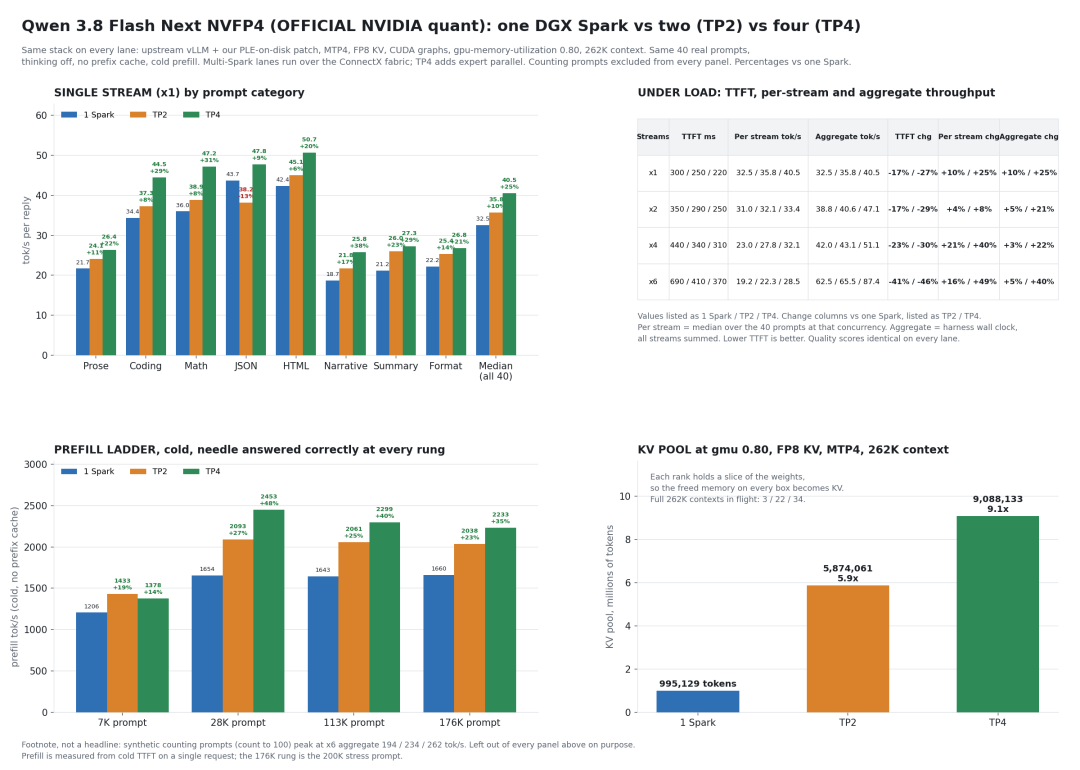
真正单卡单用户的人均体感在哪儿?微博有人用V100 PCIe OEM板跑27B:持续输出约30 tok/s,开MTP能到40+。同一件事在GitHub上还有更直白的版本:MiaAI那个"单台DGX Spark跑Flash-Next"项目实测,单流48.7 tok/s,8个并发流一起打的"聚合吞吐"能报到162.9——但你要是其中一个用户,拿到的只有二十几。微博GitHub
第二套:峰值还是持续。 2080Ti那条晒速视频的标题里,自己就带着"220t/s吞吐的峰值"这几个字。而28G双卡那位网友的曲线是:刚开聊50 tps,上下文涨到200k后只剩17tps上下——27B的速度是一条随上下文往下掉的曲线,不是一个数。哔哩哔哩
第三套:数字前面得先挂档位。 IQ2、IQ4_XS、NVFP4、FP8、bf16,每一个都"叫27B"。同一个16G显存,评论区网友自测IQ4速度10左右、IQ3能到20左右。看晒速帖,先找他写的量化格式,没有格式的"XX t/s"当段子看就行。哔哩哔哩
二、真正卡住你的四个瓶颈,显卡只排第一
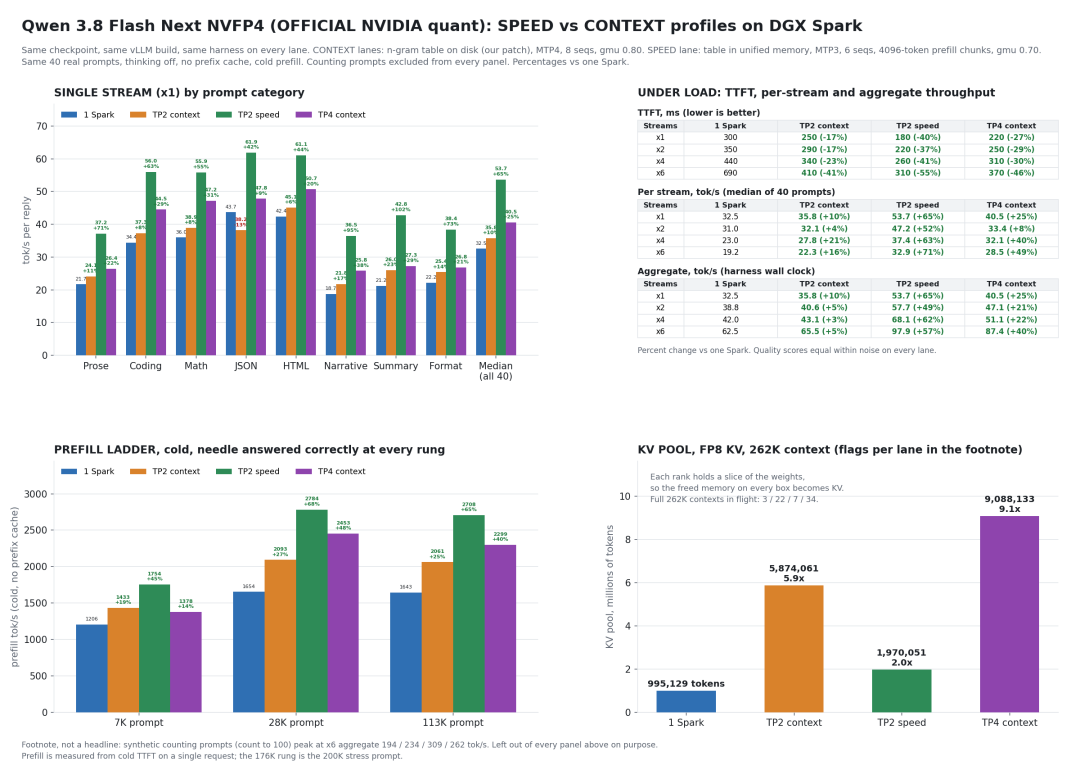
1. 显存席位之争。 这轮社区最重要的新认知:席位是权重、KV缓存、推测解码草稿层三方抢出来的。8G实测视频的评论区里,5090用户的原话是"NVFP4+262k上下文已经没有足够的显存载入MTP了,开了只剩9k,啥也干不了"。显存被压到极限时,同样出自这楼评论区的判断是:MTP层会被挤出显存,“加载在现存内的激活参数反而要等草稿输出再校验”,于是出现了那条被两百多人点赞的反常识提醒:关掉mtp再试试,说不定反而更快。推测解码在显存吃紧时是负收益,整合包教程不会告诉你这个。另一头,有人干脆把显存余量换算成了明码标价的"席位表":同一台Spark调KV池参数,token池能在25万到117万之间浮动;单台Spark跑262K上下文的并发只有3席,组到四卡才有34席。哔哩哔哩
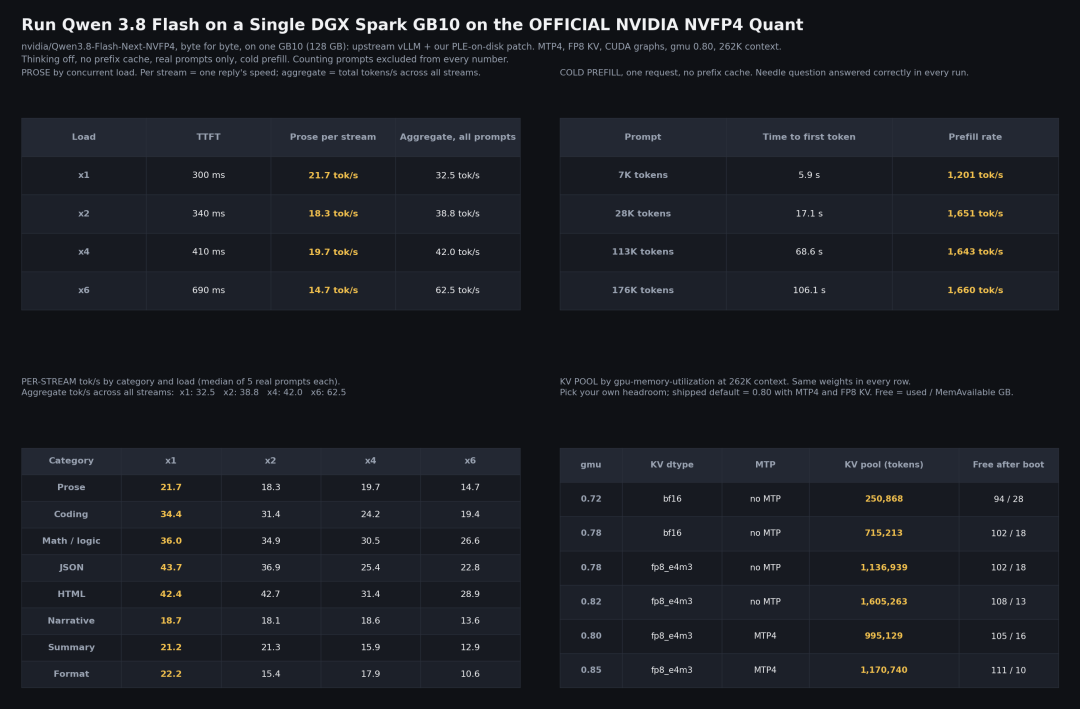
2. prefill(读题)才是Agent党的墙。 晒出IQ4实测的那位28G双卡网友补了一句更扎心的数据:100k上下文预填要4分多钟,200k接近14分钟,而且上下文越大推理越慢——在harness里触发auto-compact就得干等。单台Spark这边,两个开源项目各自留了数:冷prefill 113K输入约64秒,512K上下文的首token延迟260秒起步——四个多分钟,只是等第一个字。 Hopper压测同样发现,输入到32K时,时间大头已经从decode转向prefill,推测解码的提速收益只剩约20%。很多人"嫌模型慢",其实是读题慢,不是吐字慢,这时候去优化解码就是白折腾。哔哩哔哩GitHub知乎
3. 接受率:投机器是个押注,不是稳赢。 MTP7不等于每轮出7个token,它只是每轮最多押7个草稿,Hopper实测一轮真正被采纳的平均只有约3.3~3.8个,押得大错得也多,8并发下反而输给保守的MTP2。单台Spark上的独立样本给出了几乎一样的数:MTP4整体接受率64%、平均每轮被采纳3.56个token。两个完全不同的硬件环境收敛到同一个接受长度,这不是巧合,是这类模型的物理特性。知乎GitHub
4. 思考剂量。 “动不动就思考半天"是27B慢的另一副面孔。8G方案的视频里写得很直白:极端量化不要无脑开思考,容易触发token溢出、无限循环。有人干脆花三周做后训练"赛博治疗”,终于把27B治疗成了一个想的更少、能力不掉、不死循环的"家用"模型(视频近4万播放、2284收藏,是27B区收藏密度最高的内容之一)。剂量这件事,已经成了这个模型的独立玄学。微博哔哩哔哩哔哩哔哩
三、五种加速姿势,账单各不同
① 极限量化(IQ2/IQ3)。 速度确实高一截,但8G实测视频的评论区把丑话说在了前头:IQ4_XS,玩玩得了,别真把生产工程跑这玩意儿上。小红书有人晒"Flash-Next本地部署速度猛增",自己在评论区补了一句:虽然速度起来了,但我又换回了bf16的27B。哔哩哔哩小红书
② NVFP4。 三个常见误解要拆开:一,"NVFP4"不等于全模型4bit,平均每值约4.5bit,容量收益接近3.5倍而不是4倍,routed experts和大体积PLE查找表用NVFP4、dense层走MXFP8、敏感层留高精度,是一套混合方案。知乎
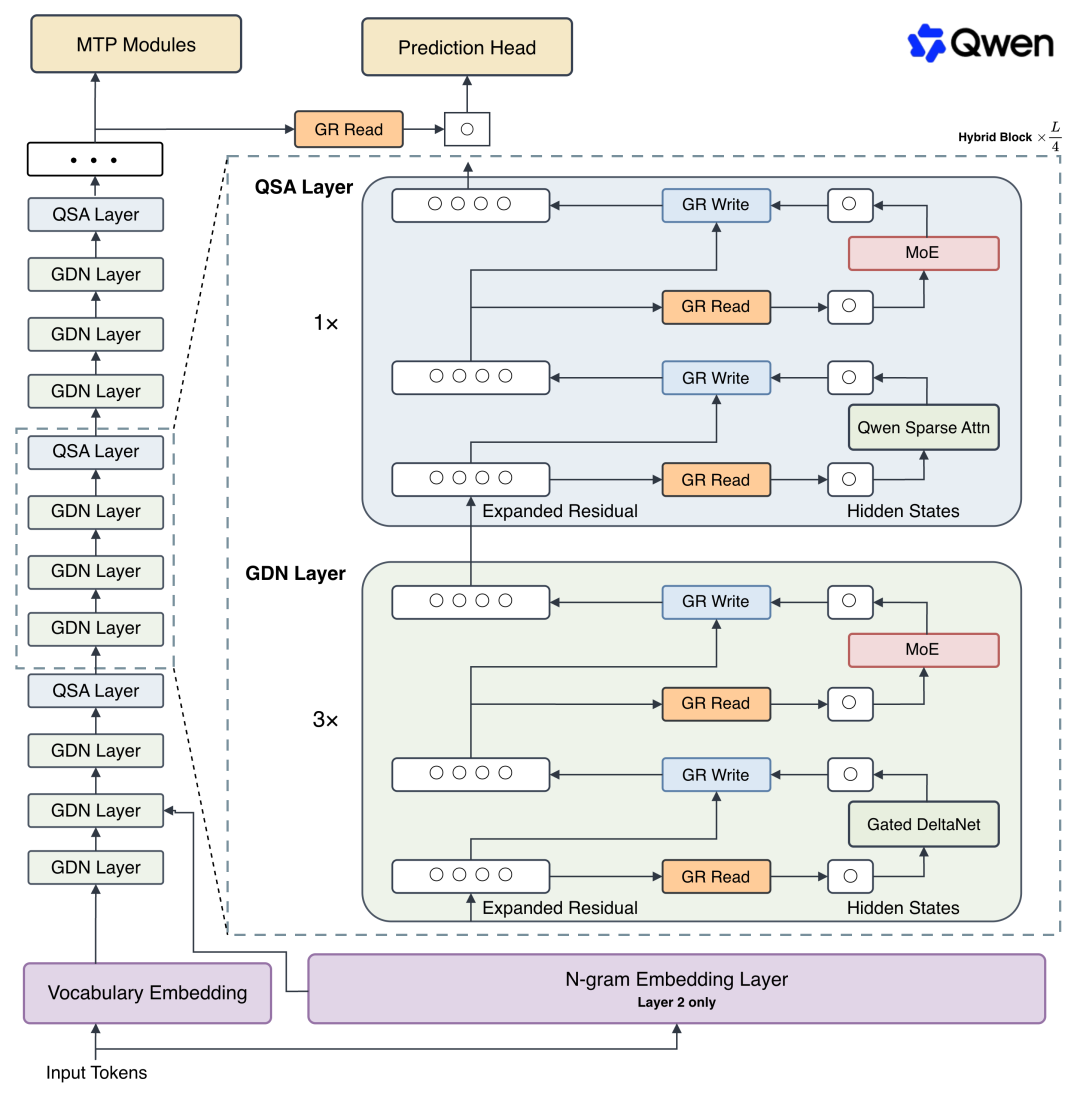
二,Flash-Next真正能进单台DGX Spark的关键,是把约51B参数的n-gram嵌入表压到26.8GiB,让整个checkpoint进入约100GB级——省的是容量和带宽,不是算力。 vLLM官方配方页对它的定性也是"125B主模型、外加51B n-gram嵌入、每token激活6B"。三,V100这类老卡没有NVFP4硬件加速,是"转成FP16算"加手搓内核,社区为它算不算"真NVFP4"已经吵了几百楼;而它相对官方checkpoint的质量A/B至今没人做。知乎vLLM Recipes
③ MTP/DFlash。 高配单卡收益几十个百分点;显存紧的卡是负收益(见上);连在2080Ti上晒出220t/s的UP主都在简介里自曝:微调dflash适配中文后,工具调用出现了问题。加速中文场景,先赔上一个工具调用。顺带一提,Spark项目作者自己用8条真实prompt做MTP3对MTP4的A/B,结果是平手(中位31.8对30.6)——草稿层不是玄学,是要在你自己的负载上重测的东西。哔哩哔哩GitHub
④ GSQ/RCO新格式。 320B级别的GLM-5.3-Flash用3.5bit格式跑起来,国外教程刚出、B站中字刚上(9月15日),国内样本几乎没有——尝鲜区,观望不丢人。哔哩哔哩
⑤ 统一内存阵营(AMD 395/DGX Spark)。 实测数据最诚实:128G UMA能装下"总参180B、激活6B"的Flash-Next并256K拉满,AD量化把54.5GB权重驻内存、38.4GB放SSD实时调度,解码约21 t/s——超过人眼阅读速度。另一个单Spark项目报的中位数是43.9 tok/s,和评论区网友晒的"40多"互相咬合,这个生态位的真实速度就是"能用、不快"。想快怎么办?加机器:双Spark中位提速约10%、四卡约25%,但同一张实测图的另一半写着——速度档配置会把KV池优势砍掉大半,你的"快"和"长上下文"只能二选一。装得下、跑得快、聊得长,在这个阵营里是三件事。知乎GitHub
四、晒速度之前,先看这张最贵的账单:权重安全
慢雾8月底的威胁情报:一个伪装成"Qwen3.8-27B本地量化模型"的GitHub仓库,487KB的"权重"ZIP里没有权重,是LuaJIT解释器加混淆Lua脚本——收集主机信息、截屏、回连C2,最终落到StealC窃密木马。同批复检还发现分布在23个仓库里的29份同类恶意ZIP,诱饵覆盖AI模型、MCP服务、开发脚本。你花一万块配4090是为了省token钱,结果去搜一张封面写着"IQ3XS终极家用版"的整合包,泄露的是整台机器。规则就一条:权重只走官方仓库或社区公认的镜像,来源不明的"整合包"三个字不是担保,是鱼饵。微博
五、按档位对号入座:9月15日这天的版本答案
8G显存:27B是体验卡不是生产力,IQ2写小说可以,别跑Agent、别开MTP;真想干活换35B-A3B这类激活3B的MoE——8G笔记本卡的网友实测NVFP4版35B-A3B稳定21tps,比强蹬27B体面得多。哔哩哔哩
16-24G:IQ4/FP8+限制思考预算,10-50t/s够读够写;先解决上下文管理,再谈解码优化。
24-32G/双卡:FP8+MTP2性价比最高;别追200k长上下文,prefill会先教你做人。
3-4人小团队:vLLM MTP2做默认——Hopper压测对它的原话是"不是每一项都第一,却在吞吐、接受率、长上下文和并发稳定性之间取得了更好的平衡"。知乎
128G UMA/盯Spark的:Flash-Next装得上,但单流中位四十多、512K首字等4分钟起步是真实体感;NVFP4质量A/B没人做完,生产任务先别交给它。
继续观察的信号:端侧部署系列后续有没有放官方vs第三方checkpoint的质量对比;DFlash2那个4并发反常数据会不会被复测;5090/Pro6000档"260k上下文+MTP共存"的方案有没有人跑通;V100那类"转FP16算"的手搓路线有没有人把质量损失量出来。
尾声
下次首页再刷到"XX t/s跑疯27B",先别眼红,问它四个问题:几张卡、几并发、多长上下文、峰值还是持续。这四个问题答不上来,它的速度就跟你没关系——但它的账单,大概率会算到你头上。