近年来,人工智能技术在视频生成领域取得了显著进展,正从生成几秒钟的单一、零碎镜头,向着输出逻辑连贯、内容自洽的叙事短片方向迈进。其中,阿里推出的通义万相(Wan)系列视频模型,特别是其2.6版本,展示了向“电影级”专业生成能力靠近的潜力,让“用AI拍电影”这一概念变得愈发触手可及。
通义万相Wan2.6模型的核心突破在于它更注重视频的“叙事完整性”与“角色一致性”。以往的AI视频往往是片段化的,难以形成一个连贯的故事。而新模型能够生成长达15秒的视频,并且具备了多镜头自动切换的能力。这意味着用户只需输入一段剧本或创意指令,AI便能自动设计包含全景、近景、特写等不同镜头的组合,并确保镜头切换流畅、逻辑连贯,最终生成一个具有基本叙事结构的小短片,向真正的影视制作逻辑迈出了一步。
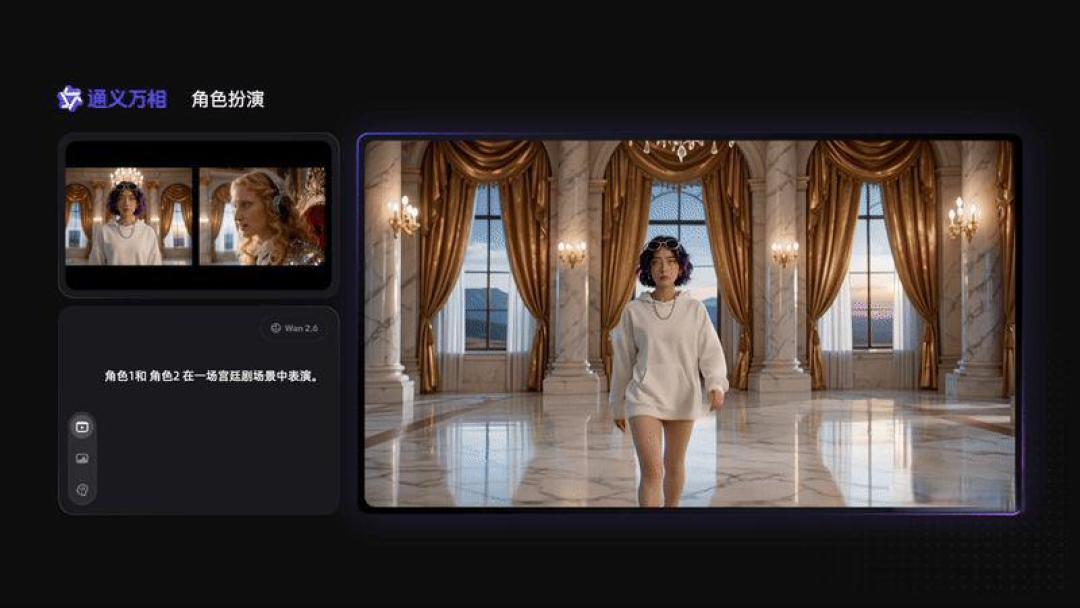
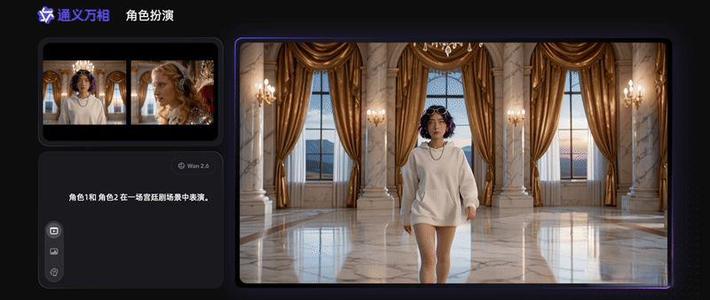
该模型最受关注的亮点之一是其在国内率先支持的“角色扮演”功能。用户可以上传一张照片或一段视频作为参考,AI能够精准复刻其中人物的相貌、神态甚至微表情,并将其“投放”到全新的故事情节中。在多镜头的切换过程中,这个“角色”能保持高度的一致性,不会出现前一个镜头是A、后一个镜头就变成B的“换脸”问题。这一能力解决了AI视频创作中长期存在的“人物不固定”的痛点,使得围绕特定主角展开连续剧情成为可能,普通人也能将自己或朋友变成AI短剧的主角。

此外,音画同步是实现“电影感”的另一关键要素。Wan2.6模型在这方面也表现出色,它不仅能生成与画面内容匹配的背景音乐和音效,还能实现人物口型与台词的精准对应。在一些展示中,模型甚至可以根据用户提供的音频来驱动视频画面的生成,让声音驱动画面,画面回应声音,从而达到意境合一的效果。无论是单人独白还是多人对话场景,模型都能稳定生成,让整个故事的情感表达更加饱满。

这项技术已通过千问App中的“AI小剧场”等功能向公众开放,并且提供免费使用。用户无需专业的设备和复杂的后期制作技能,仅凭一个灵感和简单的文字指令,就能将脑海中的故事变为现实。这极大地降低了视频创作的门槛,让创意和想象力本身成为最重要的生产力。
当然,当前技术生成的视频在细节上仍有提升空间,例如部分复杂画面中的文字可能模糊,或角色声音有时略带机械感。但通义万相Wan2.6模型所代表的技术进步,标志着AI视频正在从单纯的技术展示,转变为一个普通人也能轻松上手的实用创作工具。它让“人人都是导演”的时代不再只是一句口号,而是正在发生的现实。