





 深耕AI、数码兴趣领域


93
35
今日AI圈值得关注的动态 2026年11月04日
2026-11-04 08:56:35
0点赞
0收藏
0评论
11月4日,AI 圈几个动静值得拎出来说说。挑了十条我觉得信息量和落地价值都比较实在的——有开源大模型的、有资本层面的、也有政策和算力底座的,逐条讲下发生了什么、为什么值得留意。
月之暗面 Kimi K3.1 Pro 今天正式开源全部权重
月之暗面发布 Kimi K3.1 Pro,采用 2.8 万亿参数的 MoE 架构(每 token 激活约 1040 亿),支持百万级 token 上下文,主打编程、金融研究与 3D 设计;在 Terminal-Bench 这类"真干活"基准上,成绩领先 GPT-6 Astra、仅次于 Claude Opus 5.5。API 定价每百万输入 token 2 美元、输出 10 美元,11 月 4 日按计划开源全部权重,成为开放权重模型里排名最靠前的递归模型之一。
**解读:**开源完整权重这件事,比参数本身更值得看。过去国产前沿模型大多只开 API 或开部分权重,K3.1 Pro 把 2.8 万亿参数的完整权重放出来,意味着企业和开发者能本地部署、审计、微调——对银行、医疗这类数据不能出域的行业是直接利好。加上 Terminal-Bench 这种 agentic 编程基准成绩靠前,它不是来卷榜单的,是冲着"自己写代码、本地跑得动"这个真实需求来的。
出处:汇总 今日头条《AI 每日新闻简报》(据月之暗面官方公告)原文链接
Anthropic 更新招股书:三季度收入同比增 1127%,算力承诺近 9000 亿美元
Anthropic 更新招股书披露,第三季度收入 169.56 亿美元,同比增长 1127%,净亏损 232.91 亿美元;前三季度调整后营业利润 40.81 亿美元,经营现金流转正;年贡献超 10 万美元的客户逾 1.19 万家。更惊人的是算力侧——算力采购与租赁累计承诺约 8954 亿美元(约 6.02 万亿元),据报道公司目标在 11 月 16 日当周上市。
**解读:**这组数字把"AI 赚钱"和"AI 烧钱"两头都摊开了。收入翻十倍说明企业级需求是真的,但近 9000 亿美元的算力承诺也说明,模型公司的命门早已不在算法,而在算力供给和资金链。对普通用户的影响很直接:当头部厂商自己都在为算力账单发愁,订阅涨价、额度收紧几乎是迟早的事,别把工作流全押在单一闭源服务上。
出处:腾讯研究院 AI 速递(搜狐)原文链接
MIT 用 GPT-6 Astra 做"权重空间编程",改写 Qwen 权重让数学准确率升约 6 倍
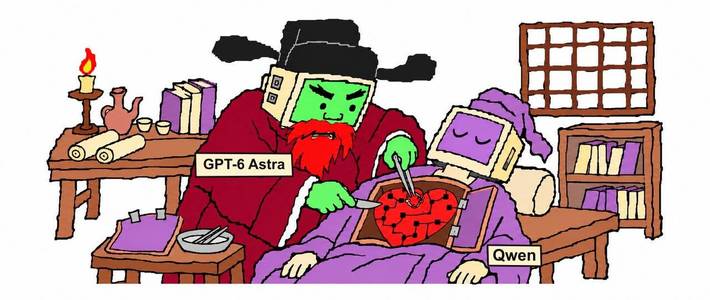
MIT CSAIL 公布八项实验,测试用 GPT-6 Astra 直接读写神经网络权重,称之为"权重空间编程"——不靠梯度训练,仅修改 Qwen3.5-0.8B 约 0.016% 的权重就减少了推理循环,MATH-500 准确率由 7.9% 升至 48.1%,IFEval 由 21.0% 升至 62.3%;它仅凭权重就认出了四款游戏,从零编写的游戏网络得分超过了 PPO 训练 1 亿步的网络。也有 Meta 研究员质疑,提示词可能已提前引导了排查方向。
**解读:**这条看着很学术,但指向一个有意思的方向:未来调模型不一定非得重新训练,而是让更强的模型直接去"改"小模型的参数,像改代码一样改权重。如果这条路被验证可靠,小模型的定制成本会大幅下探。不过现在样本还小、且有人质疑实验设计,先当"有可能性"看待,别急着当结论。
出处:腾讯研究院 AI 速递(搜狐)原文链接
马斯克坦言 Grok Bot 成本扛不住,用户实测周额度缩水近半
11 月 1 日 Grok Bot 额度条出现异常跳动,多扣部分退回后,马斯克公开称其服务成本相对收入"高得扛不住"。两位 Cursor Pro+ 用户实测测算,每 1% 周额度可用 token 从约 730 万、690 万降到了约 390 万、370 万;10 月初其付费周活已达 80 万,环比翻倍多。Grok 网页版还新增了支付宝付款,Premium 首月 15 美元、之后每月 30 美元,但 Plus 档不含 Grok Bot。
**解读:**这跟上面 Anthropic 的算力账单是同一个故事的两面——前端用户增长越快,后端的推理成本窟窿越大。额度悄悄缩水这种事,往往比直接涨价更让用户难受。想长期用某个 AI 编程/对话产品的,最好留个心眼,把关键工作流的导出和迁移方案提前备好。
出处:腾讯研究院 AI 速递(搜狐)原文链接
中国拟推 AI 安全标准,覆盖"研发到部署"全生命周期
11 月 4 日,Techmeme 转引彭博社报道称,中国计划推出一套覆盖面较广的 AI 安全标准,覆盖从开发到部署的环节,重点面向国内 AI 模型厂商。报道指出,监管触点会明显前移和后移:前移到训练数据来源、模型开发流程、安全评测和供应链管理,后移到 API 服务、运行监测、事件响应和持续审计。云厂商、算力提供方、行业用户都将被纳入同一条安全责任链。
**解读:**这不是一条单纯的"又要监管了"的消息,而是 AI 治理从"上线备案"走向"全生命周期安全"的信号。对做模型的公司,意味着安全能力得嵌进研发流程、部署环境要可控、出事要能追溯;对云和算力厂商,则要从"卖 GPU"变成"提供安全运行的环境"。短期是合规成本,长期会抬高行业门槛、利好有全栈能力的大厂。
出处:网易·通信世界原文链接
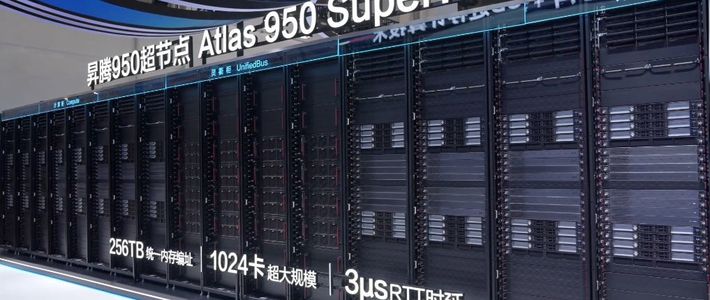
华为昇腾 950 超节点获世界互联网大会领先科技奖
在世界互联网大会乌镇峰会上,华为昇腾 950 超节点拿下领先科技奖。单节点集成 1024 张加速卡、支持 256TB 统一内存编址,面向万亿参数训练与中心高并发推理,被视作国产算力底座的代表性成果。
**解读:**国产算力这条线最近存在感很强。昇腾 950 的价值不只在单卡性能,而在"超节点"这种把上千张卡和超大内存池打包成一体、能扛万亿级训练的工程能力——这正是训练大模型最缺的"系统级"底座。国产模型想摆脱对进口卡的依赖,这类超节点能不能稳定跑通大规模训练,是关键一役。
出处:汇总 搜狐《今日AI行业热点速览》(据世界互联网大会官方发布)原文链接
DeepSeek V5 计划基于昇腾芯片预训练,"国芯训国模"进入实质阶段
产业链人士称,DeepSeek 下一代大模型 V5 将从推理侧走向训练侧,首次把预训练跑在国产超节点上,标志"国芯训国模"从口号进入实质阶段。
**解读:**这条和上面昇腾获奖是同一个大趋势的两块拼图。过去国产芯片大多先支撑推理、再慢慢碰训练,而预训练是算力消耗最大、对互连和稳定性最挑剔的环节。如果 DeepSeek 真把 V5 的预训练放在国产超节点上跑通,那"用国产卡训出国产前沿模型"就不再是演示,而是可复制的工程事实——这对整个国产 AI 供应链的意义,比单一模型发布更重。
出处:汇总 搜狐《今日AI行业热点速览》(据产业链人士消息)原文链接
商汤发布 SenseNova 6.8 Flash 正式版,把记忆和 3D 创作端进来
商汤推出日日新 SenseNova 6.8 Flash 正式版(11 月 3 日发布,11 月 4 日多家媒体跟进),重点升级了长期记忆和跨会话任务协作,解决多轮对话里上下文丢失的痛点;设计生成能力扩展到动态 PPT、动态海报、网页、SVG 以及 Blender 3D 创作,并能接入 Figma 等专业设计工作流。
**解读:**这类"Flash 正式版"的看点通常不是参数,而是能不能真进生产力流程。长期记忆 + 跨会话协作,意味着它开始尝试补上 AI 助手最被人诟病的"聊完就忘";而把 SVG、3D、PPT 都接进设计工作流,是想从"聊天工具"变成"设计搭子"。对做内容、做方案的普通人,这类模型比纯聊天更有用,值得实际试一把。
出处:汇总 微信「早上好AI」早间新闻(据商汤官方发布,原始发布日 11 月 3 日)原文链接
百度 Apollo World 具身世界模型首次披露,已用于萝卜快跑
在 11 月 3 日的百度 AI Day 上,百度 Apollo 首次披露面向物理 AI 的智能体驱动全模态世界模型 Apollo World,并提出"世界模型 2+3"判断标准。该模型把虚拟场景里所有交通参与者都建模成具备决策与交互能力的 AI 智能体,支持无人车在复杂动态环境中预测与决策,目前已用于萝卜快跑的全球化测试与验证。
**解读:**世界模型是今年自动驾驶和机器人圈的高频词,但大多还停在论文里。Apollo World 的特殊处在于它已经接进萝卜快跑的真实测试——用"会思考的交通参与者"去模拟真实路况,等于给无人车造了个低成本的训练场。如果这类世界模型真能替代一部分实车路测,自动驾驶的迭代速度会被明显拉快。
出处:汇总 微信「早上好AI」早间新闻(据百度 AI Day 官方,原始发布日 11 月 3 日)原文链接
OpenAI 拟采购谷歌 TPU,甲骨文也扩大与 OpenAI 合作
据知情人士,OpenAI 计划采购 Alphabet 旗下 TPU 以扩充算力底座,若敲定将是谷歌芯片对外销售的重大突破——双方的合作在 16 个月内完成了"租用算力—公开测试—直接采购"三级跳。另一边,甲骨文在 Oracle AI World 宣布与 OpenAI 扩大合作,推出 AI Workspace、Security Mesh、App Composer 等四款企业 AI 产品,并将于明年起在云中提供 TPU。
**解读:**这条说明一件事:连 OpenAI 这样的头部厂商也在给自己找"第二算力来源"。长期押注英伟达单一供应链的风险,大家都看在眼里,谷歌 TPU 和甲骨文的云产能成了分散风险的备选项。对行业而言,算力市场从"英伟达独大"走向"多供应商",长期来看有利于压价格、保供给,对下游用 AI 的企业是好事。
出处:汇总 今日头条《AI 每日新闻简报》(据多家外媒报道)原文链接
把这十条放在一起看,今天的主线挺清楚:一边是模型继续往外"交"——Kimi 把完整权重开源、DeepSeek 把训练搬上国产芯片;另一边是治理和成本开始收紧——中国要立全生命周期安全标准、Anthropic 和马斯克都在为天价算力账单犯愁。AI 从拼参数,走到拼落地、拼成本、拼合规,这步棋越来越明显了。