










2
4
Java内存溢出怎么解决方法
2026-11-06 21:50:18
0点赞
0收藏
0评论
遇到 java.lang.OutOfMemoryError 时,先不要急着调大 -Xmx。调大堆只会在很多情况下把崩溃时间往后推,并不会改变泄漏本身。通常的排查顺序是:先从日志里确认 OOM 的具体类型,再用 jstat 和 jmap 这些命令看堆的实际走势,然后对照启动参数和监控面板,判断问题出在堆、元空间、直接内存还是线程栈,最后才决定是改配置还是改代码。下面按真实排查顺序展开,每一步都给出可以核对的命令或位置。
判断 OOM 时,先看异常类型,而不是先加内存:
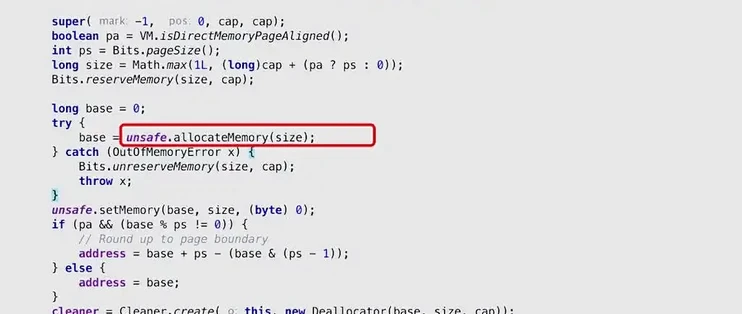
Java heap space表示堆内对象放不下;Metaspace表示类元数据涨得过快;Direct buffer memory表示堆外内存没有释放;unable to create new native thread则表示线程数或系统资源被耗尽。适用场景是有 OOM 报错、堆内存持续增长或者进程被系统杀掉的 Java 服务。操作上,先用jstat -gc观察老年代占用率是否持续上升,再决定是否用jmap导出堆。验证时以连续观察一段时间后指标是否稳定为准。边界在于:现场情况差异很大,下面给出的路径和参数需要结合实际 JDK 版本和部署方式确认。
Java heap space内存溢出怎么解决
Java heap space 是 OOM 里最常见的一类,它对应的问题环节是“对象分配在堆内,但堆已经放不下新对象”。确认这个环节的入口是异常堆栈:在应用日志或容器标准输出里搜索 java.lang.OutOfMemoryError: Java heap space,命中这条就是堆内溢出,没有命中就不要按堆问题处理。
确认后先拿到堆的走势,而不是直接改参数。用进程 PID 执行:
jstat -gcutil 1000 20
看 O 列(老年代使用率)和 FGC 列(Full GC 次数)。如果老年代使用率在多次 Full GC 后仍然停在很高的位置、几乎不回落,通常说明有对象被长期持有,属于泄漏方向;如果每次 Full GC 都能明显降下来,但很快又涨回去,更可能是堆本身偏小或者瞬时流量大。两种情况处理方式不同,不要混在一起改。
需要确认具体对象时,在启动参数里加 -XX:+HeapDumpOnOutOfMemoryError -XX:HeapDumpPath=/data/dump/,下次 OOM 会自动落盘;也可以对存活进程手动执行 jmap -dump:format=b,file=/data/dump/heap.hprof 。注意手动导出会暂停应用,建议在低峰期做,并确认 /data/dump/ 所在磁盘空间足够,堆越大文件越大。
Java内存溢出先定位在哪一层
OOM 不一定出在堆。修改之前先做一次分层判断,能避免在错误的方向上反复调参。
堆内:异常是
Java heap space;检查位置是jstat -gcutil的老年代列和 Full GC 频率。元空间:异常是
Metaspace;检查位置是jstat -gc中的MC/MU列,或启动参数-XX:MaxMetaspaceSize的取值。常见于大量动态生成类、热部署反复加载的场景。直接内存 / 堆外:异常是
Direct buffer memory,或者进程 RSS 远高于堆上限;检查位置是-XX:MaxDirectMemorySize配置,以及top -p看 RES 是否持续上涨。线程栈:异常是
unable to create new native thread;检查位置是jstack | grep -c "java.lang.Thread.State"统计线程数,配合ulimit -u和cat /proc/sys/kernel/threads-max看系统上限。被系统杀掉:没有 OOM 日志但进程消失了;检查位置是
dmesg -T | grep -i "killed process",命中说明是操作系统内存压力导致的 OOM killer。
每一层的判断依据都是“异常类型、指标走势、系统日志”三者对得上,再决定动手方向。
Java内存溢出:先看这四个位置
第一个位置是应用日志。常见路径是应用配置的日志目录,例如 /var/log/app/ 或容器内的 docker logs 2>&1 | grep -i outofmemory。要找的是完整异常类型那一行,以及它前面最近的业务日志。
第二个位置是命令行输出。先 jps -l 拿到 PID,再依次执行 jstat -gcutil 1000、jmap -histo:live | head -30。第二条会触发一次 Full GC 并列出存活对象直方图,排在前面的类往往就是占用大户,可作为排查起点。
第三个位置是启动配置。检查 ps -ef | grep java 或容器启动脚本里的 -Xms、-Xmx、-XX:MaxMetaspaceSize、-XX:MaxDirectMemorySize。需要特别注意 -Xmx 和容器内存上限的关系:如果堆上限接近容器限制,进程很容易被容器运行时杀掉而不是抛 OOM。
第四个位置是监控面板字段。看堆已用、堆最大值、Full GC 次数与耗时、非堆内存、线程数这几个曲线。关键是看趋势而不是单点值:老年代在多次 Full GC 后仍不下降,比某个瞬间占用高更值得警惕。
Java内存溢出:按可能性从高到低排除
集合或缓存无上限增长。确认动作:用
jmap -histo:live | head -30看是否有HashMap$Node、byte[]、业务实体类数量异常靠前。处理方向是给缓存加容量上限和过期策略,排查是否有只增不删的静态集合。一次性加载大量数据。确认动作:结合
jmap -histo里数量与容量都偏大的集合类,回到代码检查是否用findAll一类查询把整表读进内存。处理方向是改分页或流式读取。堆参数设置不合理。确认动作:对比
ps -ef | grep java里的-Xmx与实际容器内存限制,以及jstat中老年代是否在正常 Full GC 后能降下来。处理方向是在确认非泄漏后调整堆大小,而不是反过来。元空间或直接内存超限。确认动作:
jstat -gc看MU是否持续逼近上限;top -p看 RES 是否明显超过堆上限。处理方向是排查动态类生成和 NIO 缓冲区释放。线程数暴涨。确认动作:
jstack | grep -c "java.lang.Thread.State"统计线程数,与ulimit -u对照。处理方向是检查线程池是否被无界创建。
容易踩的坑是:看到 OOM 就先把 -Xmx 翻倍。如果根因是泄漏,改参数只会让崩溃间隔变长,同时把 Full GC 的单次停顿拉得更长;排查时应先在原有参数下拿到堆快照,再考虑调整。
Java内存溢出:改完怎么确认真的解决了
改动的如果是代码或缓存策略,验证方式是重新发布后继续用 jstat -gcutil 1000 观察老年代使用率和 Full GC 频率。判断稳定的标准通常是:老年代使用率在经历多次 Full GC 后能回落到较低位置,并且在一段覆盖业务高峰的观察周期内不再持续单调上涨。观察多久要结合业务周期定,建议至少覆盖一个完整的高峰时段,不要看几分钟曲线就下结论。
改动的如果是 JVM 参数,验证方式是确认新参数确实生效:jinfo -flag MaxHeapSize ,以及 jcmd VM.flags 查看全部生效参数。同时观察 top -p 的 RES 是否在容器限制之内,避免把堆调大后反而触发系统 OOM killer。
回滚办法要提前准备:参数类改动保留旧的启动脚本副本,例如改前执行 cp start.sh start.sh.bak,出问题时用备份脚本重启进程即可;代码类改动按发布系统回滚到上一个版本,并确认回滚后 jstat 指纹与改动前一致。若改动涉及缓存容量,回滚时注意新写入的数据格式是否兼容上一个版本,必要时先降级开关再回滚。所有改动建议先在预发或灰度实例上观察,再推到全量。