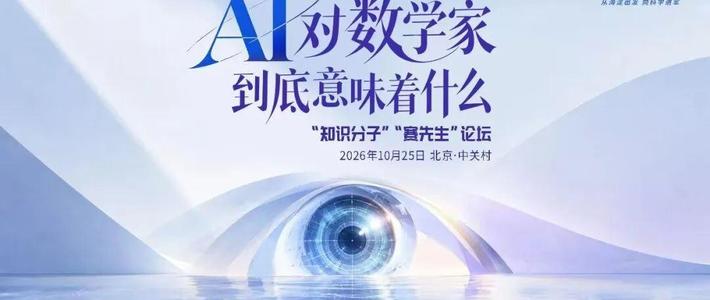
10月25日,在《知识分子》与《赛先生》联合举办的"AI对数学家到底意味着什么"论坛上,2026年菲尔兹奖得主、芝加哥大学教授邓煜首次公开回应数学界持续一个多月的风波。他在演讲中说,不止一位数学家向他反映,此前喂给AI模型的想法和思路,几周后就以极为相似的做法和证明方式,出现在这家AI公司的最新发布里。 对用户来说,这场争议真正值得盯住的是它撕开的一笔账:你输入给AI的内容可能被用于训练下一代模型,而模型的产出与你再无关系。知识分子
风波是怎么一步步升级的
冲突不是10月25日才开始的。9月11日,包括陶哲轩、邓煜在内的25位菲尔兹奖得主联合发表《人工智能在数学中的严重错位》声明,批评AI公司把解决数学难题当作推进模型能力的基准测试。 演讲中邓煜提到的另一个起点,是这家公司约一个月前公布的带外力项Navier-Stokes方程的构造证明——一个千禧年难题级别的成果。 到10月6日,OpenAI一天内放出722份学术预印本,宣称在几何、代数及计算机科学等领域取得372个问题的突破,且不走同行评审也不经过预印本平台;这些论文随后因符号错误等出现撤回。每日经济新闻知识分子界面新闻
他质问的三件事
在这位新晋菲尔兹奖得主看来,既然业界愿意把AI模型当成一个"虚拟研究者",那它的发布行为就该接受学术标准的约束,据此他列出三条:重大成果只给结论、拒绝公布思维链;沿用人类研究者思路的证明不作任何说明;未经正确性验证就批量发布。对于拒绝公布思维链的理由"防蒸馏",他给出这场讨论里被引用最多的一句话——你不能只有在蒸馏全人类知识时觉得理所当然,别人想了解思维链时却说不行。知识分子知乎
演讲里更刺眼的是商业层面的算法。按他的描述,这是一个完整闭环:数学家为AI产品付费、把思路输入产品;公司拿这些输入训练新一代模型;新模型再去解决数学界的公开问题,荣誉归于公司。 他由此提出三条修正方向:AI公司不应亲自下场代替用户做研究;用户应能轻易选择自己的输入是否允许用于训练;以及建立可追溯的贡献认定——谁最早提出的思路,要能追得回去。知识分子
普通用户会被"白嫖"吗
需要先把边界说清。目前"输入的思路出现在公司发布里"仍属于数学家向邓煜反映、由他在演讲中转述的层级,公司方面未见公开回应,也无独立核验;陶哲轩在对谈中提到的"AI直接吸纳他人输入ChatGPT的想法来生成证明",同样被他描述为"模糊地带"。 也就是说,有已具名证据的受影响者还是专业研究者。普通用户日常输入的多数是提问和通用信息,更接近模型的"燃料",很难构成有复用价值的思路;真正和数学家处境同构的,是手里有未发表内容的人——科研想法、创作大纲、商业方案,这一类输入进入训练链条后的遭遇,与演讲里描述的没有区别。界面新闻
至于产品层面的自我保护,没有统一答案,只能逐个检查。知乎上对主流AI产品数据政策的核查帖提醒:对话内容都可能被拿去分析并训练模型,不想被用需要自己去设置里关闭,而且关闭训练开关并不等于服务器立即删除已留存的数据。 三个可观察的信号值得普通用户留意:AI公司是否放开用户数据用于训练的可选授权、关键成果是否公布思维链、邓煜所说的可追溯机制能否落地——这三条既是数学家的诉求,也是判断普通用户处境会不会改变的标尺。知乎
这场演讲最出圈的话题是"人不能给AI当狗",它甚至不是演讲里最硬的部分。 思路会不会被拿走,取决于你输入什么、设置怎么关;而思考能力会不会被拿走,取决于你是否把每一次动笔、每一次推导都外包出去——邓煜在同一个演讲里给出的理想用法恰恰是反过来的:人把握方向和路线图,AI负责试错和细节。界面新闻