




















26
49
A卡也能玩转大模型!撼讯 9070XT 暗黑犬实测 Qwen3.8 27B
2026-11-12 17:28:24
0点赞
0收藏
0评论
在很多用户的传统认知中,本地部署大语言模型似乎一直有特定的硬件门槛,“跑 AI 只能选特定阵营”也成了不少人的既定印象。但随着开源生态与工具链的持续演进,现在的体验已经完全改观。借助开箱即用的图形化工具 LM Studio,AMD 显卡在 Windows 系统下同样能够无缝调用硬件加速,流畅运行当下的主流大模型。
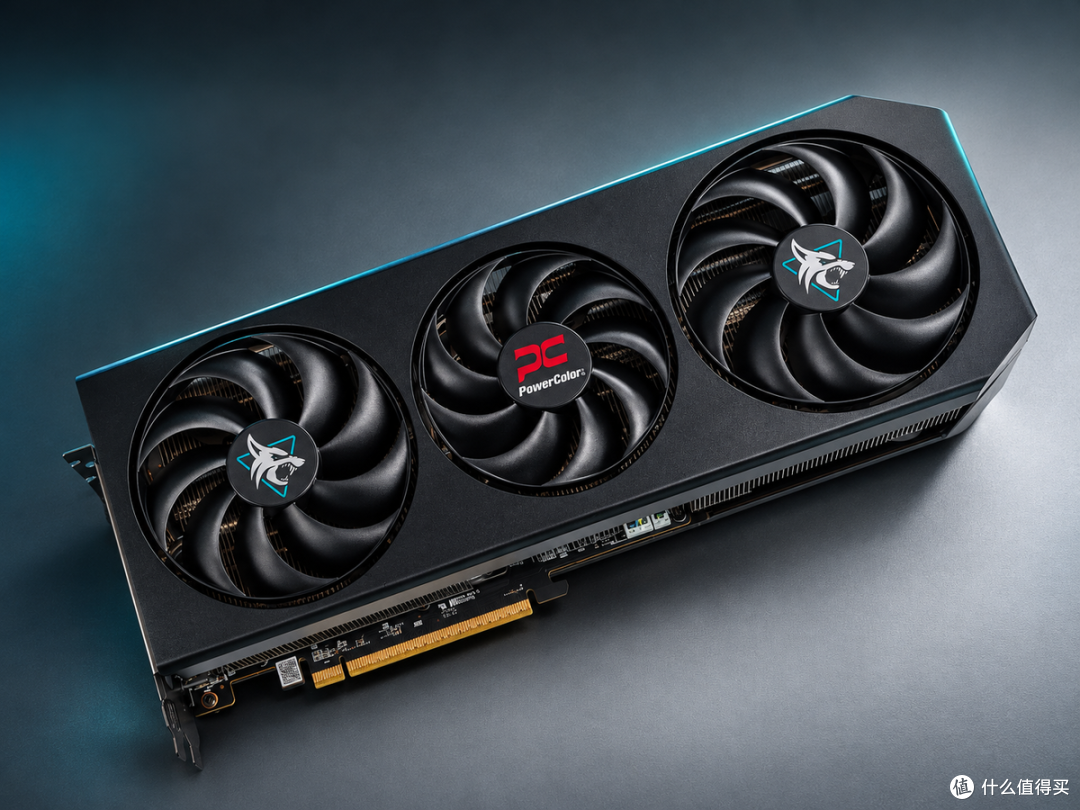
这次我们使用撼讯 AMD Radeon RX 9070 XT 暗黑犬(16GB 显存),在本地实测跑通了 270 亿参数的 Qwen3.8-27B 多模态视觉模型。在完整保留看图识图能力的前提下,实际生成速度稳定保持在 36 tokens/s 左右,流畅度与可用性都达到了相当实用的水准。
部署与上手:在 A 卡上运行 27B 大模型
第一步:准备运行环境
在 Windows 环境下运行大模型,现在已经无需配置复杂的代码环境。下载并安装最新版的 LM Studio (https://lmstudio.ai/)即可,软件启动后会自动检测系统中的 AMD 显卡并匹配相应的加速后端,后续操作全部在图形界面中通过鼠标点击完成。
第二步:根据硬件显存挑选合适的模型文件
面对同一个大模型,开源社区通常会发布不同压缩程度的量化版本。在挑选文件时,显存容量是决定能否顺畅运行的关键。
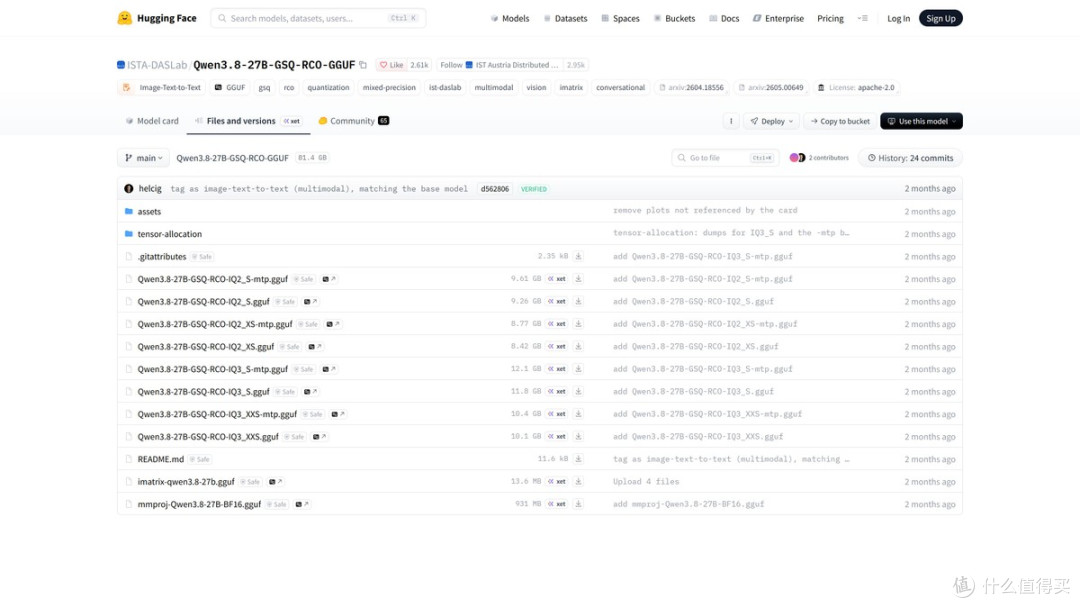
对于 RX 9070 XT 这块 16GB 显存的显卡,我们在 Hugging Face 上选择了 ISTA-DASLab/Qwen3.8-27B-GSQ-RCO-GGUF 仓库(https://huggingface.co/ISTA-DASLab/Qwen3.8-27B-GSQ-RCO-GGUF/tree/main)。
选择具体版本时,需要算一下显存的实际占用:
如果选择常见的 4-bit(Q4)版本,27B 模型的本体体积通常在 16GB 左右,这几乎会把显存直接占满。一旦用户开始长对话或处理长文档,显存立刻就会溢出,部分数据只能退回到内存中运算,导致速度明显放慢。而如果退到更小的 2-bit(IQ2 系列,约 8~9GB),显存虽然宽松,但语言理解与逻辑表达能力会受到一定程度的压缩。
因此,这个仓库中的 IQ3_XXS 版本是一个兼顾模型能力与显存余量的折中选择。该文件体积约为 10.1GB,加载后占据了约 60% 出头的显存空间,正好给显存留出了 5~6GB 的富余。这部分剩余显存,一方面可以轻松挂载约 931MB 的视觉组件(mmproj-Qwen3.8-27B-BF16.gguf),让模型获得看图识图能力;另一方面也为后续的长上下文缓存(Context Length)留出了充裕的缓冲,不会轻易发生显存爆仓。
第三步:在 LM Studio 界面中加载与配置
将下载好的模型文件放置到 LM Studio 的模型目录后,在软件顶部的模型加载栏中选中该模型,进入加载配置窗口:
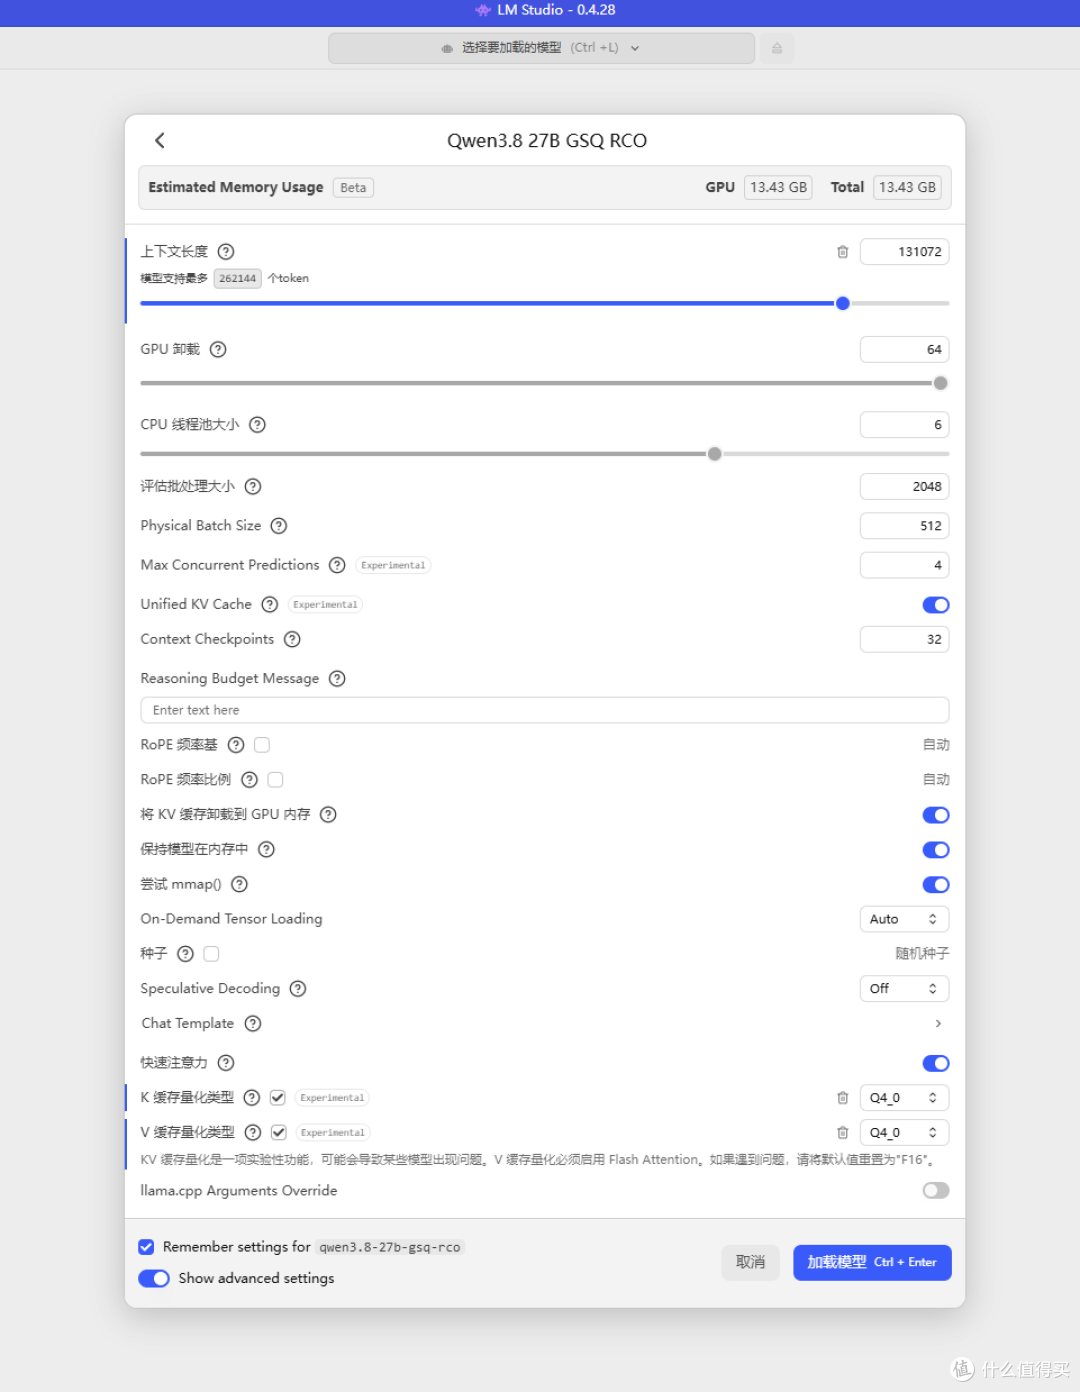
虽然该模型原生最高支持 256K 上下文,但若直接拉满到 256K,极限状态下的缓存开销会逼近 16GB 显存的物理上限,容易受到桌面显示或其他后台程序的显存挤占。而在开启 q4_0 缓存量化后,128K (131072)上下文仅需占用约 2.2GB 左右的显存。加上 10.1GB 的模型本体和 0.9GB 的视觉组件,整体显存占用约为 13.5~14GB,正好在 16GB 显存内保留了 1.5~2GB 的安全余量。这样既确保了模型不会因显存溢出而跌入慢速内存,又能让模型一次性吞吐十几万字的超长资料或几十轮复杂对话,免去了频繁遗忘上下文的困扰。
在 GPU 卸载中,直接将滑块拉满到 100%,让所有层全部交由显卡运算。为了获得更合理的显存利用率,建议勾选快速注意力,并将 K/V Cache 的量化类型设置为 q4_0,这样可以大幅减轻多轮长对话时的显存压力。设置完毕后点击加载,模型便在显卡上准备就绪。
二、 实际测试效果
加载完成后,进入 LM Studio 的 Chat 界面进行实际测试。为了检验连续高负载下的运行状态,我们在对话框中输入了一个较长的代码开发需求:“用 HTML 写一个贪吃蛇游戏”,要求包含完整的页面、动画渲染、按键响应及音效逻辑。
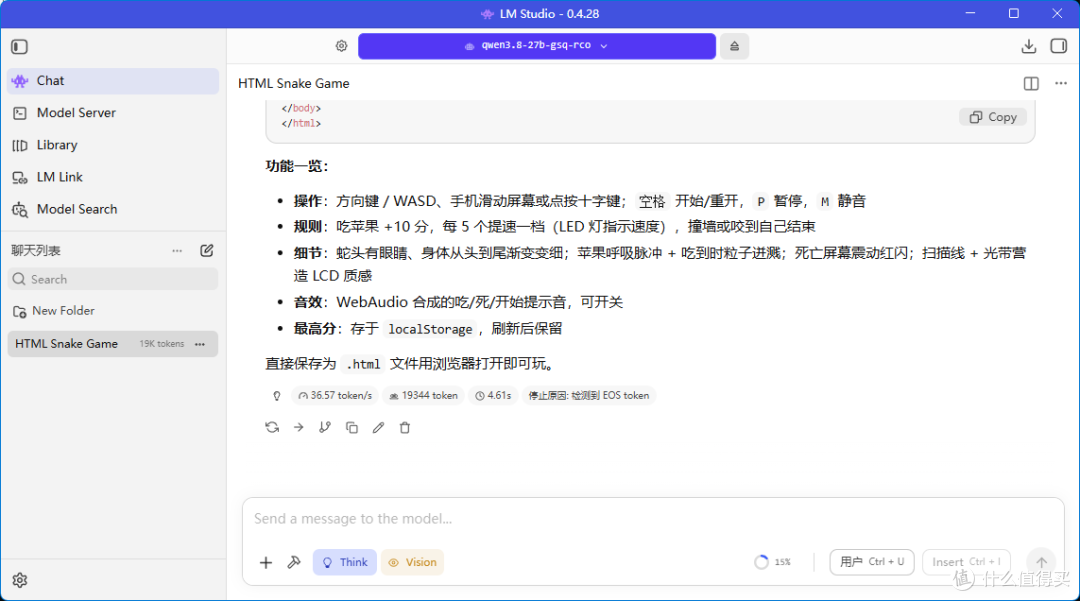
从软件界面底部的统计信息中可以看到直观的运行表现:
模型在接收到提示词后,仅需约 4.61 秒便输出了第一个字符。在开启全层 GPU 加载与深度思考的情况下,整个生成过程稳定维持在 36.57 tokens/s 的速度。对于日常对话、阅读总结以及代码生成这类场景来说,每秒输出三十多个 token 的速度明显快于常规的人类阅读速度,回答过程流畅连贯。
在这一轮单次测试中,模型总计输出了 19,344 个 token,生成了数百行规范的 HTML 单文件代码。整个推演过程持续了约 533 秒,全程保持满载输出,最终正常识别到结束标记收尾,期间显存占用平稳,没有发生异常退出的情况。这也说明在合理的量化选择下,16GB 显存的 A 卡完全能够稳定应对长文本的持续推理。
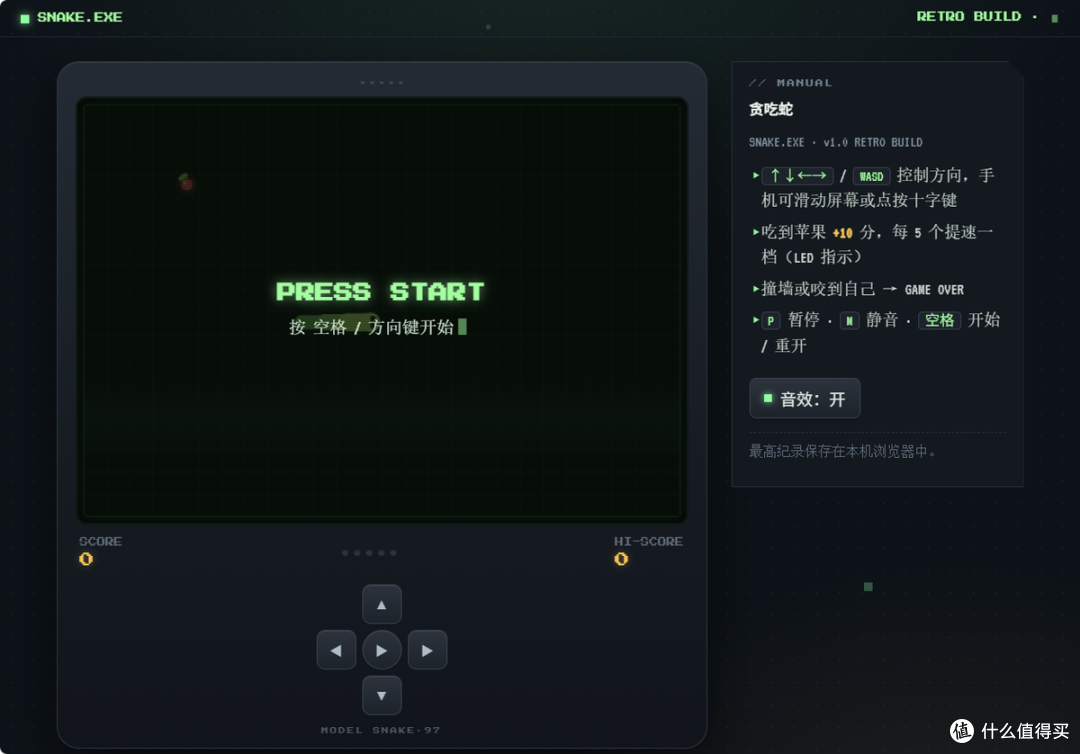
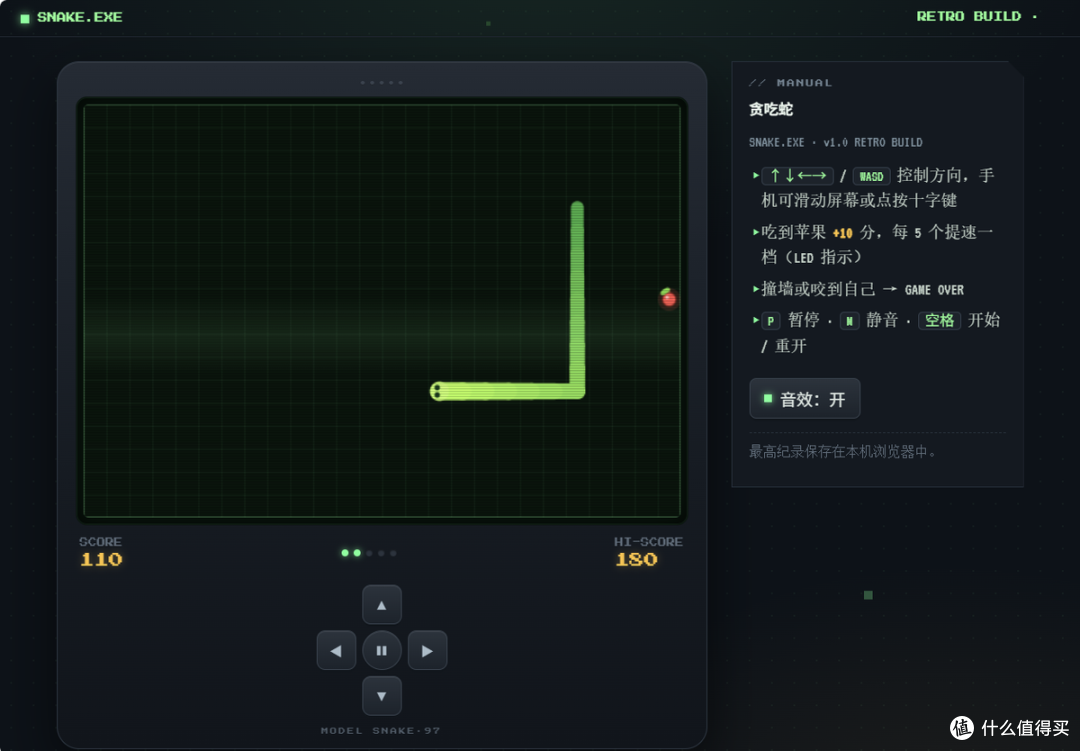
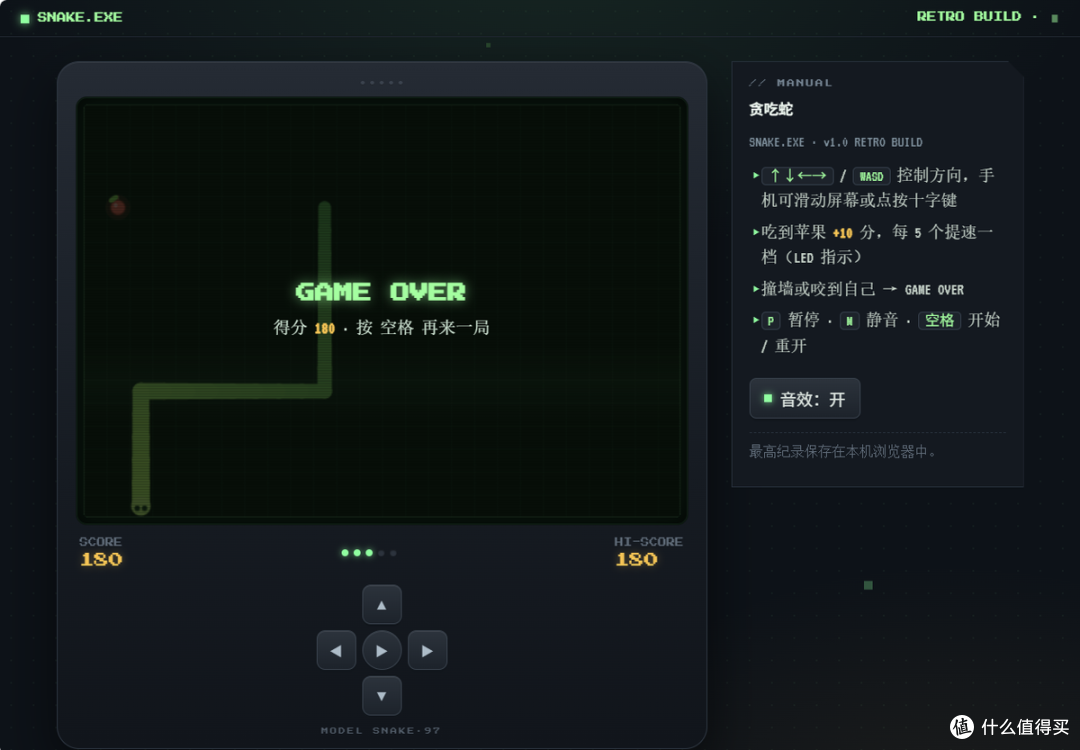
把生成的代码复制并保存为 .html 文件后,直接在浏览器中打开运行。实测游戏功能非常完整,方向键操作响应灵敏,贪吃蛇转向平滑,吃到苹果后的计分、提速以及撞墙判定的逻辑都严丝合缝,甚至连复古风的 WebAudio 提示音效也能正常发声,游玩体验十分流畅。这表明显卡不仅跑得快、跑得稳,模型吐出的代码也能切实落地运行。
三、 硬件保障:撼讯 RX 9070 XT 暗黑犬的核心亮点
大语言模型在进行多轮长对话、复杂代码推演或长文档解析时,显卡会进入长时间连续高负荷的吞吐状态,这对显卡的散热耐久度与电气稳定性提出了切实考验。作为本次实测的基础,撼讯 RX 9070 XT 暗黑犬在关键硬件层面给到了扎实可靠的配置:
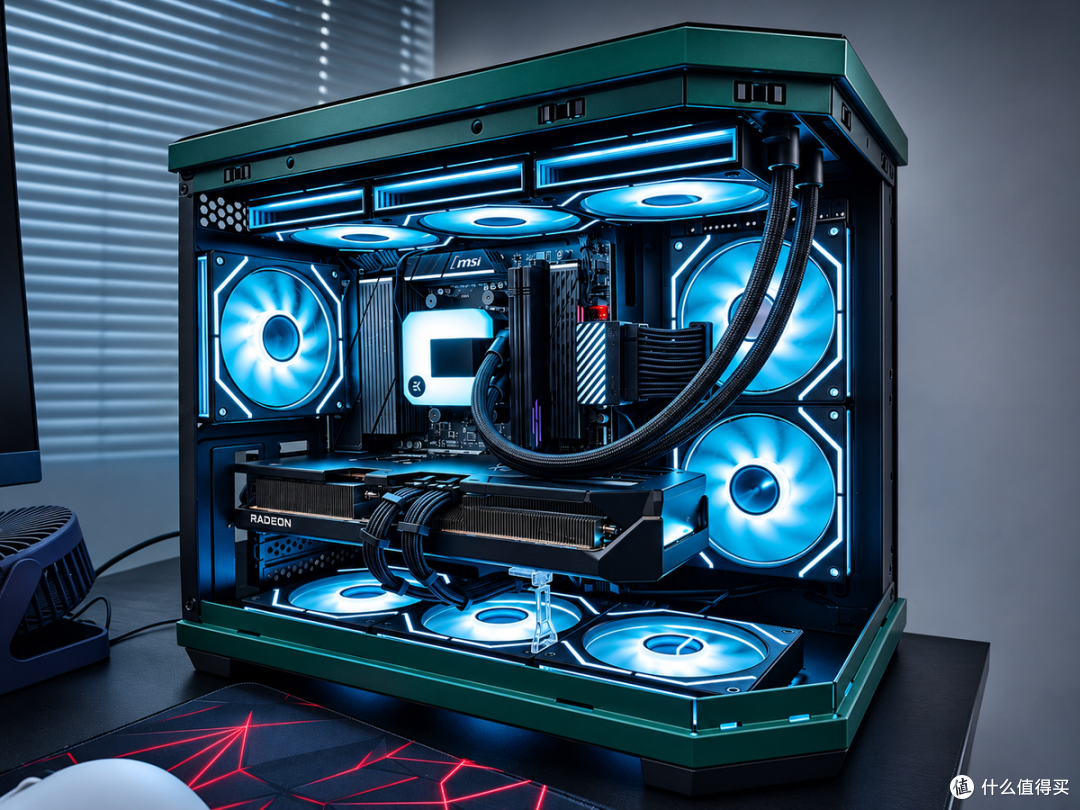
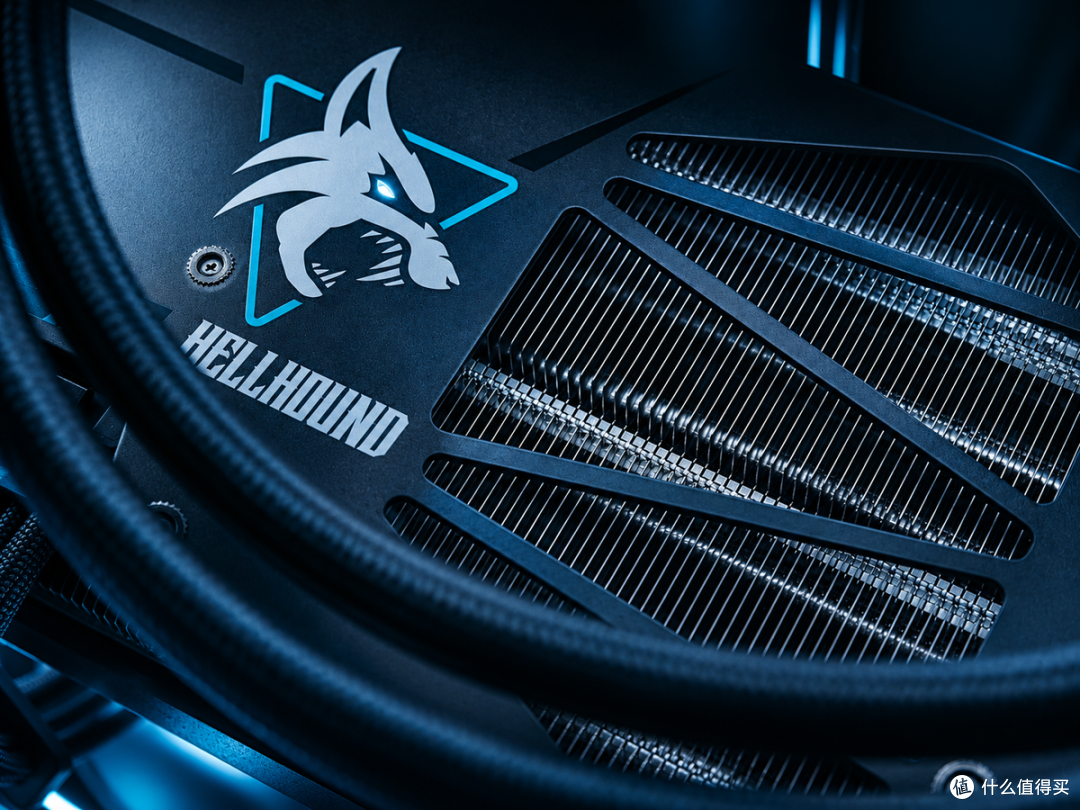
在核心导热材质上,暗黑犬直接采用了工业级霍尼韦尔 PTM7950 相变导热贴,搭配大面积平整的纯铜镀镍底座与 6 根 6mm 纯铜镀镍热管。底座全面覆盖 GPU 核心与高速显存,高发热区域的热量能被瞬间导出。相变材料在受热后能紧密填补微观缝隙,且具备极高的抗泵出和抗干涸性能,非常适合长时间持续高负载工作。
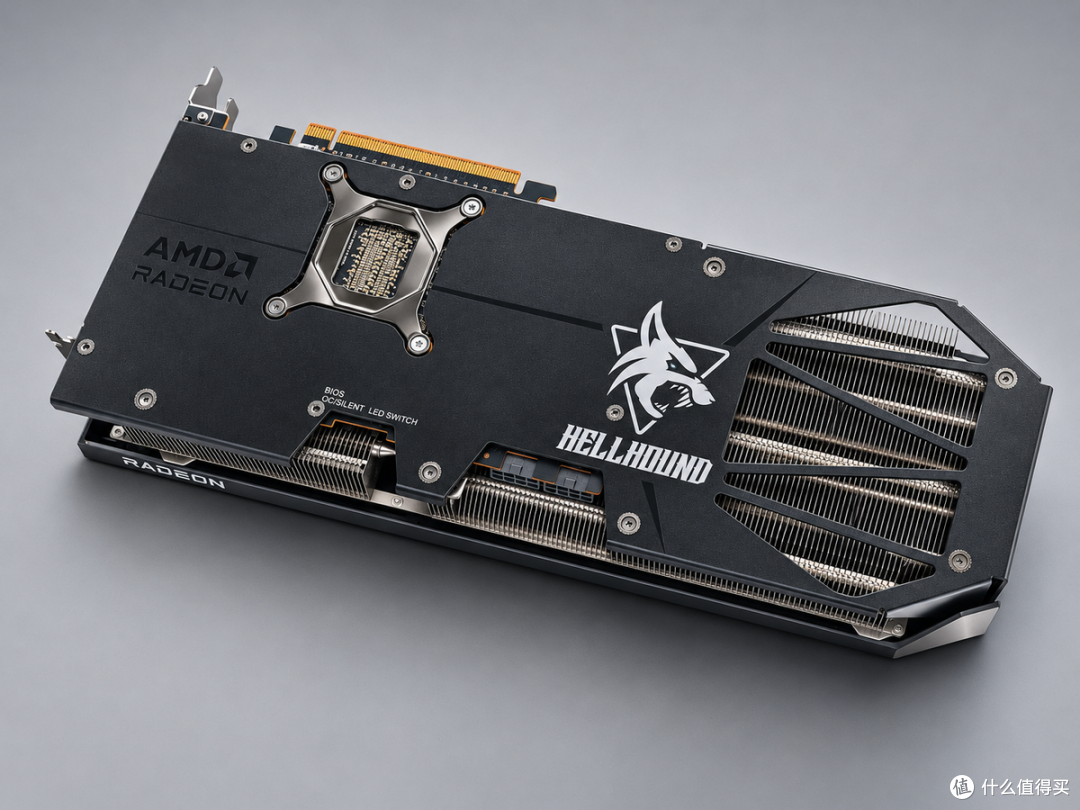
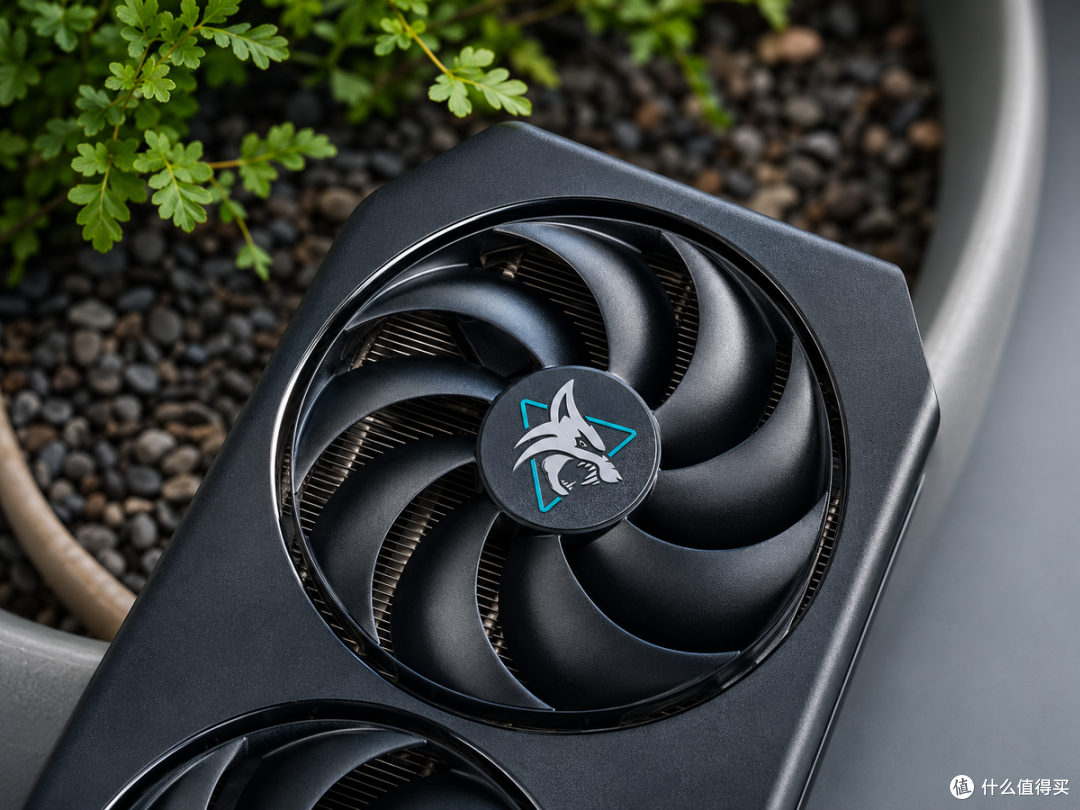
散热器配备了三只 9 叶环形双滚珠轴承风扇,具备出色的耐磨损寿命。两侧风扇特别采用了正反转逆向旋转设计,有效减少了进风时的风道扰流与风噪;配合精准的智能温控芯片,显卡在 60℃ 时平稳启动、降至 50℃ 以下自动停转,在低负载和待机时带来完全安静的体验。
四、 总结
通过实际测试可以看到,借助现在的开箱即用软件,A 卡在本地运行大模型已经完全不存在操作壁垒。对于拥有 16GB 显存的撼讯 RX 9070 XT 暗黑犬而言,只要根据显存容量挑选如 IQ3_XXS 这类配比合理的量化文件,就能轻松兼顾 27B 模型的逻辑质量、视觉多模态能力与长上下文空间,日常使用既流畅又稳定。








