如果你手里正好有一块RTX 3090,平时拿来跑AI画图或者本地大模型,那恭喜,现在可以免费提速一大截了。
GitHub上一位叫Zagitta的开发者,最近开源了一款名为gpu-unlock的工具,能解除RTX 30系显卡被人为限制的AI算力。社区实测,3090 Ti的BF16张量算力从87.5 TFLOPS直接跳到157.4 TFLOPS,提升接近80%。知乎小红书哔哩哔哩GitHub
英伟达确实"锁"了,驱动里都写着
先说清楚,这不是阴谋论。GeForce消费卡在执行FP16、BF16这类半精度运算(FP32累加)时,指令发射速率被限制在专业卡的一半左右——同样是安培架构、同款核心的专业卡跑全速,你买的3090只能跑半速,驱动配置里甚至如实写着FMLA32 = 1/2。知乎哔哩哔哩GitHub
逻辑不难猜:游戏卡要是满速跑,谁还买贵的计算卡?早年专供挖矿的CMP卡也被同样限制过,gpu-unlock的思路,正是借鉴了社区之前对矿卡的解锁研究。GitHub
原理不野路子:不改BIOS、不动驱动
它的做法相当"规矩":用一个Linux内核模块,抢在官方驱动加载之前,修改GPU的速度选择寄存器并重置显卡,随后交还给未经修改的英伟达官方驱动接管。实测中,模型输出的log-prob与原装状态逐字节一致——只是快了,结果没变。知乎小红书哔哩哔哩
实际能赚多少?看你跑什么
矩阵运算:3090 Ti BF16从87.5提到157.4 TFLOPS;3090从77.5提到129.6 TFLOPS,TF32也接近翻倍。知乎小红书
AI画图:ComfyUI下用BF16模型出图,吞吐提升33%到50%多不等,视模型而定。哔哩哔哩
大模型推理:vLLM预填充阶段吞吐提升约10%到33%,但吐字(token生成)速度基本没变。
INT8用户:几乎没收益,不用折腾。
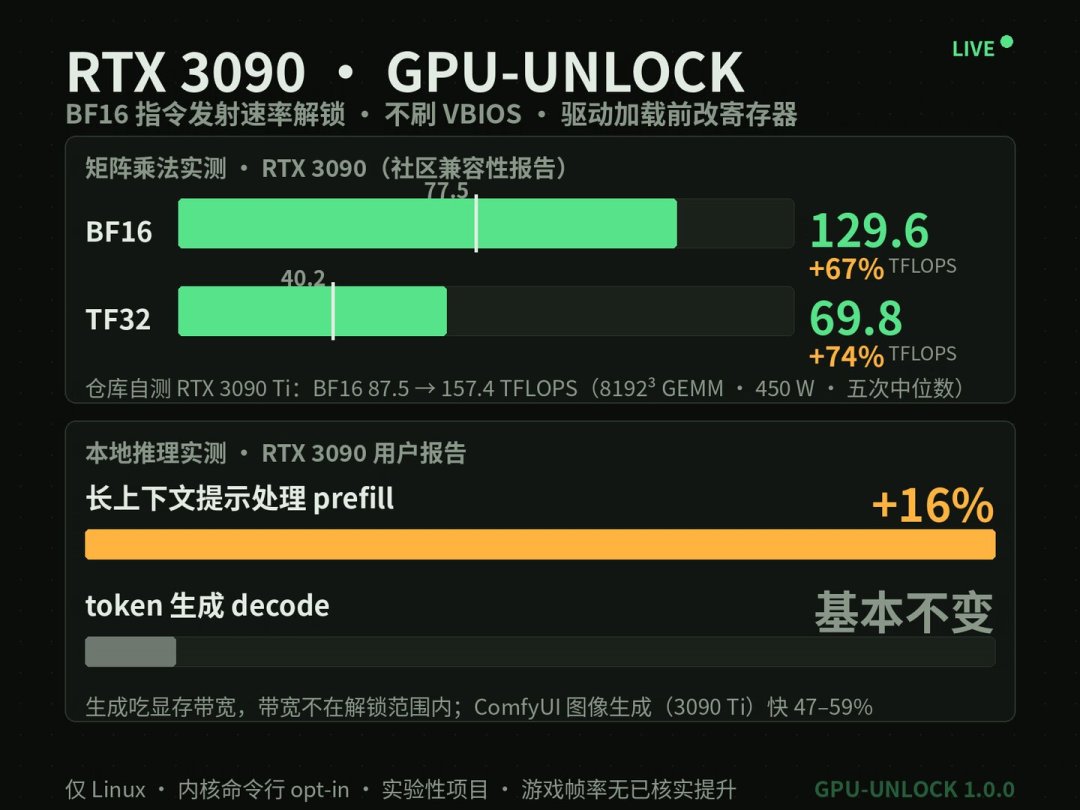
一句话:负载越"吃"BF16算力——出图、嵌入、长提示词预填充,收益越明显。
先别冲,有门槛
泼盆冷水:项目还处于实验阶段,主要支持Linux,Windows移植方案尚不成熟,且需要冷启动才能生效。修改底层寄存器天然带着稳定性与兼容性风险,项目issue区里就有"日志显示成功但性能没变"的反例。会折腾Linux、3090纯属生产力工具、也愿意承担风险,可以一试;主力是打游戏的话直接略过——游戏不走这条张量通路,一帧都不会多。知乎哔哩哔哩哔哩哔哩小红书
最有意思的是这件事本身:2026年的今天,新卡越来越难买,一块五年前的3090,反倒靠一个内核模块免费"增值"了。老黄的刀法精准,但社区的手更快。
你手里那块30系,心动了吗?











校验提示文案
校验提示文案