周三下午,你把上周跑通的脚本又丢给 AI,让它只改一个参数。它回得很快,答案却引用了一个根本不存在的函数。再问一遍,它换了个错法,语气还是很自信。
你开始怀疑是不是自己不会提问。先别急,“降智”这件事至少有三笔账可以查,顺序还不能反。
第一笔,模型有没有被换掉。
OpenAI 帮助中心写得很直白:Plus 用户每 3 小时最多发 160 条 GPT-5.5 消息,用完就静默切到 mini,直到额度重置。没有弹窗,模型标签也不变。新智元
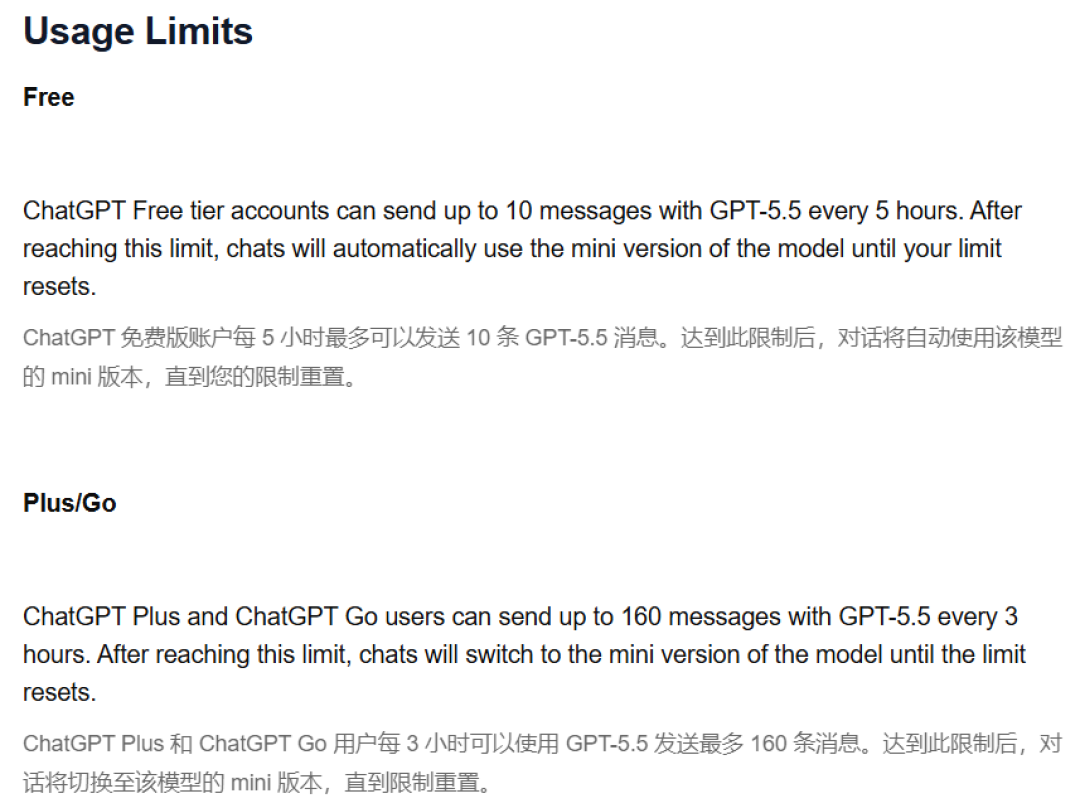
Pro 用户的重度思考档位同样会被限流,条件是服务器负载高,事前也没有提示。
这不是都市传说。2026 年 2 月,GitHub 上一个 Pro 用户用 trace 命令抓到,自己请求的是 GPT-5.3 Codex,实际返回的是 5.2 基础版。
想自己查,按 F12 打开开发者工具,切到 Network,勾上 Preserve log,刷新页面。
筛 backend-api/conversation/,找到当前会话,点开 Response,往下翻:default_model_slug 是请求的,resolved_model_slug 是后端实际路由的。
一个降智期的例子:请求 gpt-5-6-pro,实际回的是 gpt-5-5-mini。
需要说明,OpenAI 没有正式承诺 resolved_model_slug 就是实际执行推理的模型名,但它比直接问“你是什么模型”可靠得多。模型会照着提示词自称,中转站也能改这段回答。
还有个更省事的判断:看思考时长。选了 Pro 和重度思考,复杂问题几秒钟就交卷,多半没轮到它。
第二笔,上下文塞了多少。
Chroma 在 2025 年 7 月发过一份 Context Rot 报告,测了 18 个前沿模型,GPT-4.1、Claude 4、Gemini 2.5、Qwen3 都在里面。结论很一致:输入越长,表现越不稳定。
不是“窗口没满就没事”。一个标称 200K 的窗口,塞到 50K 左右,准确率就可能已经掉了一大截。
原因之一是“中间迷失”:模型对开头和结尾敏感,对中间最钝。关键信息放在中段,准确率能掉三成以上。知乎
更隐蔽的消耗来自工具定义。一个写得完整的 MCP 工具,定义就要 500 到 1500 token。GitHub 官方那个 MCP 服务器带 93 个工具,光初始化就是 55,000 token。
有人在 claude-code 仓库里实测:接 7 个 MCP 服务器,工具定义吃掉 67,300 token,占 200K 窗口的 33.7%。你还没开口,三分之一的位置已经没了。知乎
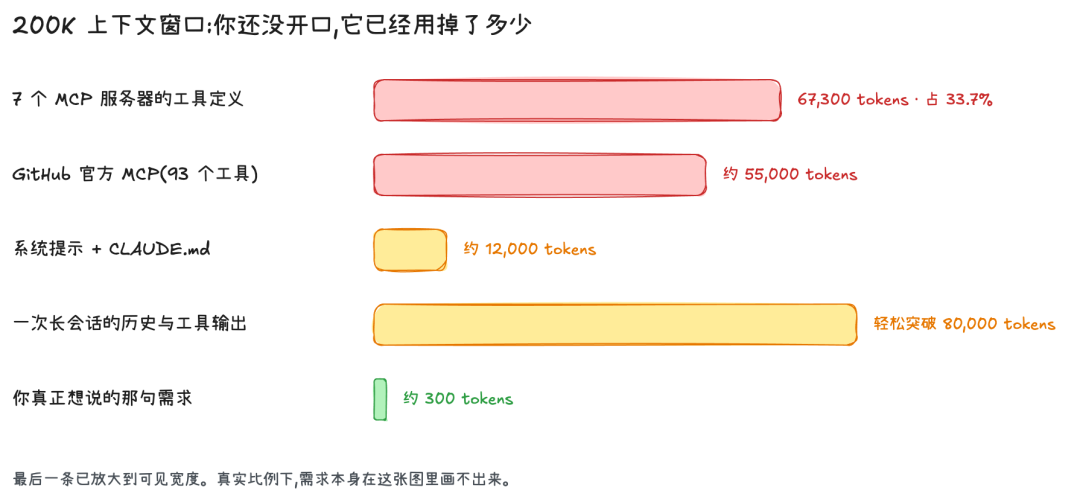
在 Claude Code 里敲 /context 能直接看到这笔账。平时只留一两个天天用的服务器,其余按需开;工具定义要是先吃掉 15% 到 20%,就该清理。
第三笔,你的要求能不能被验证。
Stack Overflow 2025 年的开发者调查收了 49,009 份回答,66% 的人选了同一项:AI 给的方案几乎正确,但不完全对。“几乎正确”翻译过来就是:它听懂了大意,没听懂边界。
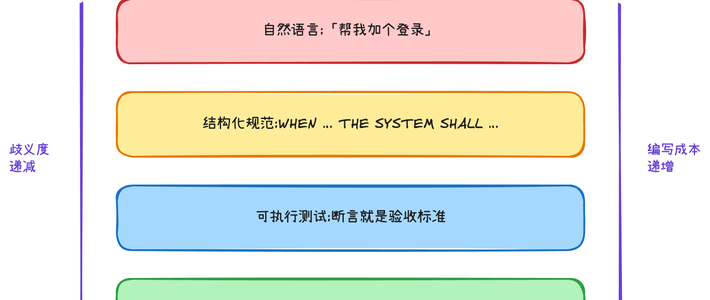
“加个登录”四个字,背后藏着手机号还是邮箱、密码几位、失败几次锁定、token 存哪、多久过期。你不写,模型只能猜。
改法不复杂,把要求写成能验证的句子。不是“做个搜索框”,而是“输入为空时按钮置灰,结果按发布时间倒序,没有结果时显示‘没有找到’”。
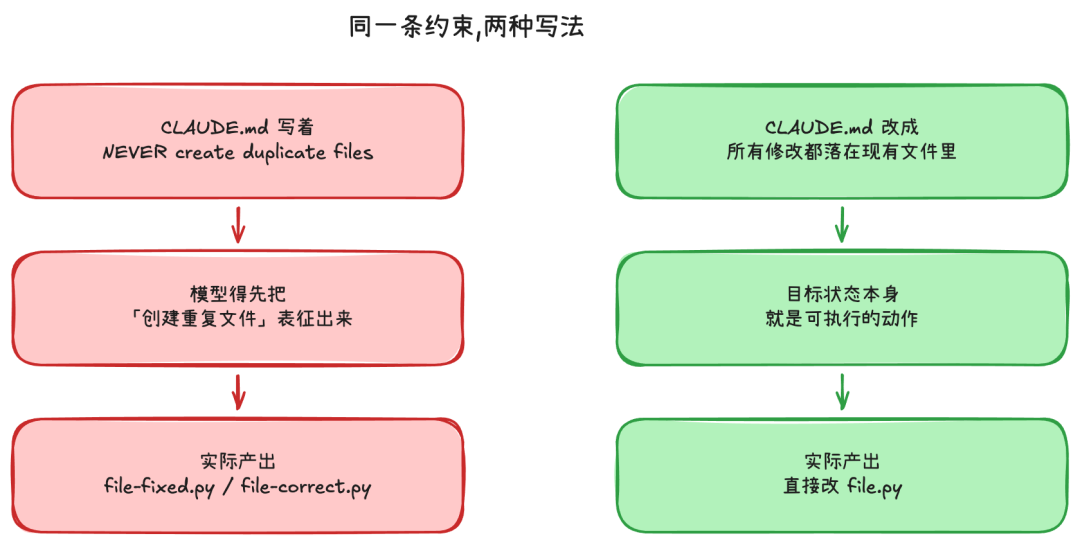
一个输入输出的例子,往往比三百字形容词管用。
三笔账查完,再决定要不要换模型。model_slug 一致、上下文干净、要求可验证,答案还是不行,那就是模型的问题。换一个,别在同一个坑里改十遍提示词。