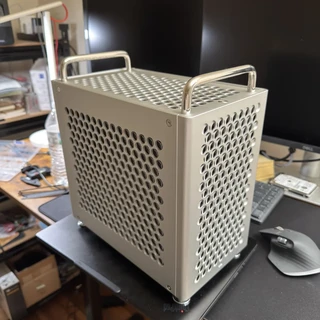
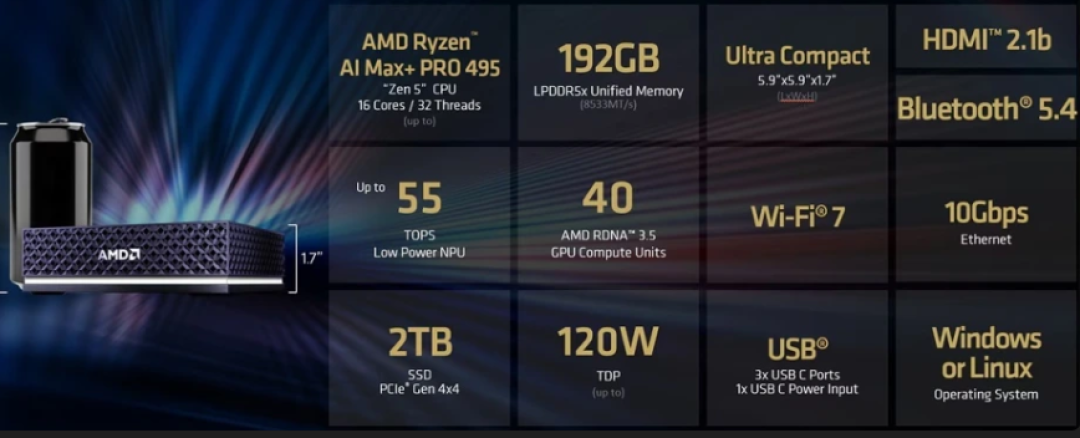
10月9日,极摩客拉着AMD和京东在深圳发了一台"能本地跑3200亿参数大模型"的迷你主机,EVO-X5 Pro,46999元起。B站评测区当天就吵翻了:置顶省流"46999起"收获78个赞,热评第一是"这价钱能买两台395"。而在闲鱼,另一拨人用115元的E5板U加3200元的V100算力卡,4006块把同款模型的量化版点亮了。知乎哔哩哔哩
同一个月内,这两拨人其实在回答同一个问题:本地大模型这班车,到底值不值得在双11赶。这篇替你把全网能找到的实测数字、真实到手价和翻车记录摊在一张桌子上——它服务的是那种"不想再给云端交月费、但预算大概率不超过5000"的折腾党,而不是被495 PRO商用认证瞄准的政企采购。
一、先看新变化:192GB解决"能不能装下",带宽决定"你等不等得起"
这一代真正的变量是统一内存上限从395平台的128GB提到了192GB,频率拉到8533MT/s,带宽约273GB/s,120W持续释放。现场实测的作者给的结论很直白:DeepSeek-V4-Flash这个级别的模型,上一代128GB内存根本启动不了,192GB把它从"装不下"变成"能跑",但生成速度只有14 token/s,属于原话里的"能用但不算快"。短提示实测也就16 token/s,输入1万字要等97秒才出首字。反过来,轻量MoE路线的Qwen3.6-35B从62 token/s提到90 token/s,日常对话已经接近云端手感。知乎
对照组也有意思:Mac Studio M5 Max带宽614GB/s,是同机的两倍多,但开源模型适配要自己折腾。NVIDIA系有CUDA生态,但同等内存容量的机器价格翻倍都不止。同一颗495芯片,海外品牌iBUYPOWER也做了一台叫AI Halo的迷你主机,起售价3999美元(约合28260元),比国行首发还便宜一大截。 这说明495本体的定价并没有封死"五万档",贵出来的那部分是首发溢价,急着上车的可以再观望一轮。一句话,容量这道门被192GB挪低了一档,带宽这堵墙还在原地。知乎知乎
二、双11前最值得动手的变化:迷你主机价格倒挂了
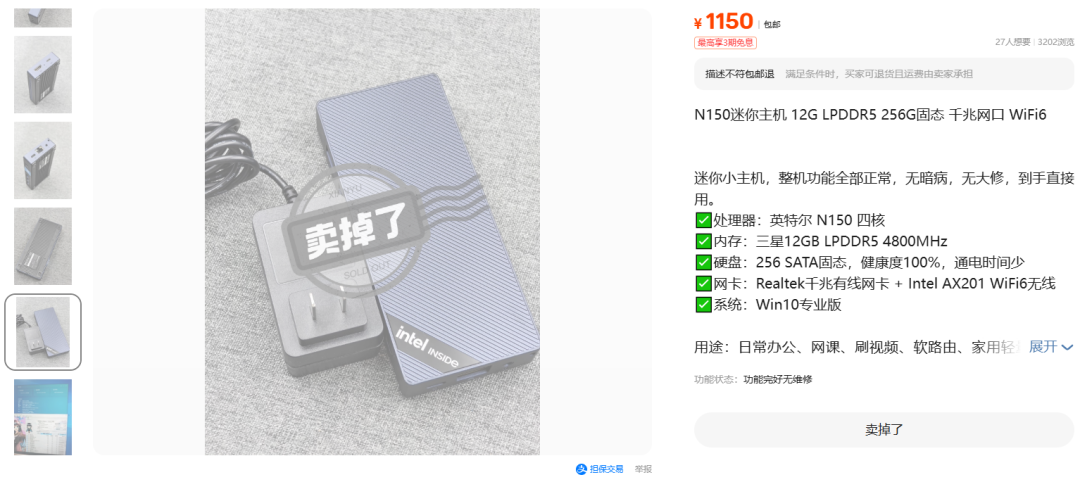
AI9 HX370——2024年的旗舰小U——全新的机器叠加国补已经打到3486元,散热好的极夜款3558元;另一边,两根16G的DDR5内存条市价3200元。有人晒了自己的账:900元收的7840HS准系统,配内存花了3200,整机成本大头反而是内存。二爷记那边更夸张:一台N150的成品小主机流出价1150元,被老哥秒接盘,评论区一句"内存贵过整机"成了今年装机圈最流行的梗。知乎知乎
这背后是垃圾佬圈子的新共识——“存机平衡时代:内存越涨,准系统越便宜”。对你的实际含义是:想跑本地模型,板载内存(LPDDR5焊死在板上、不随零售内存涨价)的迷你主机,性价比窗口正在打开;而打算"先买准系统再自己插两根32G"的人,很可能重演7840HS那个3200元内存比机器贵的故事。知乎
三、垃圾佬路线:4006元跑通,但三个坑先看清楚
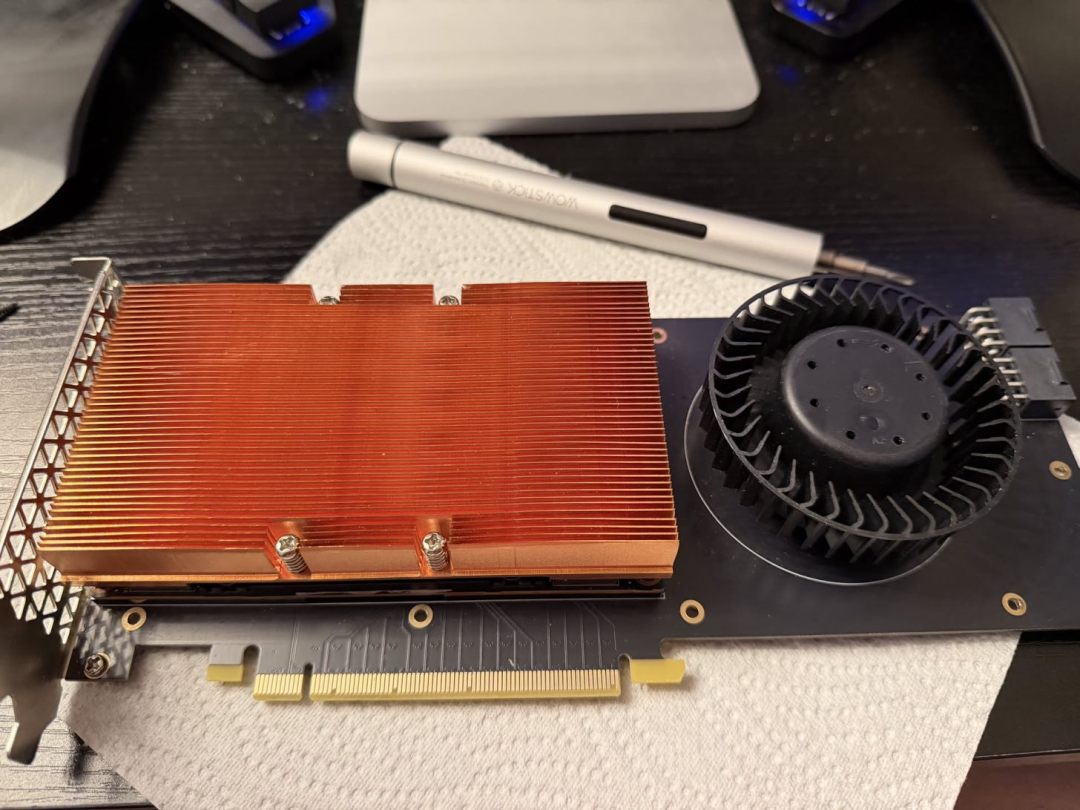
知乎"最丐本地部署配置"问题(3025浏览)下,10月15日有人交了完整作业:E5-2680V2+X79主板115元、DDR3 ECC 32G共160元、GT710亮机卡80元、V100 32G算力卡3200元、电源散热机箱杂项合计不到500元,全程闲鱼包邮到手价4006元。跑Qwen3.8-27B的Q6量化、64K上下文约26 token/s,Q4量化16K上下文能到38 token/s,Ubuntu+Ollama+OpenWebUI从零装完约5小时。知乎
翻车点也写得明明白白:V100供电铝板不加水冷头,跑两三分钟就85℃降频,作者追加两个铝水冷头串进水路才稳定在65℃。V100、P40这类"水很深"的算力卡,到手必须查ECC报错、烤机验证;备选方案P40整机约1500元更便宜,但推理速度要慢三分之二。B站评论区的垃圾佬老哥给的同类思路是"E5双路x8+DDR3服务器内存+P40/V100"——这条路线的精髓从来不是省钱,是用动手时长换显存。要注意的是,这条路线自己也在涨价:有折腾党算过账,V100 32G在2026年3月还能2200元拿下,9月中旬闲鱼/淘宝行情已经抬到4000-5000元,而同为32G显存的5090要4万上下——买它买的从来是显存容量和带宽,不是算力,所以这张"性价比神卡"正在被越来越多的同类人抬上货架。知乎知乎
四、先别花钱:你手上那台电脑能跑到什么程度
两个真实记录:16G内存无独显的笔记本纯CPU跑llama.cpp,6.7 token/s,冷启动要11到12秒——够验证"能不能装下",不够日常用。 核显迷你主机跑AI生图,出图13到15秒一张,批量十张两分半。生图那位三个月复盘里最有价值的不是速度,是三个反常识:同样的20B模型,ncnn引擎不支持量化要712秒一张,换成stable-diffusion.cpp后13秒——先换引擎再怪硬件。Flux用激进Q4量化后的画质指标只有温和q8量化的SDXL-Turbo的十一分之一——参数量不等于效果;连着跑几十次后出图从15秒劣化到45秒,重启服务就恢复——显存碎片化没人提醒你。知乎知乎
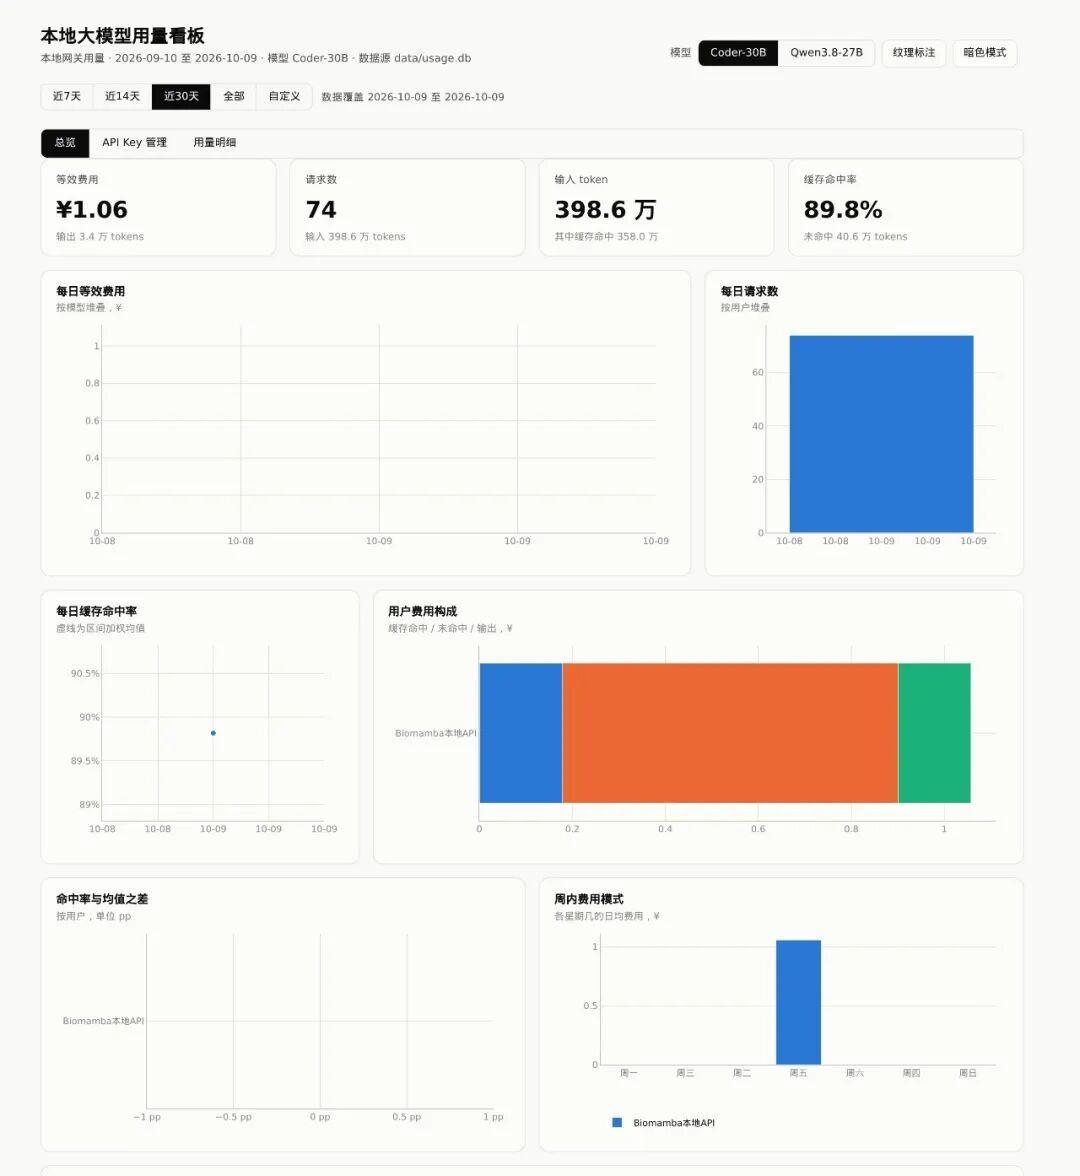
而且"必须大显存"的前提本身在被软件拆台:Strata新引擎已经能12G显存跑1250亿参数的Qwen3.8-Flash-Next。微软的低比特量化把137B模型压到53GB上普通PC。硬件账算不清之前,先把引擎和量化的选型账算一遍,往往是更便宜的路径。至于"本地部署到底能省多少token费",有人晒出自己的本地API用量看板:近30天输入398.6万token,等效费用只有1.06元,缓存命中率89.8%——电费之外几乎归零,这才是"token自由"这四个字的具体数字长相。知乎知乎知乎
五、反方声音凭什么成立:两条最硬的反对意见
B站26赞的带宽瓶颈论值得认真对待:agent类任务输入输出比大约300比1,本地机预填慢,“云端8小时干完的活,本地要一两天”,结论是等DDR6。知乎那边高赞说法更扎心——“本地部署省下的调用费,会从硬件这个口子原样花出去”,而"token自由"这个问题本身有115万浏览、高赞回答只有四个字:“赛博做梦”。还有人说隐私是伪需求,评论区回得干脆:495是政企合规版,“你不是目标用户”。知乎
这些反对意见合起来,恰好划出了这条兴趣的边界:本地大模型适合三种人——数据确实不能出域的、高频调用且模型选型够轻的、以及纯粹享受"把机器点亮"这个过程本身的折腾党。三种都不是的人,4006元和46999元对你都太贵。
六、双11动手清单:按预算对号入座
0元:现有机装Ollama或sd.cpp,跑通一个7B模型/一张生图,先确认需求真伪。
1500元档:闲鱼P40 24G整机,接受比V100慢三分之一的速度。
3500-4500元档:两条路二选一——垃圾佬V100全套(动手能力强、能接受查ECC烤机)或价格倒挂的HX370/板载内存迷你主机(图省心,32G起步,跑量化中型模型)。
47000元档:192GB统一内存,只有"必须离线跑300B级+合规"这一条理由才成立,个人玩家请默认它与你无关。
继续盯四个信号:DDR5零售价的走势(它决定准系统倒挂窗口还剩多久);395平台128GB机型在双11的清库存价;Strata这类低显存引擎的模型适配进度;以及老规矩——今年9月起装机博主已经在提醒"各路商家提前抬价、给假装促销降价做准备",下单前把价格曲线拉出来看一眼,比看配置单重要。知乎
买不买本地大模型这台机器,本质上不是信不信AI的问题,而是你愿不愿意把"等97秒出首字"换成"月底不再看token账单"。账摆在这儿了,按你自己的那把尺子量。