
















2
2
腰斩到$0.1一档:GPT-6不进聊天框
2026-09-23 16:46:18
0点赞
0收藏
0评论
9月23日凌晨,OpenAI把两款新模型的价格砍到GPT-5.6同档的一半:Luna输入每百万token只要0.1美元。但你在ChatGPT聊天框里,暂时用不到它们。
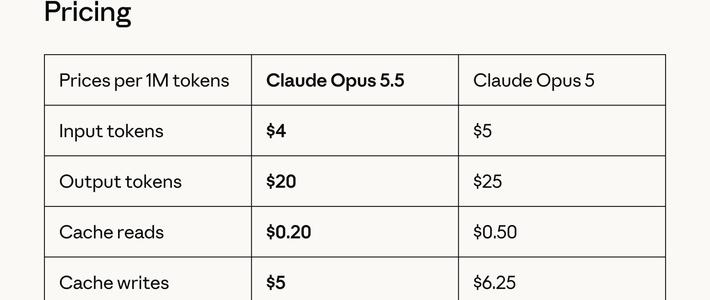
同一天,Anthropic发布Claude Opus 5.5,默认设置下典型负载成本比Opus 5低四成。两家比的不是谁更聪明,是谁的单位任务成本更低、谁能占住干活的那个入口。
两家同一天上新,砍价砍在不同位置
OpenAI这次推出GPT-6家族两款:Sol面向复杂编码与智能体工作流,Luna是高并发档。对GPT-5.6同档当前费率直接对半:Sol每百万token输入2美元、输出10美元;Luna输入0.1美元、输出0.5美元。
官方称Sol在xhigh档下AutomationBench拿到33.2%,折算每个任务0.27美元;DeepSWE v1.1的max档68.8%,Luna为66.6%。两者上下文窗口105万token,支持文本与图像输入。
Anthropic的打法不同:Opus 5.5宣称在多数工作上可媲美Fable 5.1,输入输出4美元和20美元每百万token,比Opus 5低两成;缓存命中0.2美元,低六成。
一家砍单价,一家砍缓存价。而缓存,恰好是这次最容易被忽略的地方。
便宜的不是模型,是那些要重复读的部分
一句话说清:按token计费的账单里,最贵的不是你那句提问,是每一轮都要重新读一遍的上下文。
拆开看。agent跑任务时,同一份代码库、同一份文档会被反复送进模型。命中缓存的部分,单价大约是输入价的十分之一:Luna的缓存读每百万token 0.01美元,输入是0.1美元,差十倍。但上下文一旦超过27.2万token,单价直接变成两倍;走Priority通道再加一倍,Batch和Flex反而减半。同一次调用,换个通道,价格能差四倍。
放到场景里:一个自动化任务要调20次工具,每次带90万token的上下文,缓存命中与否,账单能差出一个量级,比单价便宜一半带来的收益更实在。
OpenAI还补了一句工程上的话:对话中途改reasoning effort、或者切换工具,不再让缓存失效。这句话没进任何标题,却决定上面那笔账能不能算得过来。
新模型先给干活的地方,聊天框排在后面
Plus、Pro、Business、Enterprise用户即日起可在ChatGPT Work和Codex里使用;免费版和Go版用户可在桌面端应用里访问Luna。聊天入口暂时没有。
先给高频、重复、可计量的工作流,把聊天排在后面。工作流能用缓存、能算单价、能对比任务成本,聊天很难做到这三件事。
另一个信号容易被漏掉:这次没有GPT-6 Terra,Astra仍然留在最高档。Sol和Luna是把同一代能力往下放,不是换代。
三个容易看错的地方
第一个说法:降价一半,账单就少一半。单价确实砍了对半,方向没错;但它解释不了长上下文加价、Priority通道双倍、任务重试次数这些变量。更准确的理解是,单价只是账单的一项,缓存命中率、上下文长度和通道选择决定另外一半。
第二个说法:GPT-6全系来了,能力又跳了一级。Sol的68.8%和Opus 5.5宣称媲美更高一档,都是有分量的数字;但它解释不了Terra为什么缺席、Astra为什么还在最高档。更准确的理解是,这是一次定价与档位调整,不是能力换代。
第三个说法:免费用户也能用GPT-6了。免费版和Go版确实能在桌面端用Luna;但「在哪用」和「用什么」是两件事,开放的是桌面应用这个入口,不是聊天里的默认模型,Sol也没有进免费档。更准确的理解是,这一轮开放的是分发位置,不是能力等级。
现在该动的是什么
如果你只是偶尔问答,不用急着换,聊天入口没变。
如果你在跑自动化任务或者写代码,把考核指标从「每百万token多少钱」换成「每个任务多少钱」,记录三件事:单任务的token消耗、缓存命中比例、重试次数。先看缓存命中率还能不能提上去,再考虑换档位。
如果你在帮团队选型,别只看跑分表,挑十来个真实任务在两个模型上各跑一遍,比发布会的数字可信。
有一条边界需要留意:Flex、Batch、Priority的倍率,以及长上下文的加价规则,会随账户方案和地区变化,动手前以官方文档为准。
价格的仗打到这个份上,分水岭已经不在模型本身,而在你把它塞进了哪条流水线。
你现在的AI账单里,花在「缓存命中」上的钱和花在「重新读一遍」上的钱,大概是什么比例?
如果觉得有用,点个在看让我知道;也欢迎转发给在学 AI 的朋友。
关注我,每天陪你聪明看世界 —— 看懂热搜,玩懂AI。
作者提示含AI生成内容。作者声明本文无利益相关,欢迎值友理性交流,和谐讨论~