你是不是也这样:问 AI 一句"这个报错怎么修",它先"好问题!让我想想",然后从你的项目架构讲起,中间件、依赖版本、历史沿革挨个盘一遍,最后来一句"希望这能帮到你,随时问我"——真正那行能解决问题的命令,被埋在了第三屏。
你不是一个人。这几天,一个 GitHub 仓库因为精准戳中这件事,直接冲上了全球开发者社区的热榜。它叫 `i-have-adhd`(我有 ADHD),一句话概括自己的用途:“让你的编程助手别再把答案埋起来”。
我写这篇的时候专门去 GitHub 拉了下实时数据:这个仓库已经有 45,225 个 Star、2,611 个 Fork,而它的"出生日期"是 2026 年 5 月 13 日。9 月 8 日它登上 Hacker News 首页那条帖子,拿了 540 分、372 条评论。一个仓库最值钱的地方,是它背后那套谁都能免费抄走的规则。
一个"140 行文档",凭什么值 4.5 万 Star
先说清楚它是什么,免得你以为是什么黑科技。
`i-have-adhd` 本质上不是什么软件,核心就是一个叫 `SKILL.md` 的文本文件,满打满算 140 行(仓库整体看着挺大,有人用 scc 统计是 59 个文件、8700 多行,但绝大部分是作者自测用的 evals,真正发给你用的规则就那一小段)。它的灵感来自一本书——J. Russell Ramsay 和 Anthony L. Rostin 写的《The Adult ADHD Tool Kit》(成人 ADHD 工具书),作者在 README 里注明是"松散借鉴":把"ADHD 大脑需要怎样的信息"翻译成了"AI 应该怎样回话"。MIT 协议,完全开源、免费、可改。
它的思路特别反常识,也特别对:你不需要真的有 ADHD,也能享受 ADHD 友好的输出。 因为让 ADHD 人群抓狂的那些东西——答案找不到、步骤太长、废话太多、进度看不见——恰恰是所有被消息轰炸、被 deadline 追、只想赶紧把活干完的现代人的共同痛点。仓库 README 自己就写着,对 ADHD 友好的输出、无需确诊 ADHD。GitHub
AI 啰嗦,真不是因为它笨
这是我觉得最值得说的一层,也是这个仓库"戳破的窗户纸"。
很多人第一反应是:“AI 话多,是模型还不够聪明。” 但真相恰恰相反——AI 回复冗长,不是能力不够,是它的训练目标和你的真实需求之间存在结构性错位。 模型被训练成"预测下一个 token"、被人类反馈调教成"尽量显得有帮助、有礼貌、考虑周全",于是它默认每次回答都得有个友善的开场、周全的背景、客套的收尾。这套"社交惯性"在聊天场景没毛病,但在"我就想赶紧解决问题"的场景里,就是纯粹的信息噪音。知乎
Hacker News 那条帖子底下 300 多条评论,几乎变成了一场大型吐槽会。有人说得更狠,说每个聊天机器人都有这毛病——你不专门让它简短,它就能给你甩一篇五段式宣言,烧掉十亿个 token。 还有人专门给 Claude 那种啰嗦文风起了个外号叫 “Claudisms”(克劳德腔),甚至有人开玩笑"怀疑这是不是故意写这么长,好让你多花点 token 钱"。Hacker News
顺带说一句跟钱包直接相关的:微博上也有用户点破了这层,拟人化情绪价值的提供,也是要烧 token 的。 按量计费的 API 用户,AI 每多客套一句都是真金白银;就算是包月的会员,冗长回复也在悄悄吃掉你的额度和耐心。所以"让 AI 说人话"这件事,不只是省时间,也是省钱。微博
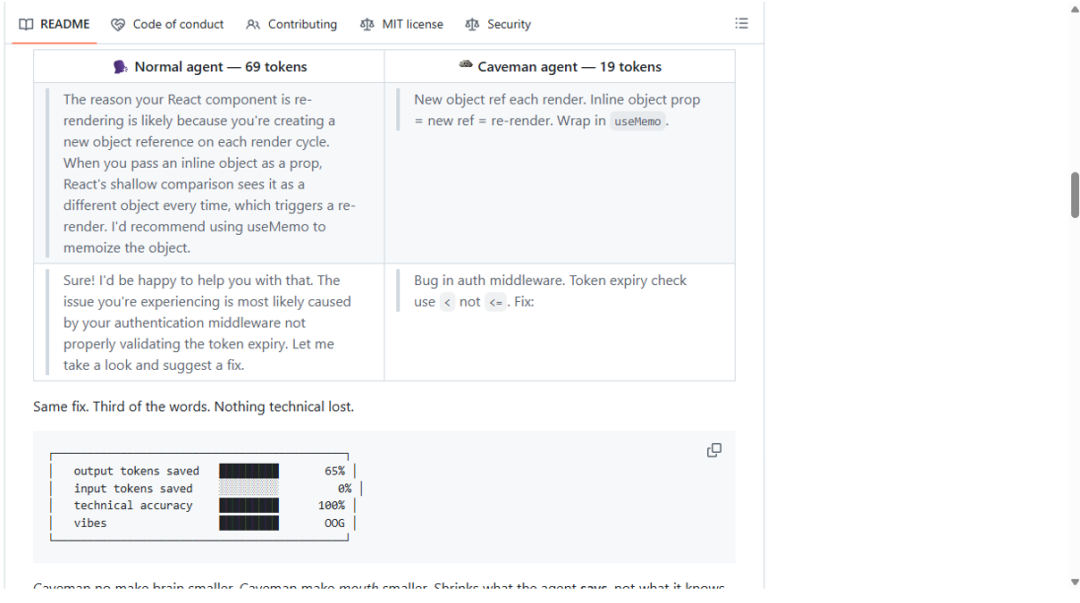
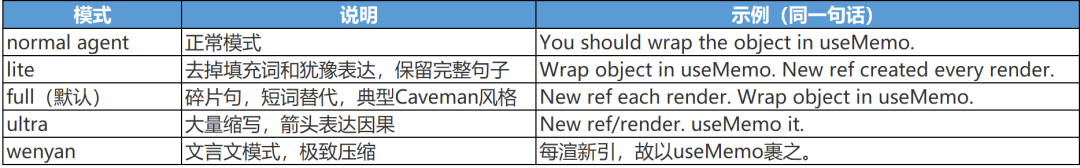
这股"反废话"情绪甚至已经养出了一整条赛道。比 i-have-adhd 更早爆火的是一个叫 Caveman(穴居人) 的开源项目,口号粗暴到好笑——“why use many token when few token do trick”(何必用那么多 token,少点不就够了)。它让 AI 像山顶洞人一样说话,砍掉一切客套和填充词。钛媒体 7 月报道它时,Star 数已经 8 万出头,我写这篇时再查 GitHub 实时接口,已经是 105,540 个——比 i-have-adhd 还多一倍多。作者给出的基准测试是"10 个任务,输出 token 平均从 1214 压到 294,省 65%"。它甚至还有个文言文模式——用表意密度最高的文言文把 token 压到极致,对中文用户来说算是个彩蛋。GitHub钛媒体
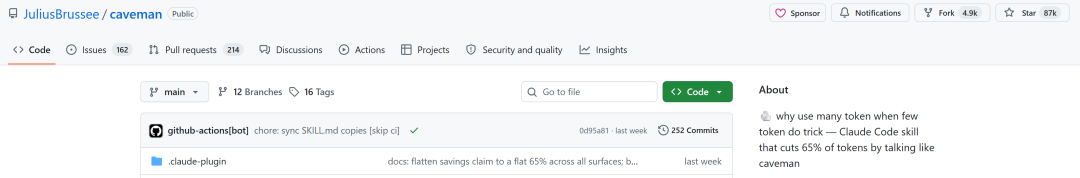
但这里必须说句实在话,也是钛媒体那篇报道里点破的关键:Caveman 压缩的只是"输出 token",它不压缩输入 token,更碰不到模型"思考"阶段真正烧钱的推理 token,加载它本身每轮还要多占 1~1.5k 上下文。 所以指望装个插件就把 API 账单砍掉 65%,大概率会失望。i-have-adhd 也是同理——它真正省的是你的阅读时间和耐心,而不是钱包里那张账单。这笔账,得算明白。钛媒体
10 条规则,逐条给你翻译成人话
废话不多说(这文章自己也得起带头作用),直接上核心。这 10 条就是整个仓库的全部精华,我照着原文翻译+解读,你看完就能用:
动作前置:第一行必须是你马上能做的事——一条命令、一个文件路径、一段代码,而不是背景铺垫。判断标准很粗暴:只看第一行能不能立刻动手。
多步骤必编号:超过一步的活,写成编号列表,每步只干一件事,不许一个步骤里塞两个"然后再"。作者有句话我很喜欢:“跑完的短路径,胜过被放弃的完整路径”——人放弃一个任务,往往不是因为太难,是因为步骤看着太长。
结尾只给一个下一步:如果还有没干完的,结尾给一个"2 分钟内能做完"的具体动作,“Next:” 后面必须跟动词,不许跟客套话。
压制跑题:发现第二个问题,先把第一个干完,再把第二个作为单独的问题抛出来,不许一句"顺便说一下"把话题带跑。
每轮重述进度:别指望用户记得"我们现在在 5 步里的第 3 步",每次回复都重说一遍,比如"第 3/5 步已完成"。
时间估算给具体单位:不许说"这需要一点功夫",要说"如果测试齐全大概 15 分钟,不齐全得一下午"。因为在被打断过的大脑里,"一点时间"和"几小时"感受是一样的。
让成果可见:干完的活要明明白白展示出来,还给出验证方式,别把"做到了什么"埋在复述里——埋了等于没做。
报错就事论事:禁止"哎呀"“糟糕”“好像出了点问题"这种情绪化开场,直接说清楚"哪一行、什么原因、怎么修”。报错信息是工具,不是情感剧。
列表最多 5 项:长列表要分组、把最相关的排前面,一屏里别超过 5 条,剩下的先收着,用户要了再展开。
禁开场、禁复述、禁客套:这是最硬的一条。禁止"好问题!"“让我来……”“希望这能帮到你”“随时问我”。原文的总结就一句话——从答案开始,答案说完就停。GitHub
给你看个仓库里的官方 Before/After 对比,一秒就懂区别:
改造前(典型 AI 腔):
“好问题!让我想想。你的身份验证流程包含几个环节:中间件、令牌验证和 Cookie 处理。看了 `src/auth.ts` 之后,`verifyToken` 函数似乎用了旧版 API。一种做法是升级这个包并重写函数。改完之后,你可能需要跑一下测试确认没弄坏别的。顺便一提,你或许还该整体检查下依赖版本。希望这能帮到你!”
改造后:
"运行 `npm install jsonwebtoken@latest`,然后改 `src/auth.ts:42`。
打开 `src/auth.ts`
把第 42–58 行的 `verifyToken` 换成下面这段
跑 `npm test – auth.spec.ts`
下一步:如果有测试挂了,把第一行报错粘给我。"
同样的信息量,后者你 5 秒就能动手,前者你得读 30 秒还未必找得到重点。
怎么用:分两种人
第一种:你就用 ChatGPT / 豆包 / Kimi / 通义这类聊天工具,不碰代码。 那你根本不用装什么仓库,直接把下面这段"输出契约"复制进工具的自定义指令 / 人设 / 系统提示词里就行(这是我把 10 条规则压缩成的通用中文版):
从现在起,请按以下规则回复我:①第一行直接给答案或下一步动作,不要背景铺垫;②多步骤任务用编号列表,每步只做一件事;③结尾只给一个我 2 分钟内能做的具体动作;④不要跑题,发现别的问题等我这件做完再单独提;⑤报错时直接说位置、原因、修法,别用"哎呀"“糟糕”;⑥时间估算给具体单位(分钟/小时),别说"一会儿";⑦列表每组最多 5 项;⑧禁止"好问题"“希望帮到你”"随时问我"这类开场和客套,答案说完就停。需要我详细解释时我会明说。
存下来,粘一次,之后这个 AI 就"换了个人"。
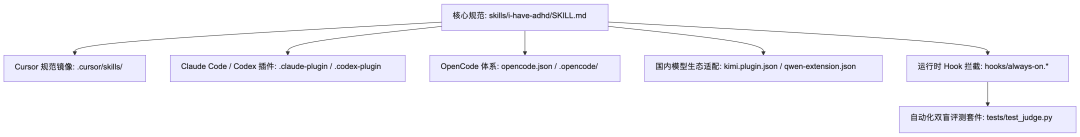
第二种:你是开发者,用 Claude Code / Cursor / Codex / 各种 CLI。 那可以直接装原版插件。仓库的 `INSTALL.md` 里给了十几种工具的安装方式,覆盖之广有点离谱——Claude Code、Cursor、Codex、Gemini CLI、GitHub Copilot、Zed,甚至国产的 Kimi Code CLI、通义 Qwen Code、讯飞 AstronClaw 都适配了。
以最主流的 Claude Code 为例,两条命令搞定:
```bash
claude plugin marketplace add ayghri/i-have-adhd
claude plugin install i-have-adhd@i-have-adhd
```
装完在对话框敲 `/i-have-adhd` 激活,想退出就说 “stop adhd mode”。想让它每次开新会话都自动生效,还有个 always-on 开关:`touch ~/.claude/.i-have-adhd-always`。通义 Qwen Code 更简单,`qwen extensions install ayghri/i-have-adhd` 一行。
顺便提一句,如果你嫌装插件麻烦,Claude Code 本身就内置了一个叫 “Concise”(简洁)的输出风格,官方文档的描述是让它先给结果、跳过铺垫和碎碎念,回答默认保持简短。不想折腾的话,可以拿它当平替先试试。Claude 官方文档
别急着无脑冲,反方声音也得听
到这我不想把它吹成万能药,因为社区里真实的反对和翻车也不少,这些你装之前最好知道:
它会"失效"。 好几位用户反馈,尤其是长对话里,规则撑不了几轮,AI 又会"打回原形"回到那种冗长腔。原因是有网友解释得挺到位:写在配置文件顶部的指令,会随着上下文变长被"稀释淹没";这也是为什么 Claude Code 的"输出风格"比手动写在 CLAUDE.md 里更持久——它每一轮都会被重新提醒。真要顽固生效,有人干脆写了个 hook,在每次回复结束时自动帮你压一遍。Hacker News
“这不就是一句 be concise 吗?” 这是高赞质疑。但也有人反驳得在理:光说"简洁点"效果并不稳,给模型一个"为什么"(读者有 ADHD),再配一套具体可判断的规则,比一句空泛的形容词管用得多。 这正是 140 行规则比 3 个单词值钱的地方。
命名有争议。 一些真正的 ADHD 患者对"人人都在 claiming 自己有 ADHD"感到不适,觉得这是在消费一种真实的、令人痛苦的疾病。但也有温和的声音:ADHD 人群为了正常生活总结出的那些应对策略,本来就是普适的高效工具,把它推广给所有人,没什么坏处。这个争论没有标准答案,你心里有数就行。
装任何第三方 skill,养成"先读再装"的习惯。 HN 上有人眼尖,发现仓库的 `AGENTS.md` 里嵌了一段让 agent 去某个 GitHub issue 下自动留言的指令。作者解释那个文件是给"帮这个仓库写代码的协作 agent"看的,正常安装 skill 只会拷贝 `skills/` 目录、并不会带上它。但这件事本身值得记一笔:往自己的 AI 工具里塞陌生人的配置文件之前,先打开看清楚里面到底写了什么,永远不亏。
我的判断
这东西值不值得用?我的看法很明确:
如果你是每天要用 AI 干正经活的人——写代码、写方案、查资料、做 PPT——那这 10 条规则几乎是零成本、高回报的改造。 不用花钱、不用换工具,复制粘贴十分钟,就能把你每天花在" scrolling 找重点"上的时间省下来。光冲这一点就够本了。
如果你只是偶尔问问天气、闲聊两句,那真没必要折腾,AI 那点客套话反而是聊天该有的温度。
再往大了说一层:一个 4.5 万 Star 的 i-have-adhd,一个 10.5 万 Star 的 Caveman,两个核心都是"纯文本规则"的仓库先后爆火。Caveman 甚至把"压缩到什么程度"拆成了从 normal 到文言文的六个档位。当"少说话"都开始有细化的档位规范,说明 AI 工具的下一个竞争焦点,正在从"模型多大、参数多少",转向"输出行为管不管得住"。 谁能把"说人话、给重点、不啰嗦"做成人人可移植的标准,谁就握住了下一轮开发者工具的入口。这比任何一个新模型发布都更值得普通用户关心,因为它直接决定你每天用 AI 是"省心"还是"心累"。钛媒体
下次你的 AI 又用"好问题!"开头的时候,你就知道该怎么治它了。
你被 AI 的哪种"废话"折磨得最惨?是"好问题"开场白、是"希望帮到你"的假客气、还是明明一句话能说清却非要写五段?评论区聊聊,我看看要不要把这 10 条再改改,出一版专治中文 AI 腔的。