














2
2
OpenAI和Anthropic同时推新模型:AI竞争从"谁更强"变"谁更便宜"
2026-09-23 15:15:57
0点赞
0收藏
0评论
 图片
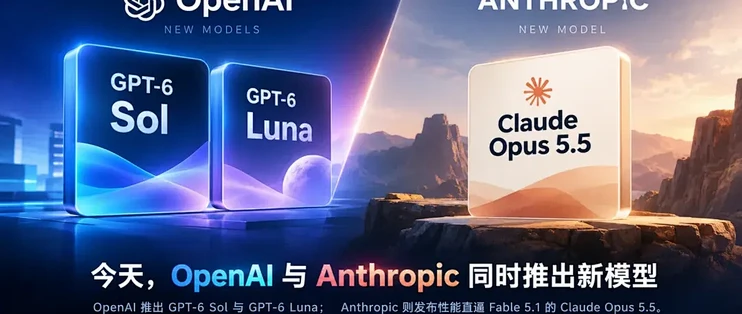
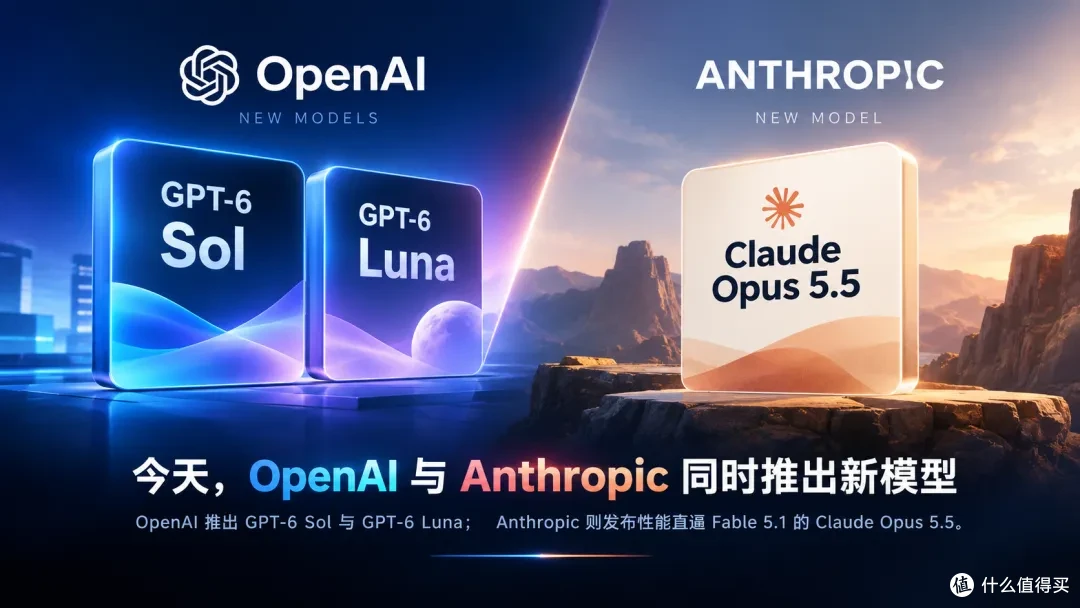
Anthropic和OpenAI在相隔约一个半小时的时间内,先后发布了各自的新模型。
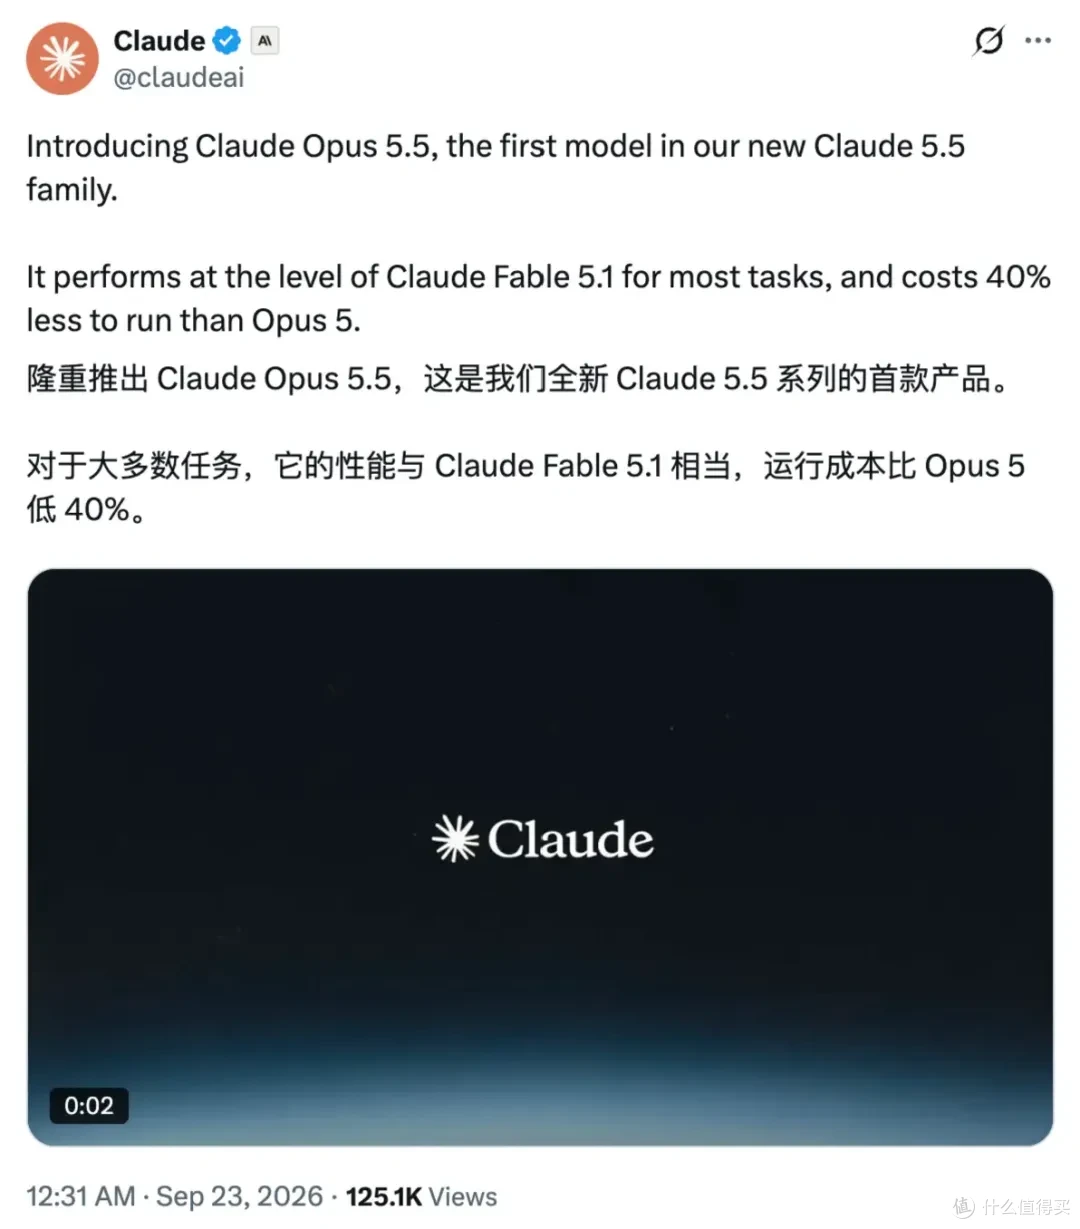
Anthropic先出牌:Claude Opus 5.5,Claude 5.5系列首款模型,性能追平旗舰Fable 5.1,成本降40%。
 图片
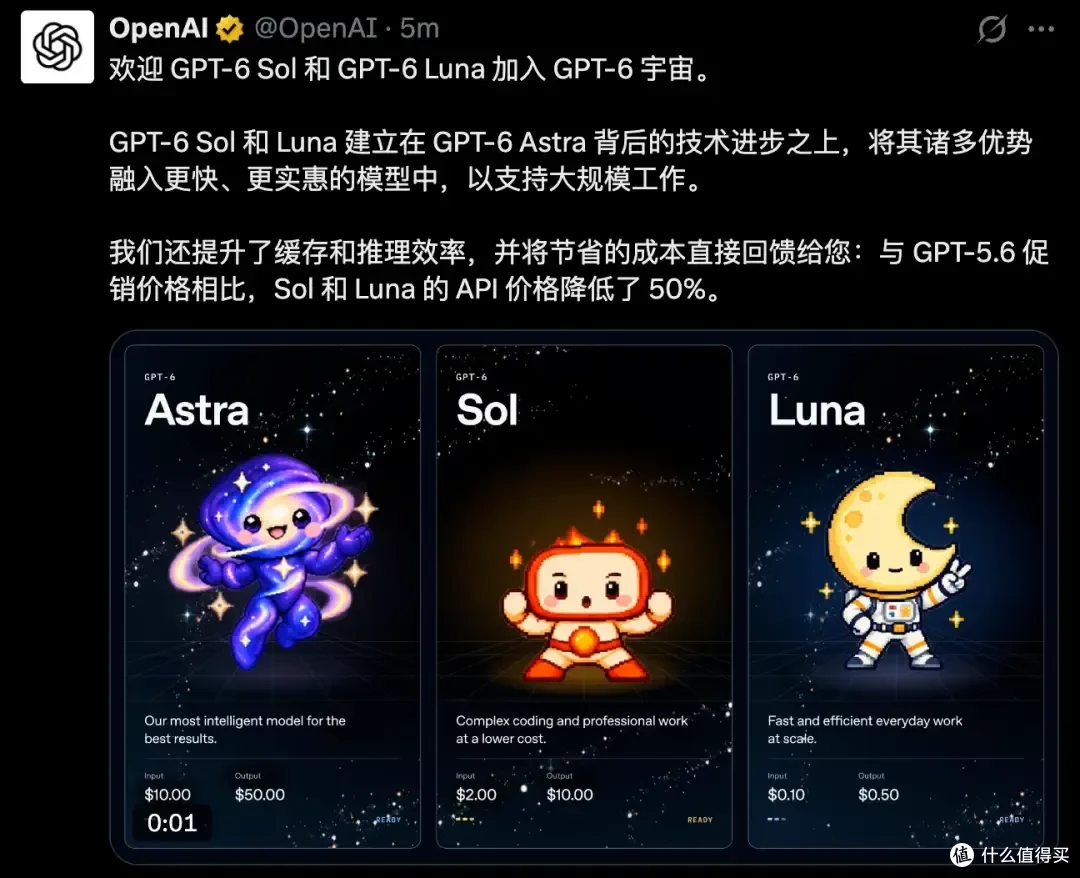
OpenAI紧跟着出牌:GPT-6 Sol和GPT-6 Luna,两款模型,API价格直接腰斩50%。
 图片
这不是巧合。这是两个被逼到同一张牌桌上的对手,在同一晚摊了牌。
牌面上写的不是"谁更强",而是"谁更便宜"。
三张牌,三种打法
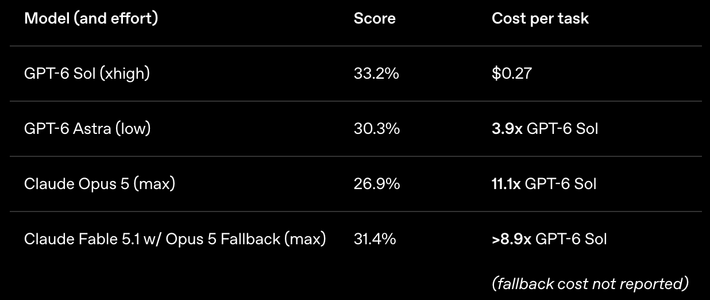
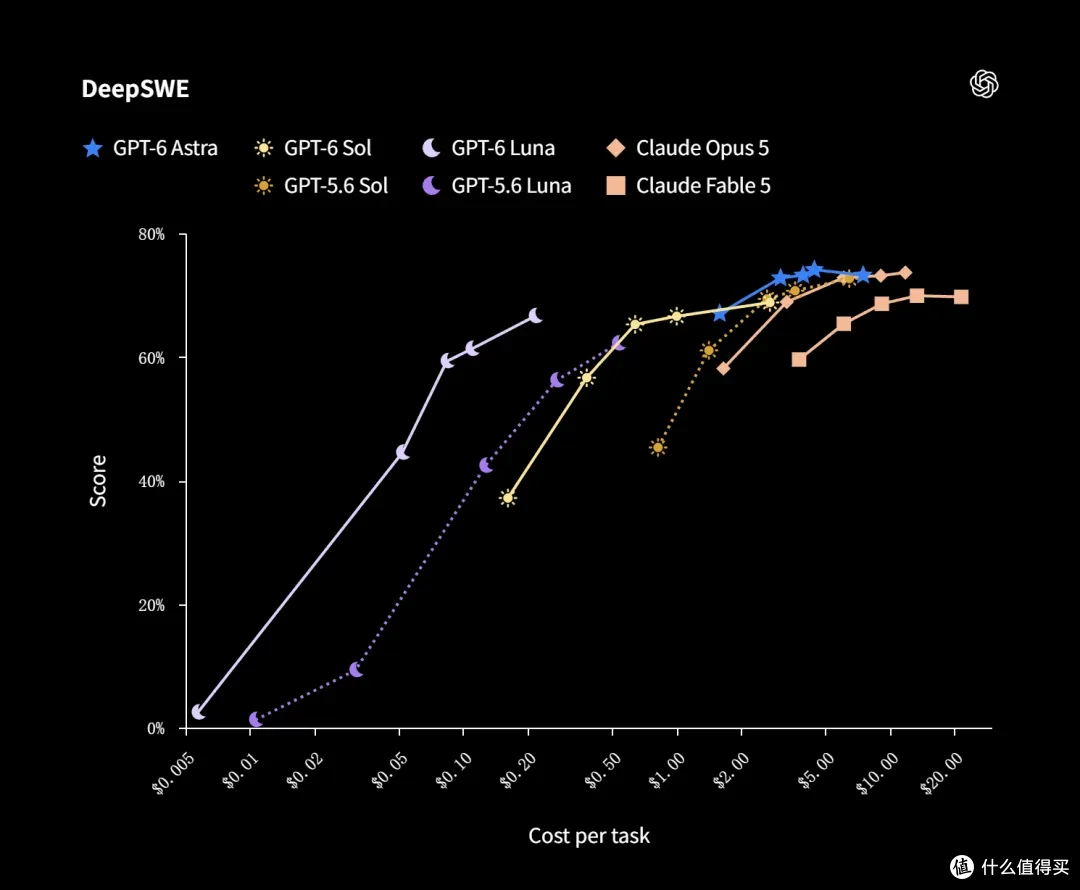
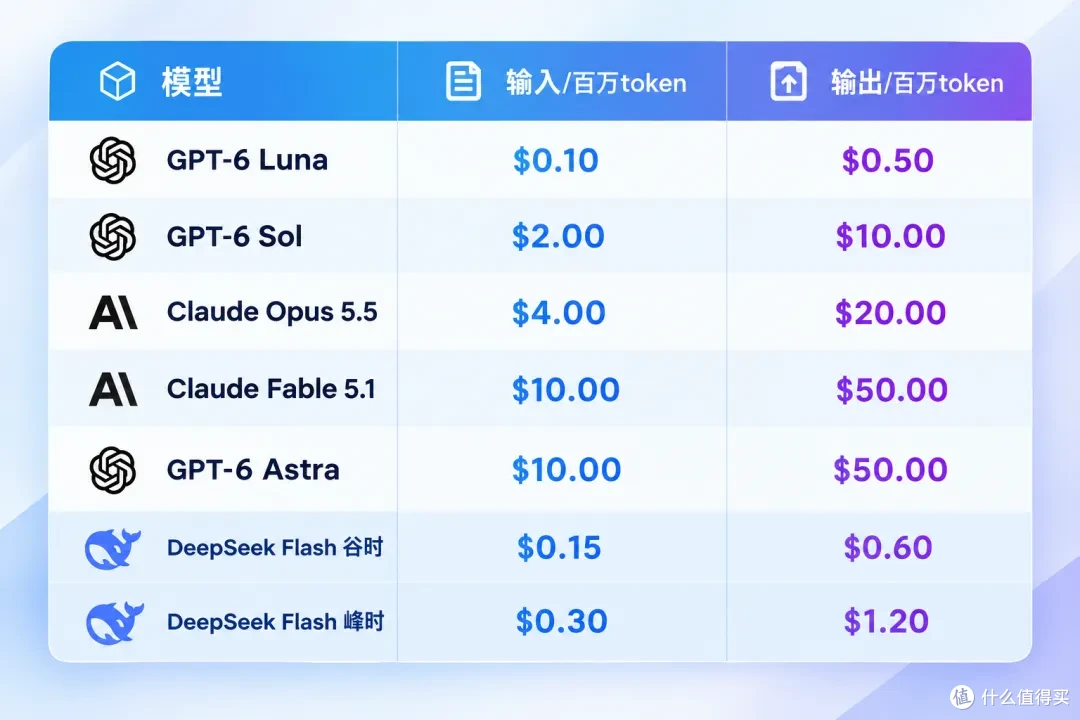
GPT-6 Sol——OpenAI的"超级大脑"。定位复杂编码和Agent工作流,继承Astra的部分能力,专门啃硬骨头。百万token输入2美元,输出10美元。在DeepSWE代码测试中跑到68.8%,距离Fable 5.1的69.9%只差1.1个百分点,但单任务成本低了约80%。
 图片
GPT-6 Luna——OpenAI的"效率狂魔"。面向高频轻量任务,速度快,成本低到几乎可以忽略。百万token输入0.1美元,输出0.5美元。一个0.1美元/百万token的模型,编码测试跑到66.6%,接近Opus 5和Fable 5的中等档位水平,但成本分别低了93%和96%。
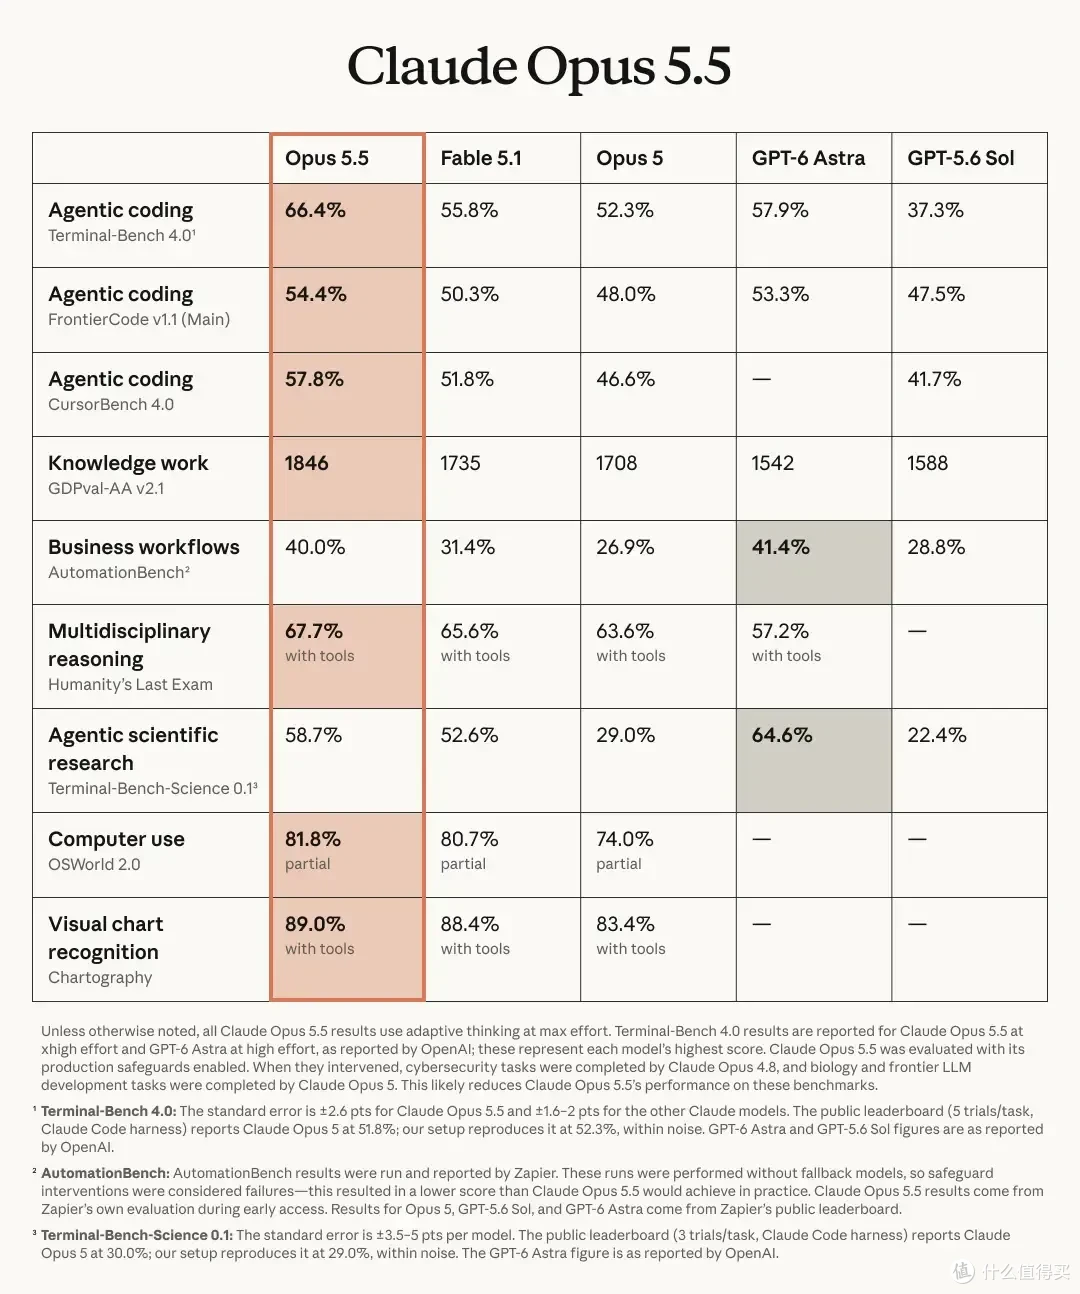
Claude Opus 5.5——Anthropic的"旗舰平替"。性能达到Fable 5.1水平,但成本降40%。百万token输入4美元,输出20美元。在Terminal-Bench 4.0上跑到66.4%,超过Astra的57.9%。不到一天完成68万行代码迁移,不到3小时审计修复20万行代码库。
 图片
三张牌,三种定位。OpenAI用两款模型上下夹击,Anthropic用一款模型正面硬刚。
价格战已经打到地板了
把三家模型的定价摆在一起看:
 图片
Luna的0.1美元/百万token是什么概念?DeepSeek V4.1 Flash闲时缓存未命中的输入价是1元人民币(约0.14美元),输出4元(约0.56美元)。Luna在普通请求场景下已经比DeepSeek更便宜,而且没有峰谷定价带来的成本波动。
中国开源模型把价格打到了地板上。现在OpenAI和Anthropic亲自下场,把地板再往下挖了一层。
性能差距在缩小,成本差距在放大
这次最值得关注的一个信号是:两家公司的发布重心,都不再是"我们的模型最强",而是"我们的模型在差不多的能力下,便宜了多少"。
OpenAI说:Sol用不到30%的价格,挤进了前沿Agent榜单。Luna用0.1美元的价格,跑出了接近旗舰模型中等档位的编码水平。
Anthropic说:Opus 5.5用四成的价格,把Opus硬生生塞进了Astra和Fable所在的最高能力区间。
两家都在用同一个逻辑讲故事:能力已经够用了,现在比的是谁能把成本压得更低。
这不是技术进步的自然结果,这是市场竞争逼出来的。
云应用公司Vercel的数据显示,来自中国的开放权重模型正在夺取美国实验室的市场份额。当你的竞争对手用十分之一的价格提供80%的能力时,你就没有资格继续卖全价。
Fable 5.1,最尴尬的那个
这一轮发布中最尴尬的,可能不是OpenAI也不是Anthropic,而是Anthropic自己的Fable 5.1。
9月1日才发布,满打满算只坐了三周最高档。然后Opus 5.5就追上来了——性能相当甚至反超,价格只有它的四分之一。
Fable的档位设计本来是:Sonnet负责日常,Opus承接复杂任务,Fable再往上顶能力上限,Mythos则是受限开放的最前沿。
但现在Opus 5.5从下面追上来,Mythos在上面压着,Fable 5.1被夹在中间,越来越像一层"缓冲垫"。
媒体的评论说得很直白:"Fable越来越像两头受气。"
结语
9月22日晚上的这场"对台戏",标志着AI模型竞争正式从"能力军备赛"转入"成本碾压"阶段。
OpenAI的路线是"分层下放"——用Astra做旗舰标杆,Sol和Luna把能力下放到更便宜的档位,让每个预算区间都有产品。
Anthropic的路线是"旗舰平替"——用Opus 5.5把Fable级别的能力,以更低的价格推给更多用户。
两条路线,同一个目标:让百万token的价格,不再是企业客户做决策时的心理障碍。
Axios的分析说得很准:随着模型价格走低,使用量会明显上升,这可能为数万亿美元级别的AI投资提供支撑。
当百万token单价全面下探,AI服务正在褪去奢侈品外衣。
下一个问题不是"谁的模型更强",而是"谁能让企业用户花更少的钱,做更多的事"。
这不再是技术竞赛。这是一场成本战争。