这两周本地推理圈在同时算两笔账。一头是办公智能体突然开了门:WorkBuddy、TraeWork等AI办公应用支持接入本地部署的大模型,不要API Key、不按量计费。新华财经9月14日的报道干脆把话挑明了——中小参数模型正加速进入办公场景,能跑20B到100B的整机,价格区间在1万元至6万元。另一头,是量化新势力被塞进Agent里实测:把27B压成−1/0/+1三态权重的Bonsai2-27B(Ternary-Bonsai-2,GGUF版)在Hugging Face模型热榜登顶,单卡乃至高端笔记本即可本地跑,近三十天下载190万+。而B站测评区里吵得最凶的,已经不是"能不能塞下",而是"塞下了能不能干活"。知乎新华财经哔哩哔哩
如果你手里是12G到16G显存、本地模型聊天已经跑顺、正盘算着把它接进WorkBuddy或Codex替你干活,这篇只服务这个档位。你要解决的问题不是"装不装"——是接哪个模型、按几笔账接。
两周内的社区实测账,跨平台一次看完
玩客笔记(B站,9/20):RTX 3060 12G + Bonsai2 PQ2_0(7.2GB)。7.2GB 的 Bonsai 2 27B 三进制量化模型,RTX 3060 12G 单轮推理非常强,但一放进真实 Agent 循环就频繁超时。三阶段调优实录:静态Prompt下思考Token省30%、耗时省20%,仍然踩25步红线;上Harness动态Steering后步数26→11、耗时9分钟→2.5分钟,但冒烟测试误判翻车;最后他自研了开源收敛插件(pi-extension-convergence),全量回归才全绿。哔哩哔哩
AI观模者(B站,9/20):Bonsai2对打Qwen3.8-27B-GSQ-RCO同题测评,三天破万播放、456收藏、222条评论。UP主给出Bonsai2整体质量不如GSQ-RCO的结论,评论区直接吵翻:有人搬出"AA榜测出gpt6不如muse spark后,AA榜自证野榜"的旧账回怼测评口径。也有人反驳"16G部署GSQ是能部署,但速度比Bonsai差太多,常规任务反而是Bonsai划算"。哔哩哔哩
评论区长测层:一个被多次点赞的评论说得很直白:所谓维持原版模型多少多少性能其实都是不太真实的,控制智能体的效果一般都会很差。另一边是具体故障:模型自己输出停止token导致截断,多位用户跟帖复现;还有Pro 6000用户提醒,第三方量化权重"跑分没毛病,长时间使用能跑一天不出问题就阿弥陀佛"。
知乎(9/21当天更新):五款部署工具横评的结论是,真正拉开体验差距的早就不只是tok/s,而是模型能不能下到、新模型找不找得到、能不能接入Agent、长对话里KV Cache能不能复用。已经部署在 Herdsman 里的本地模型,可以一键配置到 WorkBuddy、Codex、Claude Code 等工具中。知乎
知乎长测帖:5060 Ti 16G用户折腾半年,三个用途两个行不通,给出的死因是:不是模型不想,是上下文长度和推理速度撑不起这种多轮来回。云端Agent一天试错的次数,他这边一上午才走完一轮。知乎
账目摊开,规律是同一个:模型聊天都正常,一干活就多出一张账单。
为什么省下的显存,会被Agent连本带利收回去
"98%性能保留"这种话,是在单轮问答里测的:模型答一次,完事。Agent的考法完全不同——考收敛。
三值模型保住正确率靠的是不断自查,有用户实测下来发现收敛能力差的话基本压不住,落到真实任务就是社区说的"雷霆思考":一道五子棋思考两万Token;“生成一个3D射击游戏”,一小时了还在思考;同一道编程题,官方q3量化需要10k上下文,这个模型就需要60k。上下文一涨,显存跟着涨:另一位用户报的数是7.2G模型开64K上下文、总占用13G。文件端省下的5、6个G,KV Cache那边原形奉还,还带利息。哔哩哔哩
办公智能体这边,上下文地板更高。这些应用会把技能、记忆、文件环境一起塞进上下文,也许你发个"你好",上下文给你塞了16000字。接入办公应用时上下文最好给到32K以上、最好64K;而Ollama默认将你的上下文设为4Ktokens——Agent的中间步骤会被无声截断,表现出来就是"像个失忆的"。顺带一提,知乎有实测称同一模型128K上下文下Ollama的prefill只有llama.cpp直连的一半——接Agent觉得本地变笨,先查框架和上下文,再怀疑模型。知乎哔哩哔哩
还有第三笔:时间账。30 tok/s听着快,乘以两万Token的思考量、再乘以十几步循环,一个任务就是小时级。Agent的价值在于快速试错来回跑,本地量化模型恰恰在这两个乘数上都吃亏。
所以"量化模型+Agent"的正确预期不是"保留98%",而是:聊天保留98%,干活可能只保留一半。测评榜和干活榜,根本是两张卷子。
装之前,按档位算完三笔账
你的配置 | 接Agent的现实选项 | 别指望什么 |
|---|---|---|
8G/12G显存 | Bonsai2的q2档(7.2GB,多位用户实测"接近官方Q3水平",且比5.9G的q1明显快)+上下文控制在16K以内+上收敛插件 | 别指望无人值守干长活;聊天、摘要、定时任务才是它的位置 |
16G显存 | 官方底座的社区精调量化(GSQ-RCO这档,质量共识更稳),或Qwen3.5-35B-A3B这路MoE——元空AI新发布的Boxer就是基于它后训练,在一台40TOPS算力的消费级PC上,对话延迟接近真人交流,运行内存占用约8GB | 别追三值省那点文件体积,你缺的不是那5个G,是步数和时间 |
24G/48G显存、32G+内存Mac | 直接官方Q4起、大内存上Q8;测评区UP对"要不要换Bonsai"的回复就是标准答案:“你能部署的了 Q6,这硬件不需要考虑 bonsai” | 你的瓶颈只剩时间账和插件生态,不是显存 |
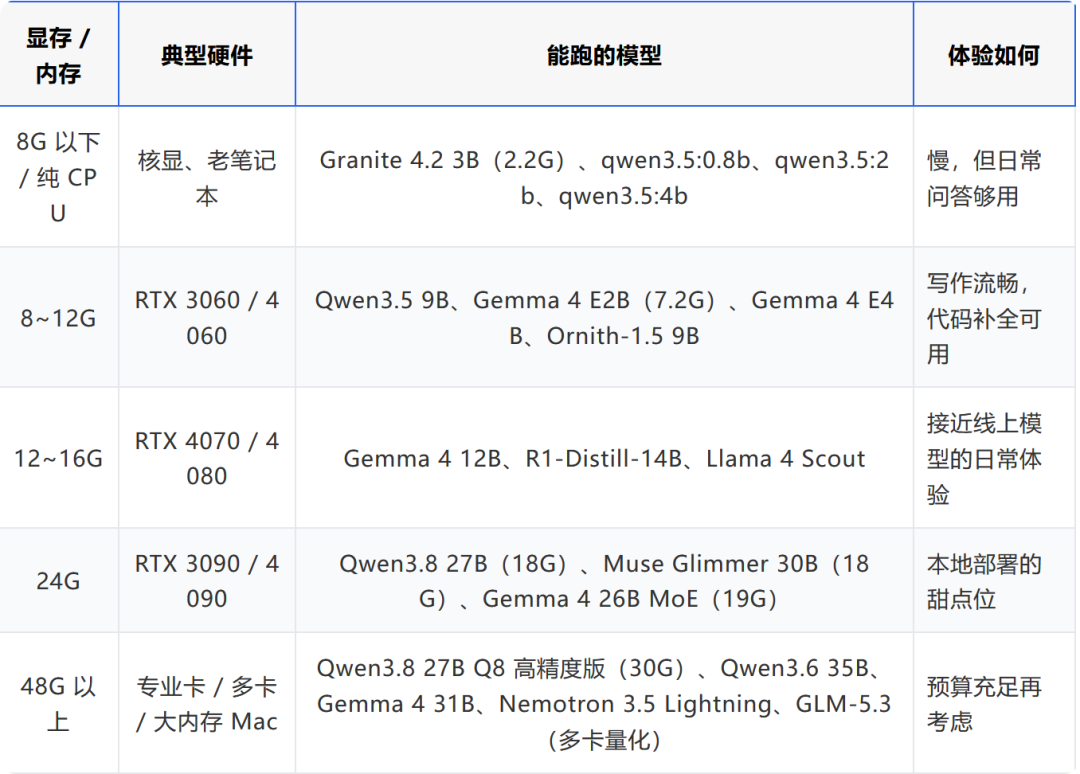
如果看完这张表你动的是"买张新卡接WorkBuddy"的念头,先把行业报价摆出来:现在能跑20B到100B的整机,价位1万到6万元(新华财经)。这个预算下,Gartner管理副总裁那句提醒同样成立——一个智能体能否按权限找到正确版本的文件、调用业务系统、在失败后恢复,比能装下多少参数更能决定其办公价值。模型只是半件事。新华财经
顺便劝退两个误入的切片:如果你入场只是为了API太贵,这三个国产 Flash 模型,已经做到"一杯奶茶钱"跑一个月的程度了。本地Agent对低频用户不成立;如果你的动机是不想上传敏感数据,那更该先搞清楚权限和审计,而不是先挑量化文件。知乎
接下来盯什么
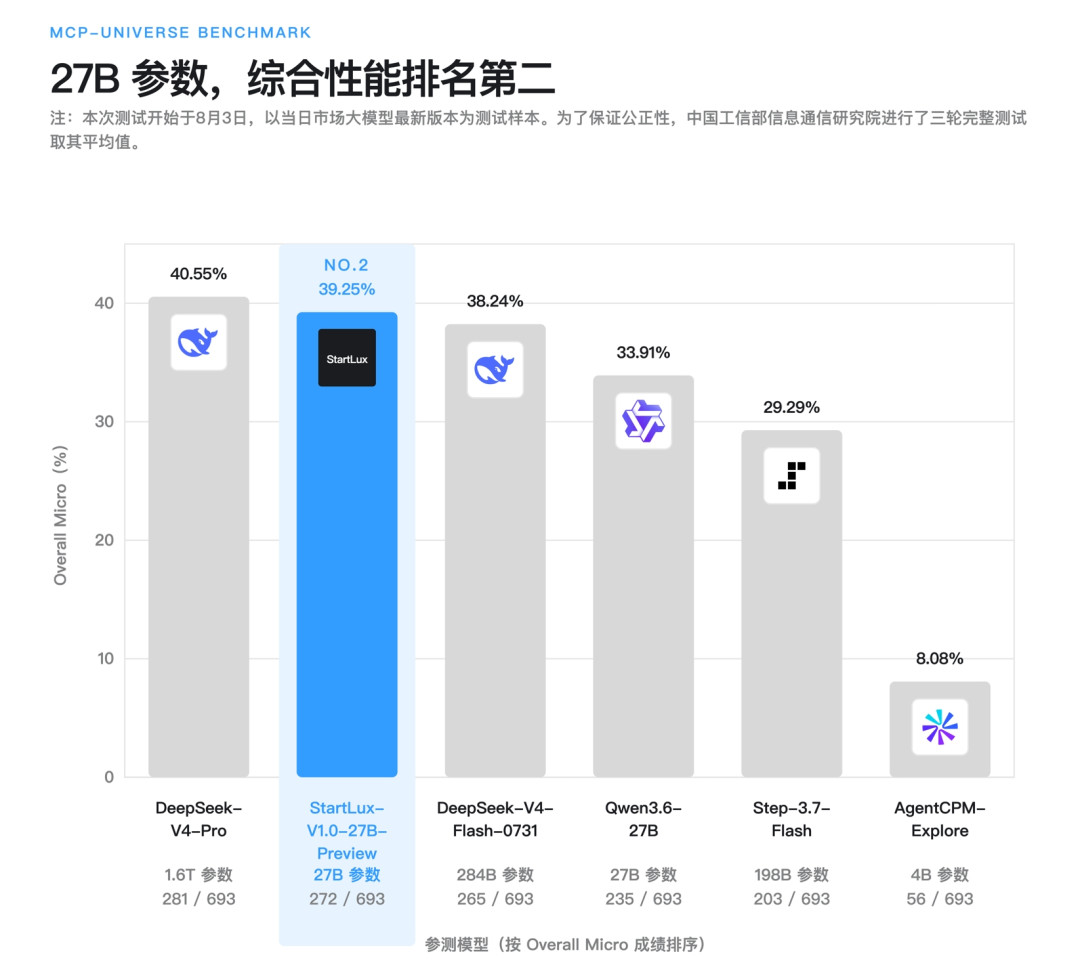
"为Agent而生"的27B线:原点星辉发布的StartLux-V1.0-27B-Preview,以Qwen3.6-27B为基座、面向工具调用与通用智能体场景后训练,在工信部中国信息通信研究院可信AI大模型基准测试的MCP(模型上下文协议)专项测试中,StartLux综合性能超越多款千亿参数大模型。下一轮量化军备竞赛比的可能不再是文件大小,是步数。新华财经
长测成绩单:现在所有Bonsai/GSQ的测评都是48小时内的横评,"能连续跑一天不出问题"级别的30天日志还没人交卷。
收敛插件的通用性:pi-extension-convergence目前是为Bonsai写的,它对满血Qwen3.8有没有同样效果、AMD平台(目前是0day手动重编译)何时跟上,都有人等着。
办公应用的本地模型白名单:WorkBuddy们开放接入之后,大概率会给出官方认证模型清单——在那之前,你都是公测员。
Mac mini新机明后天开售、办公应用刚开门、量化把27B干到7.2GB——这三件事都没错,错的是把它们记成一张账。本地模型接Agent,本质是拿自己的机器付三笔钱:显存档、上下文档、步数档。哪一笔赖掉,Agent都会替你补上,利息是你的时间。