

RAG没被长窗口搞死!LLM应用开发的5个上下文大坑
年末复盘季,做LLM应用的朋友十有八九被问过同一个问题:“都2026年了,长窗口这么能打,RAG是不是已经死了?”
有人言之凿凿:拆了Codex和ChatGPT的记忆机制,压根看不到RAG的影子。但把今年的翻车案例摊开看,结论恰恰相反——RAG没死,死的是把上下文当硬盘用的用法。这5个坑,今年埋掉的上线项目不在少数。
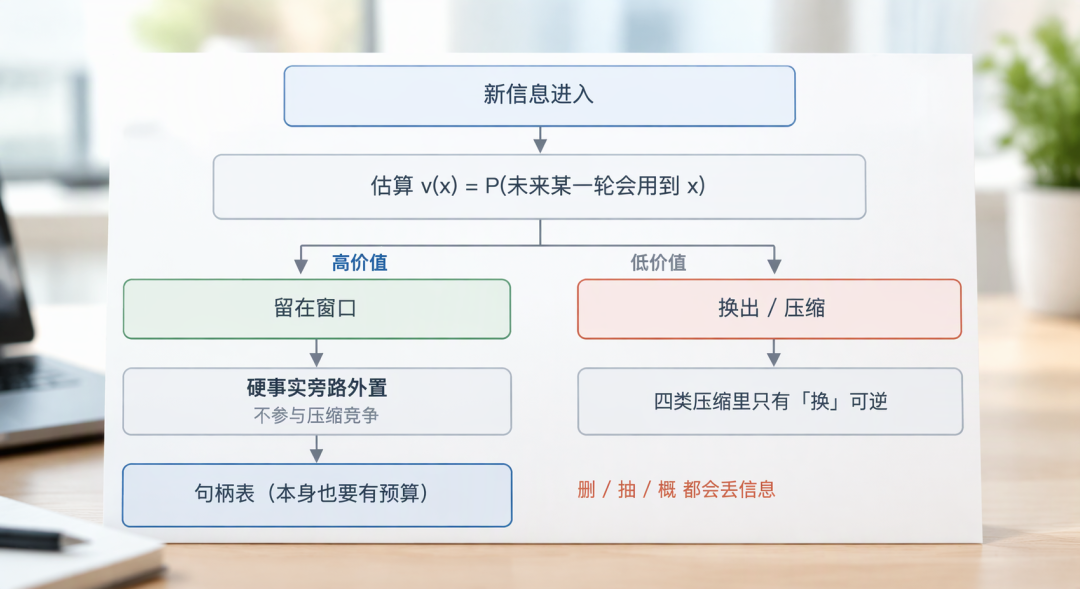
坑一:把180页手册全塞进窗口
真实案例:一个团队把180页产品手册全部塞进200K上下文,想着"都在里面了,总不会漏",结果用户问"保修期多久",模型答错;改成检索出最相关的3段放进去,反而答对了。这不是玄学:模型对开头和结尾的信息用得好,对中间的信息显著变淡;而容量并不等于准确率,窗口越大越不能什么都塞,既贵又稀释注意力。这两年的长上下文模型确实缓解了不少,但"塞满窗口既贵又未必更准"这个工程结论,到现在都没变。知乎知乎知乎
坑二:把"RAG已死"当选型结论
说"RAG已死"的人有个前提搞错了:确实有人把Codex和ChatGPT的记忆机制拆开看过,后台专用Agent管记忆,完全看不到RAG的影子。但这两件事根本不在一个层面上:上下文工程解决"上下文怎么给",RAG解决"上下文从哪来",是上下游,不是替代。上下文工程做得越好,越明白"不塞什么"比"塞什么"值钱——只要知识还在更新、还要权限隔离和可核查的证据链,检索就是砍不掉的一环:RAG真正的价值不只是让模型知道新知识,而是把答案锚定到可回溯的证据上。知乎知乎
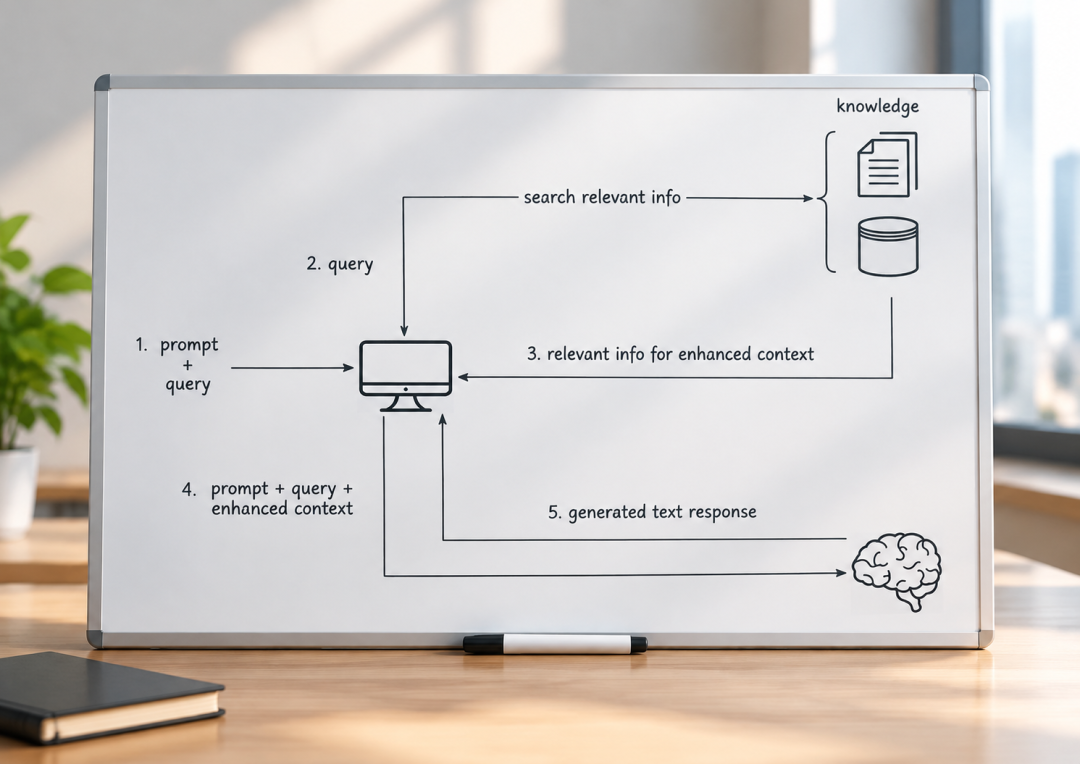
坑三:Demo一次过,就以为能上线
“RAG一天能搭出demo,一个季度可能都上不了线”——卡住你的通常不是模型,而是切块、召回、排序这些脏活,每一步的默认值基本都是给demo用的。评论区被反复追问的两个最难点:切文档和做评测。召回不准,模型再强也是在错的材料上发挥;没有评测集,你连改好了还是改坏了都不知道,只能靠猜和试。排障纪律也送你一条:检索和生成分开评,先查正确材料有没有被召回,再查生成端——两件事混着看,永远分不清是"没找到"还是"找到了没读懂"。知乎
坑四:长任务跑到第40轮,AI开始自相矛盾
长任务跑到第40轮,过期的工具返回、被纠正过的旧结论、互相矛盾的历史摘要全堆在窗口里,模型一视同仁当成"当前事实",于是开始自相矛盾——业内管这叫上下文腐烂(context rot)。应对思路和操作系统管内存一样:别预加载,按需加载;中途结论写进外部文件,窗口里只留指针;滚动压缩时务必保留"已确认/待确认/已废弃"三类标记,否则纠错信息会被压没。记住一条边界:内存页能原样换回,摘要掉的信息回不来,自动压缩永远不是无损优化。知乎
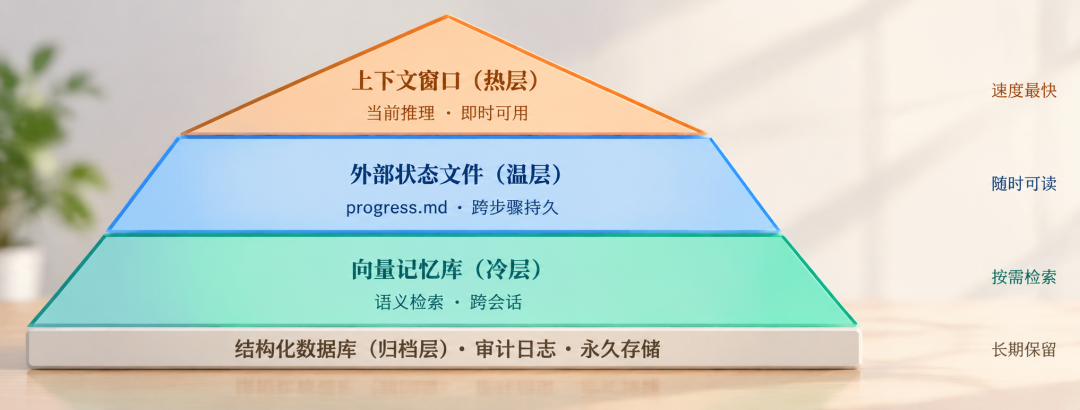
坑五:优化半天提示词,不如把缓存命中率拉上去
上下文窗口的台面就那么大,每一轮都在抢位置。三个工程指标决定生死:预算、命中率、缓存命中。很多团队死磕提示词的收益,远不如把固定前缀稳定下来、把KV Cache命中率从20%提到80%——后者直接决定延迟和账单。知乎
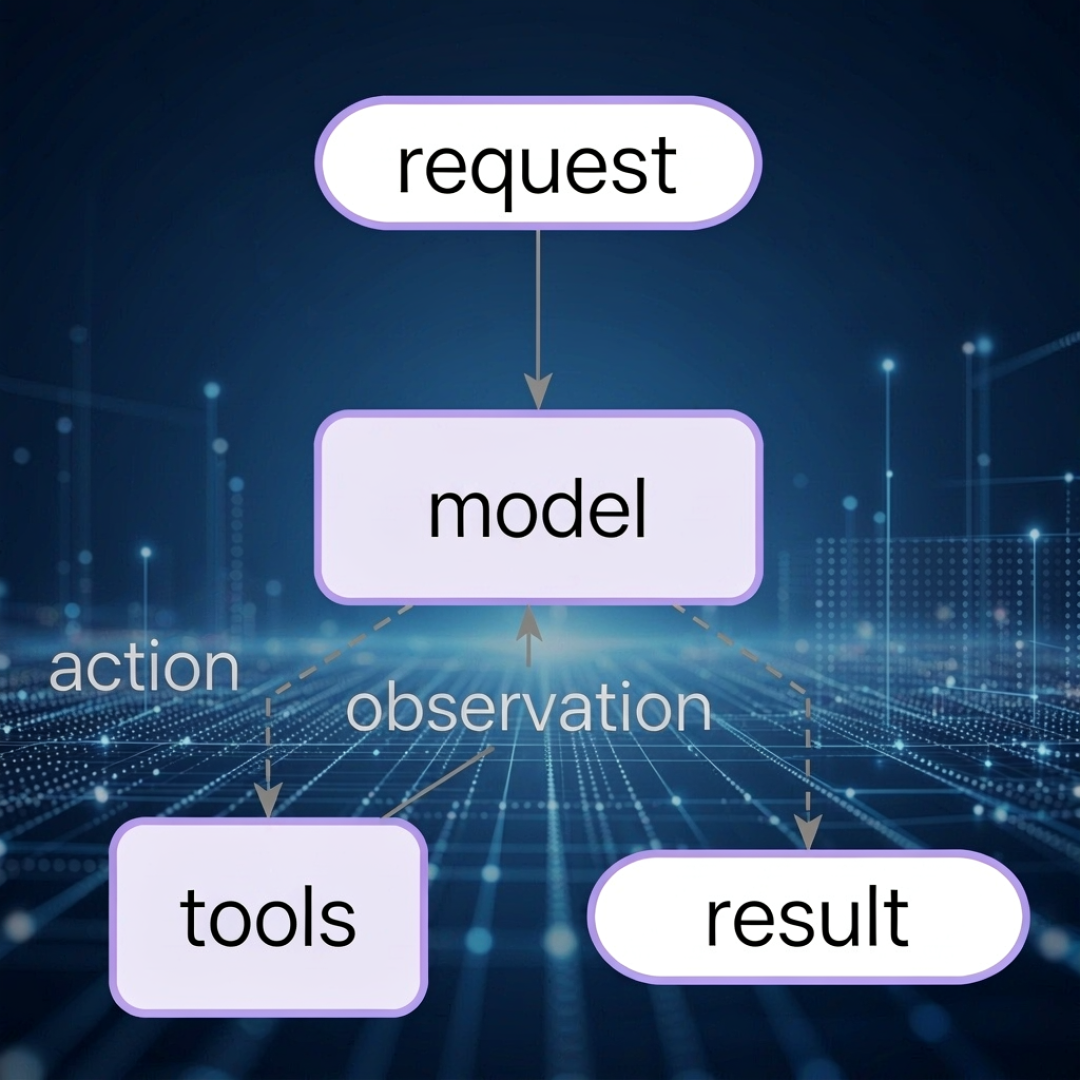
写在最后
今年这场"上下文之争",其实没输赢:能力放参数、知识放上下文、预算放缓存、质量底线放评测。别再问RAG死没死,先问自己这5个坑今年踩过几个。

当前文章无评论,是时候发表评论了