

11月15日开始,DeepSeek悄悄砍了一批功能。
超过7天不活跃的长对话不再支持继续,单次输入上限也收紧到约四万字。知乎知乎
对文档用户最狠的是这条:上传一份430页的招股书,系统提示由于算力不足只能阅读前20页或1万token,实际测试里它只读了10页。截至发稿,官方完整限流规则还没公布。换句话说:你的PDF会断在哪一页,全看运气。知乎知乎知乎
但先别急着换工具。剧透一个扎心结论——这轮限流也暴露了一个现实问题:把完整长文档一股脑喂进对话模型,本身就不是稳妥方案。就算没有限制,也不该这么用。知乎
为什么"帮我总结全文"是效率最低的用法
主流模型确实能吞下几十万字,但你让它"总结全文",它只能抓住开头、结尾和标题里反复出现的词,中间那段恰恰是它看得最松的地方。一次性灌入大量token,冗余信息会稀释重点,漏读、产生幻觉的概率明显升高。小红书知乎
小红书上有人分享过审合同的教训:一份68页的合作协议,直接问"这份合同有什么风险",AI答出"注意付款条款、注意违约责任、注意知识产权"三件套——三句全对、三句全没用,真正的坑却藏在第41页一个附件条款里,它压根没提。小红书
两步法,只比"总结全文"多打一行字
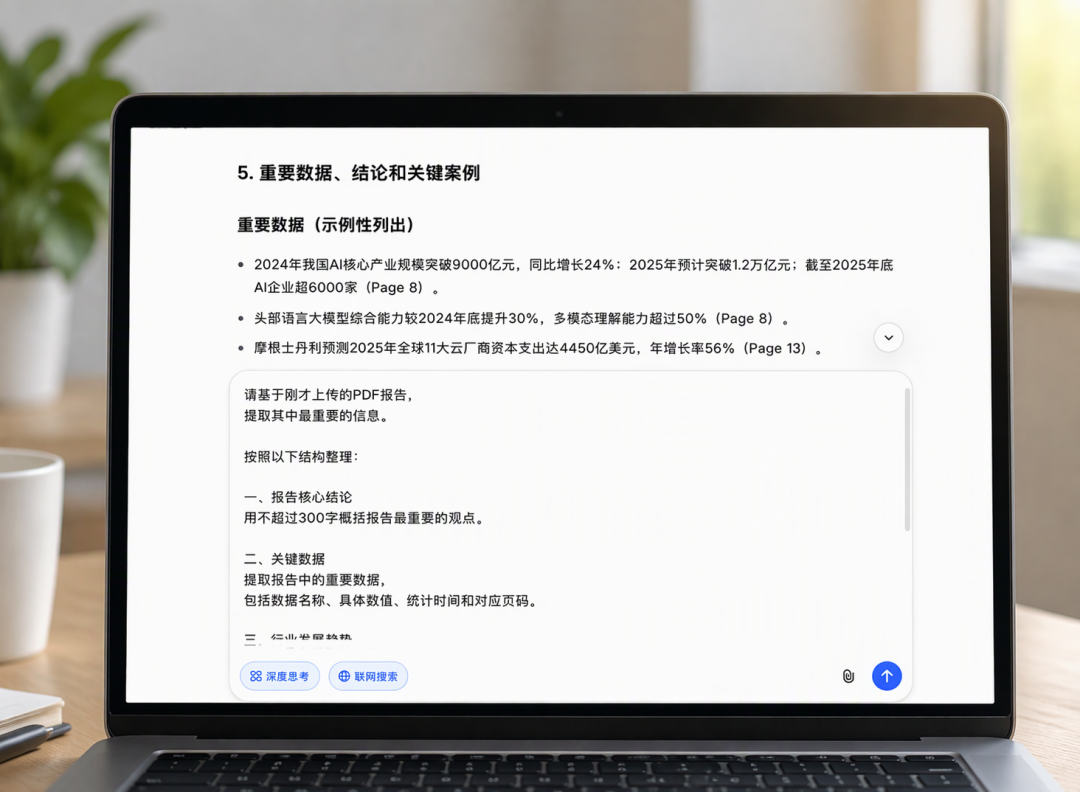
第一步,别要总结,要索引:
先不要总结。按章节输出索引:章节号、标题、页码范围、每节一句话说明,以及这一节里出现的所有金额和时间节点。
这一步不是让它读懂,是给你一张地图:68页变20行,30秒就能看出哪节必须细看。小红书
第二步,锁定小节定点问,必须带范围:
只回答第 3.2 节(第12-14页)。这节约定的验收标准是什么?逐条列出,并引用原文句子。
关键词是"只回答"和"引用原文"——不设范围它就自由发挥,不要求引原文它就编不动。这样给出的答案,才谈得上翻回原页核对。小红书
更省算力的三个补丁
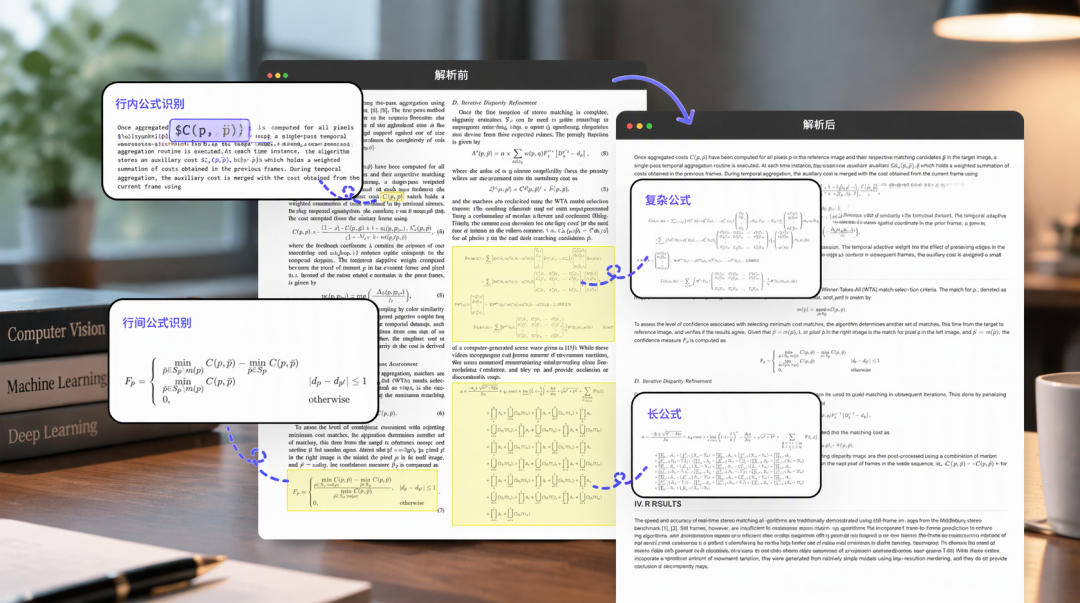
先转格式再喂:有同学被导师要求用AI从一本书里整理某位历史学家的全部论述,结果第一步就卡住——被告知没办法直接看PDF文件里的内容。评论区给出的解法,是用MinerU、PaddleOCR这类工具先把PDF转成Markdown再交给AI,token消耗低一大截。小红书
真的超长就分批:按200页一段传,每段先要索引、再定点提问,别指望一口吃成胖子。
最后一步永远是核对:先让它生成段落索引、标注每节页码范围,看定位准不准。页码对不上,说明这份文件它根本没读进去,之前所有回答都要打折。小红书
DeepSeek会不会放开限制没人知道,但趋势已经摆在这儿:在线免费通读超长文档,大概率会越来越紧。与其把活儿押在别人的算力上,不如学会精准定位式读法——范围越窄,答案越实。
你最近让AI读过多长的文档?它漏过什么关键内容?评论区聊聊👇
当前文章无评论,是时候发表评论了