今年10月的知乎上,有两个方向相反的现象同时在发生。
一边是"弃坑"声浪:《我做了8年知识管理,去年把印象笔记停了》被翻出来讨论。高浏览问题《如何建立永不坍塌的个人知识库?》上线一天多拿到近2.8万播放,热答开头就是自责——“我一度以为问题在工具,后来发现是我把知识库当成了仓库”。《2026年了,你目前在使用什么软件做知识管理》下面,有人直接质问:Obsidian如果只是给md文件换个存放位置,那我存哪不是存,非要用Obsidian的意义在哪?知乎知乎知乎
另一边却是入坑数据的爆炸:B站5月一条《Codex联动Obsidian,搭建卡帕西同款知识库》,播放38万、收藏2.56万。6月的Obsidian接AI智能体教程,点赞3万。小红书4月的《搭建全网千万收藏的AI第二大脑,3分钟教你》,点赞9712、收藏19219。收藏比点赞还高,这是典型的"先存为敬"行为艺术,而存的东西恰好就是一群人所批判的"囤积"。哔哩哔哩哔哩哔哩小红书
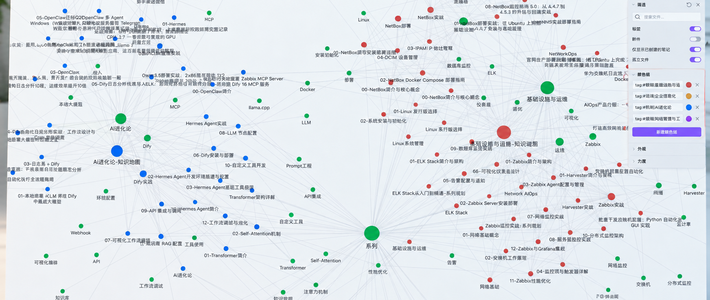
工具比任何时候都热,弃坑的人也比任何时候都多。把两边证据放在一起看,答案其实不矛盾:死掉的是"存起来以后好找"这个功能,活下来的第二大脑,正在换工作。
一笔算得出来的烂账:仓库模式的三个死因
先看在库时间最长的那批人自曝的数。知乎《在AI时代,个人知识管理(PKM)还有存在的意义吗?》下有条被反复转述的回答,答主给自己八百九十篇存量的库做了次审计:能"替自己说话"的判断只有四页;一年里归档了467条,其中226条存进来那天起一次都没被打开过。目录排得整整齐齐,全是"谁说的、什么时候、原文在哪",没有一句"所以呢,我打算怎么用"。知乎
这不是个例的整理能力问题,把各平台的复盘帖交叉起来看,是结构性的三个死因:
第一,"找"这个动作被AI外包了。以前建库的核心目的是检索——分类、标签、双链,都是为了将来能捞出来。现在问一句话,几秒内全文库相关的东西都浮上来,检索溢价归零。库如果只有"好找"这一个卖点,卖点没了。
第二,治理成本被严重低估。有做项目知识库的用户实测:库里规模一大,新增资料和旧资料会互相矛盾,多个分类下混着不知怎么用处的冗余内容。一开始还能隔段时间清理整顿,“后来就难免有些懈怠”——仓库越大,维护是复利增长的负债。知乎
第三,输出率低到可以忽略。890比4,99.5%的输入没有兑换成任何判断。做了8年知识管理的人把上百个分类停掉,认定"这套老办法不值钱了"。知乎
三个死因指向同一件事:你存的是别人的信息,不是自己的知识。而这恰恰是AI时代最不值钱的部分。
活过来的那批人,给库换了个工种
有意思的是,同一批讨论里,"弃库派"和"新库派"用的是同一套工具,得出的结论却相反——因为后者改变了往库里写什么。
知乎10月那篇《2026年个人知识管理的标准答案》把分歧说透了:RAG式的库是死的,喂进去100篇就永远是100篇,检索还是黑箱,AI答得头头是道,你不知道它漏了你笔记里最关键的那段——“你以为AI基于你的全部知识回答了,其实它只基于它’觉得相关’的那20%”。而AI Agent能读写你的笔记库,能解释引用了哪几篇、漏了哪几篇,库才第一次变成"跟你一起思考的伙伴"。那句高浏览回答给出的方案更干脆:库分两层,资料层只记出处(这层AI完全能替你补,还补得快),判断层只写一句"所以呢,我打算怎么用"(这层AI补不了,因为它不知道你的成本线在哪、哪条路你试过走不通)。知乎知乎
那个"890篇配4页"的答主还补了一句很实在的观察:这个库以前是给人看的,现在主要是给AI看的——语气、排版都不重要了,重要的是每句话说清条件,“它要拿去做事,含糊一句就办错一件”。知乎
“永不坍塌"那篇的答主则给活库定了三条纪律:每条新输入必须链接1-3条旧笔记(分类是仓库思维,链接才是知识库思维);每周做一次"一张卡→一篇输出”,写不出来这张卡就不算你的;AI只提醒、不替你做判断。知乎
把三个人的说法合并成一个公式:库的价值 = AI能在你的输出里引用到的你的判断密度。囤积时代比谁存得多,Agent时代比谁的判断值得被引用。
跟自己的库算笔账:三种人三种决定
交叉比对这么多帖子和实测数据后,与其站队"要不要用Obsidian",不如先对号入座:
临时检索型:别建库,直接用。只是偶尔查资料、写个周报,建库的启动成本(工具学习+迁移+长期治理)永远收不回。Notion、ima这类内置AI的方案或者干脆直接问AI,就是对的方案。省下的时间就是赚的。
判断资产型:值得建,但换个建法。长期写作、研究、做项目,需要AI理解你的立场和踩坑史——这类人适合本地Markdown库+Agent的组合,数据主权是长期账:几百篇笔记三五年后是几千篇,平台改价、关站你扛不住,本地文件"10年后还能读"。代价是每天多花10分钟写"所以呢",每周强制一次输出。做不到这两条的,别怪库变坟场。知乎
存量被困型:先清账,别弃坑。库里已经躺了几百上千条的,最划算的不是推倒重来,而是抽检:随便挑10条旧笔记,问自己"这条里我独有的判断是什么",答不上来的,降级成纯资料层(只留出处);答得上来的,用一句话把判断写进正文。今晚就能做,做完你的库立刻从仓库变成交接文档。
接下来盯什么
这场争论其实已经给出了风向:讨论的焦点正在从"哪个软件"挪到"往库里写什么"。可以观察的信号有三个:Obsidian在10月14日更新了1.14版本,一口气上线5项重大升级。更新日志明显在向"被AI读写"靠拢;B站上驻扎进笔记软件内部的Agent工具评测开始密集出现;小红书、微博上的教程关键词,从"界面好看"“插件推荐"变成了"笔记蒸馏”“AI自动整理”。哔哩哔哩
如果这三个信号都加强,那么"第二大脑"这个词的含义,今年就算正式改写完:它不再是你外挂的硬盘,而是你和AI之间那份写着你判断力的交接说明。
你的库里,判断和资料的比例是多少?欢迎评论区晒一下你的审计结果——反正890比4这种事,多一个人晒,就少一个人独自踩坑。