10 月 26 日凌晨,Kimi 把一封道歉信置顶在 K3.1 Pro 发布文章的评论区。
两天前,这个模型刚带着“国产最强”的期待发布。
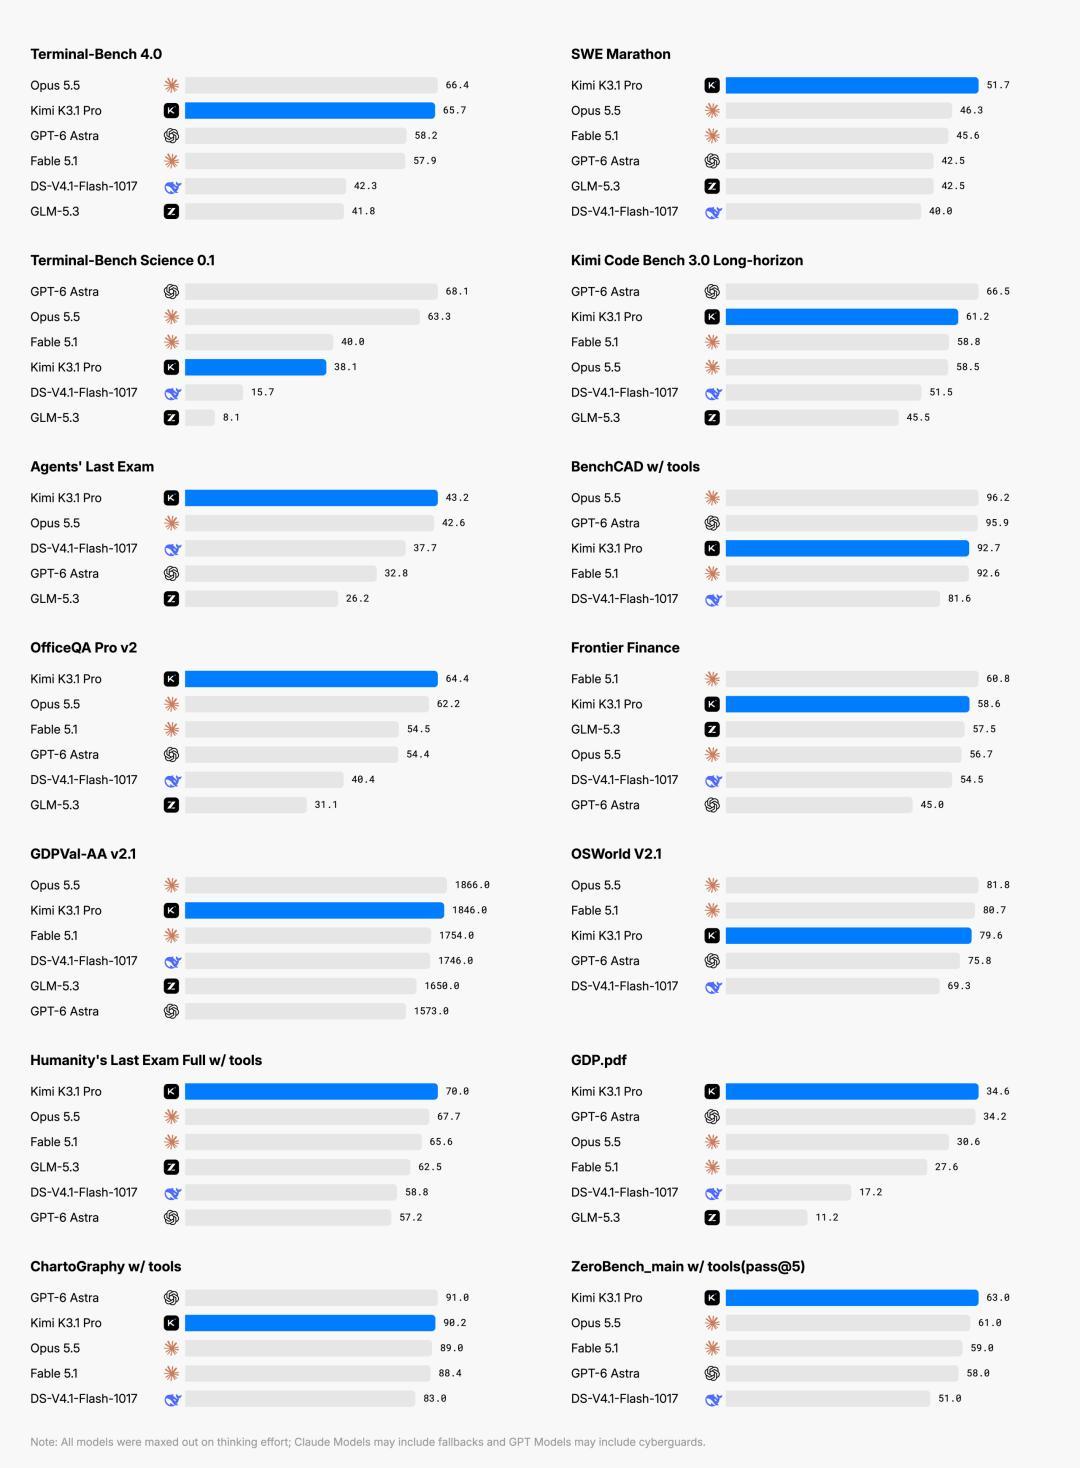
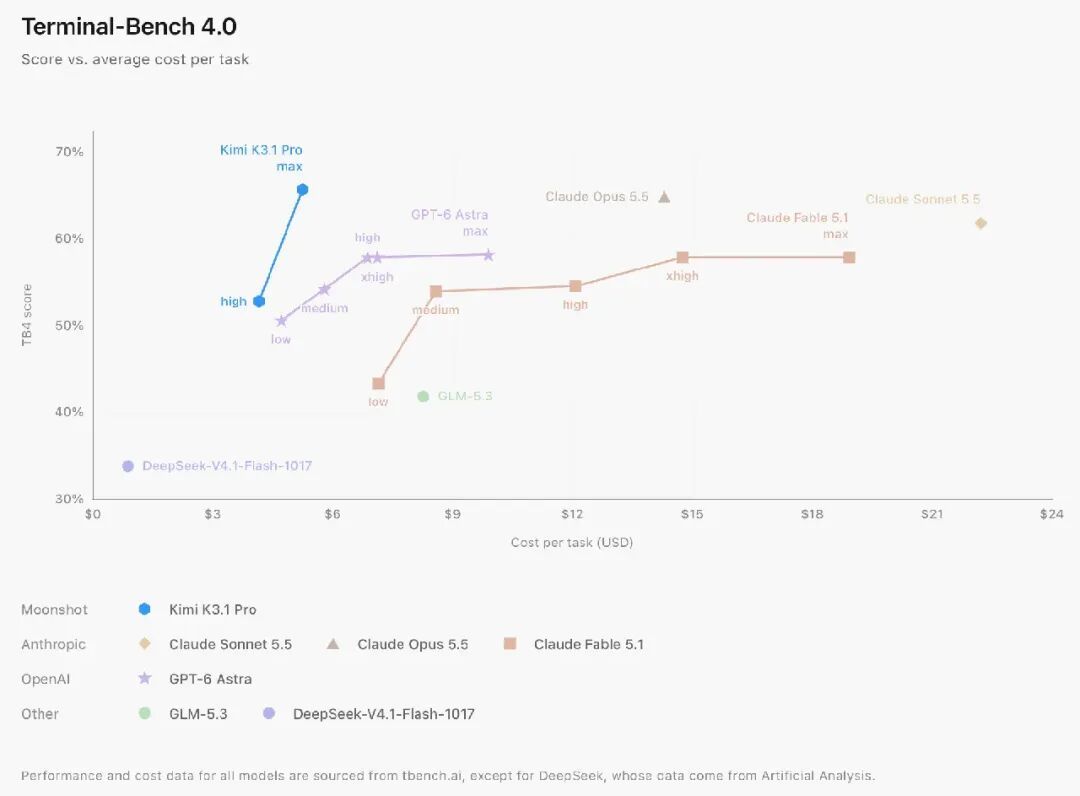
按照 Kimi 公布的成绩,Terminal-Bench 4.0 拿到 65.7%。
它比 GPT-6 Astra 的 58.2% 高,离 Claude Opus 5.5 的 66.4% 只差 0.7 分。36氪微博
Artificial Analysis 的智能指数给它 55 分,全球第四。价格只有 Astra 的五分之一。36氪
然后,付费用户发现,额度不够用。
一位 199 元档用户算过:两天生成不到 10 个 3D 模型、几个 30 秒以内的演示动画,月额度已经跑完一半。36氪
另一位只发了一句“审查项目架构”,Kimi 拉起 5 个子 Agent,十几分钟后,5 小时额度满了。36氪
还有人跑一个基础 3D 游戏 Demo,没有用子 Agent,10 分钟后任务还没返回,5 小时额度先没了。36氪
Kimi 的道歉很直接:限流、额度无故虚耗,责任都在自己。所有档位订阅用户返还月度总额的 25%,大约一周用量;同时砍掉不必要的子 Agent 调用,压缩输出长度。36氪微博
这不是一句“模型太贵”能解释的。
看 API 单价,K3.1 Pro 输入 13 元/百万 token(缓存命中 1.3 元),输出 68 元,比上一代便宜三分之一。
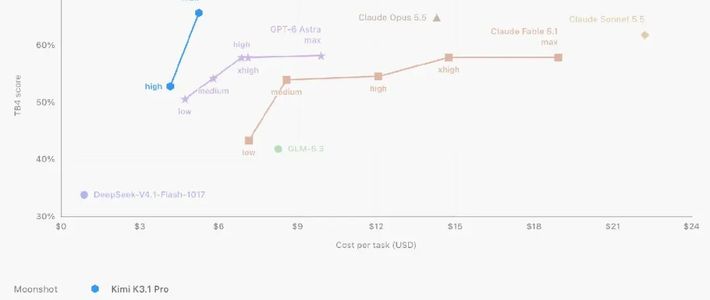
按 Artificial Analysis 的测算,跑完一套智能指数,平均每个任务花 2.11 美元。
GPT-6 Astra 是 3.26 美元,Claude Opus 5.5 是 5.98 美元。36氪
问题在用量。
GPT-6 Astra 约 6000 万 token,GPT-6.1 Sol 约 6700 万 token。按 OrcaRouter 的换算,同样的任务,它的输出量大约是 Astra 的 2.5 倍。
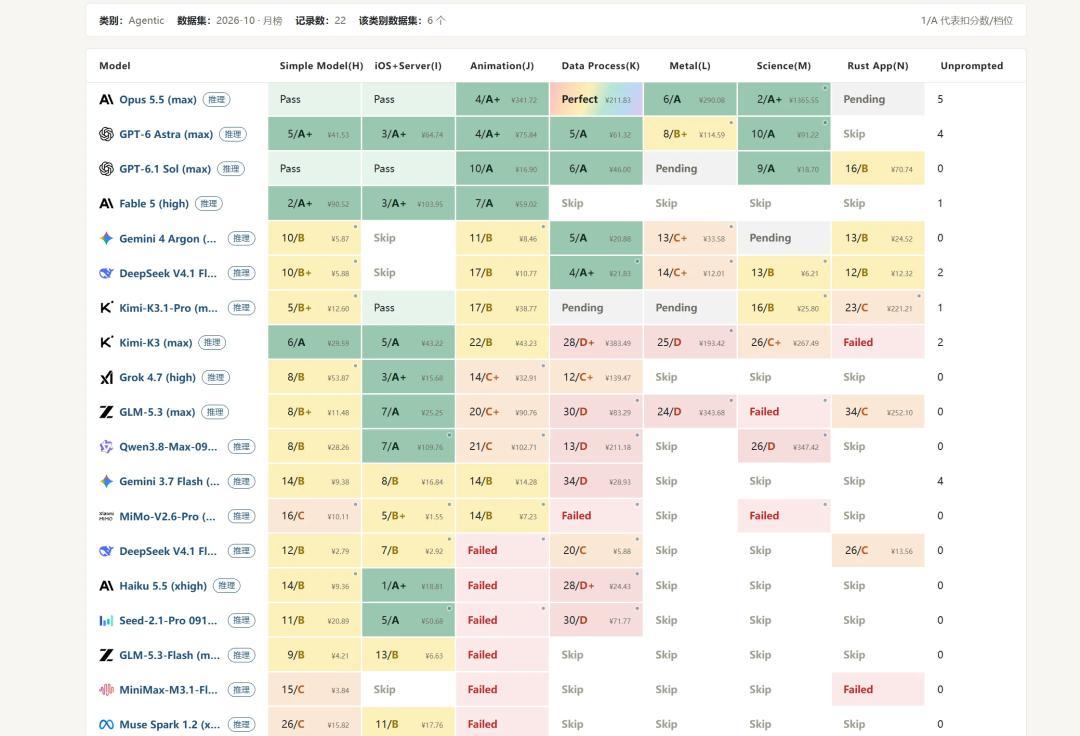
同一套测试,K3.1 Pro 累计输出约 1.5 亿 token,参与评测模型的中位数是 8700 万,高出 72%。输出速度 73.5 token/s,也低于 81.1 token/s 的中位数。36氪
它只支持思考模式。关掉思考的请求会被直接拒绝。每一次调用,都在为推理付费。36氪
更隐蔽的是子 Agent。用户看到的是“一句话任务”,系统里可能是五条分支同时开工。
每个子 Agent 都要重新装一遍身份、规则、工具清单和上下文,跑完再压缩成摘要交回去。
Anthropic 在 10 月的一篇文章里估算,多 Agent 系统的 token 消耗约为普通对话的 15 倍。大部分不是花在“想”,是花在“记”。36氪
Kimi 自己也承认,问题出在“不必要的子 Agent 调用”和“冗余输出长度”。
Kimi 把 K3.1 Pro 做成一个能长时间工作的 Agent:会搜索、会调工具、会自我检查。
K3.1 Pro 的技术报告里有个例子,它为了让仿真人走起来,回头检查模拟器,修掉了 36 处肩部肌肉力臂的计算错误。这种严谨是能力,也是账单。36氪
订阅制和 API 的计价方式,在这里分了岔。
API 按 token 明码标价,用户知道每一分钱花在哪。订阅制卖的是“一个月能用多少”,用户按“我做了几件事”估额度,系统却按“调了几次模型、开了几个分支、读了几遍文件”扣。中间那层,是黑箱。
这不是 Kimi 一家的病。OpenAI 用户也遇到过高推理档位任务没跑完就撞墙。模型越强,任务越长,越容易撞上这堵墙。
Claude 20 美元档的用户,有人一个复杂提示词就用完 5 小时额度;用 Opus 5.5 处理存量代码库,30 分钟左右触发限制。36氪
Anthropic 给的解法是,把子 Agent 折叠回主循环,按需加载成 Skill。它说,这样能砍掉 80% 以上的系统提示词。Kimi 的解法更直接:少开子 Agent,压缩输出,先赔一周额度。36氪
对写代码的人来说,这件事的提醒不是“别用 Kimi”。而是:跑分只回答“能不能做完”,不回答“做完要花多少”。这两个数,在订阅制里后者更贵。
下一个模型发布时,榜单还会刷屏。真正该看的,可能是你拿自己的项目跑一遍,记下完成一个任务用了多少 token、触发了多少次子 Agent、额度掉了多少。
0.7 分可以下次再追,2.5 倍的用量会先到账。