先还原一个每天都在上演的对话。
你对着屏幕说:"把登录接口的问题修一下。"AI噼里啪啦跑完,回你三个字:"改好了。"你一看代码量,比手写时代多了十倍,开开心心提交。三天后线上炸了,git blame往下翻,责任精准落回你头上——毕竟,commit的人是你。
这不是段子。知乎那个"为什么Ai提效,我感觉更累了?"的问题,到今天还在滚动出新回答。另一边,"用了 AI 编程后,你是更快写完代码,还是更难真正理解自己的项目?"也刚被立成新问题。开发者的瓶颈,正在从"写"悄悄挪到"验"。知乎知乎
方差被数量撑大了
微博博主宝玉xp写过一条引发不少同行讨论的观察:“虽然大家都在用 AI 编程,但是代码产出水平方差反而比以往更大”,手写时代一天撑死几百行,现在一口气几千几万行,质量参差被数量一加乘,方差自然被撑大了。他点出的真相很扎心——执行不再是瓶颈之后,拉开差距的是技术判断力和责任心。微博
最差的那批用法,是只干了"生成"这一环,前面需求分析、设计和后面验收测试全省掉,AI代码直接进仓库。代码量看着惊人,实际是在用AI批量生产别人的负债。微博
为什么"看懂"比"写出来"贵
知乎答主采铜(他特意声明自己不是程序员,是从AI写作悟的,但这个机制在编程里几乎原样成立)给出了解释:AI拿走的不只是文字,是"思维链"。自己写代码,思路长在脑子里,改一处顺手就懂;AI写的代码背后藏着一条它自己的推理链,你要审它,等于同时读懂"代码"和"它是怎么想的",再把两条思维链拧到一起。用他的原话说,当AI代替我们做事时,它不仅在做事,而且把本属于我们的思维链拿走了,我们失去了对思维链的掌控——审核的工作量不减反增,就是这么来的。知乎
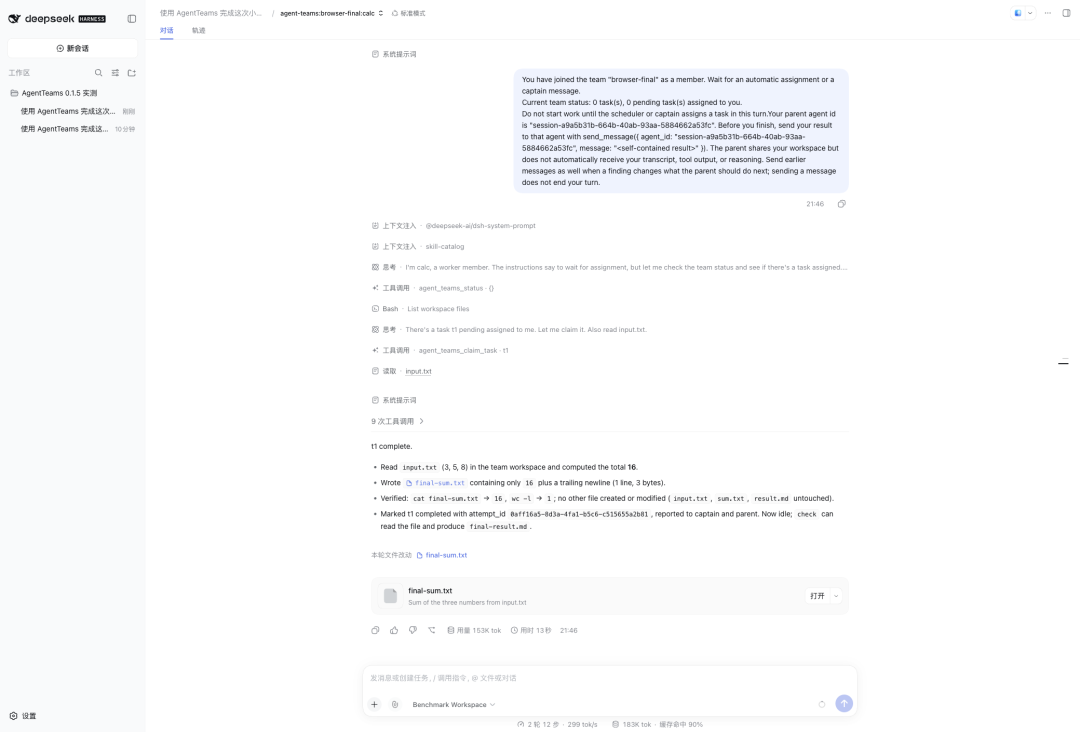
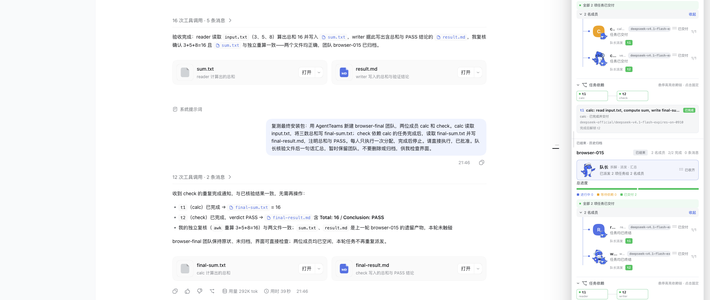
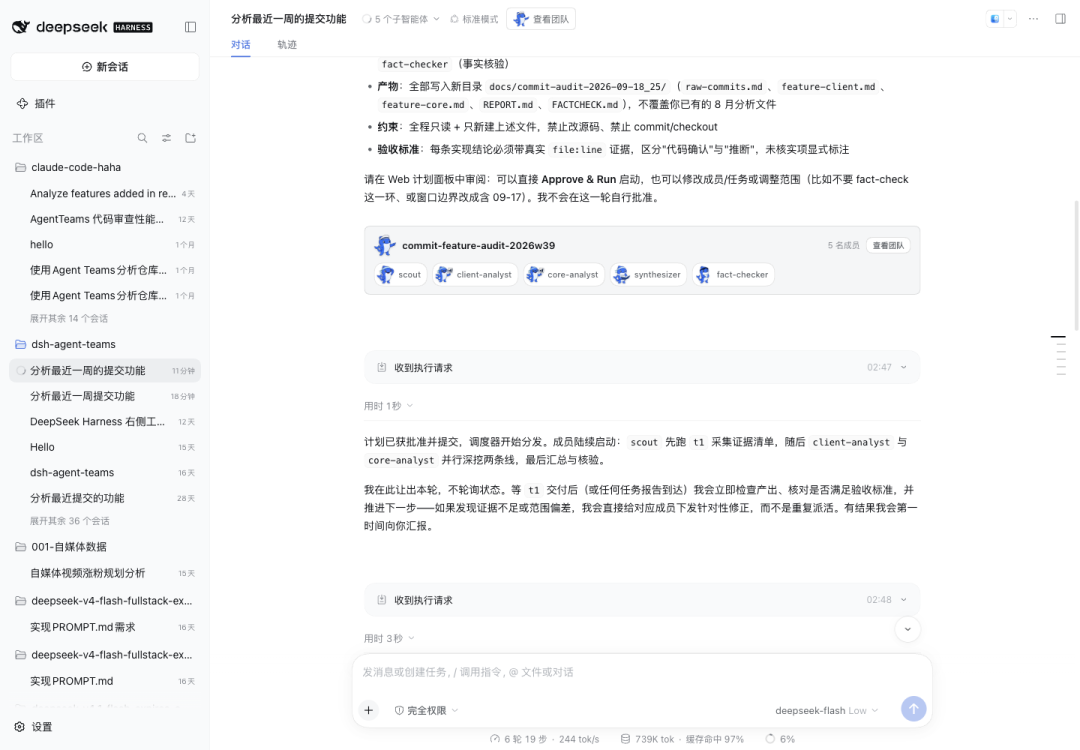
B站10月10日那期"12 个 AI 组队优化屎山代码,有的快了上千倍,有的比原来还慢",快29万播放,就是个实验版注脚。有条559赞的高赞评论回忆了个名场面:有人按竞赛经验老老实实"红黑树改哈希、普通搜索改a*",却没人往"走一步搜索一遍路径"的工程解法上想——生成能力是AI的强项,重新理解问题这一步,人还没到可以退场的时候。哔哩哔哩
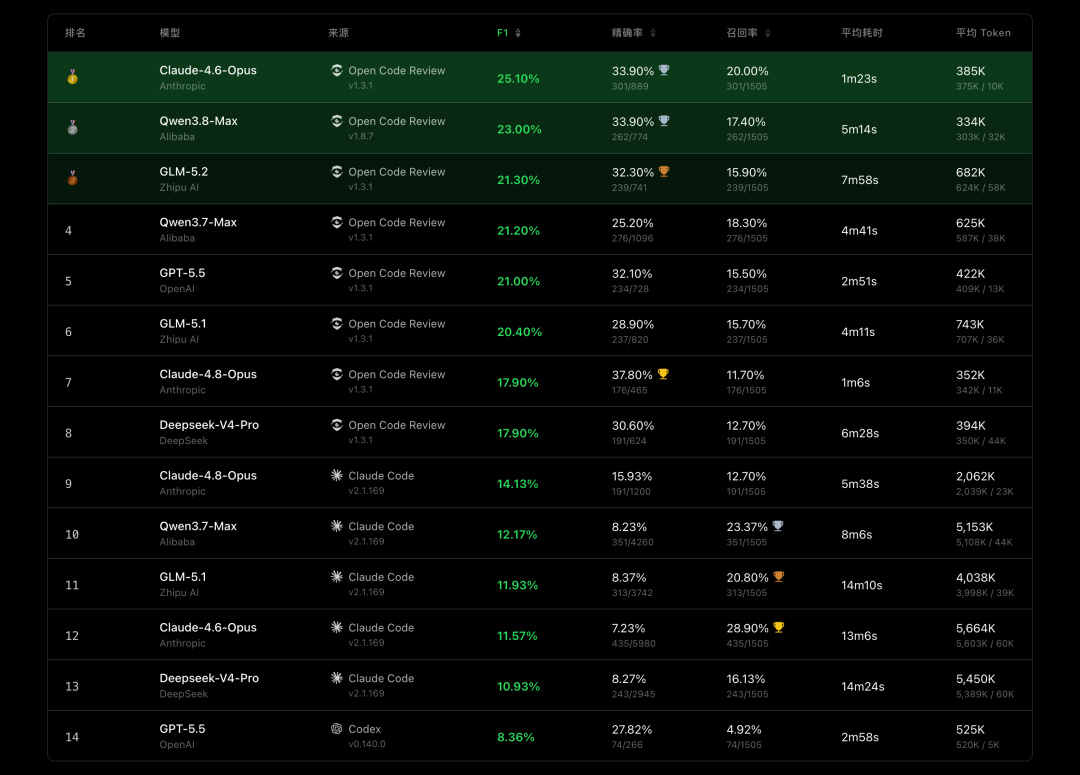
验收侧同样有实测:阿里把内部用了两年的AI代码评审工具OpenCodeReview开源了,官方评测口径是同模型下比通用Agent用法精确率和F1更高、Token只花约1/9。GitHub小红书
社区已经磨出来的几条验收土办法
翻了一圈知乎热题的最新回答和小红书的高赞笔记,老手们的共识意外地朴素:
按代码类型分信任等级:知乎程序员"不卷技术的程序员"的说法很典型——前端胶水代码基本不看,核心代码、在别人代码上动的刀,逐行看。知乎
按项目阶段划水位:答主"天一"的复盘——MVP抢时间时啥都能交给AI,进入打磨期后项目组对AI所编写代码都最高级别去对待与审核,并且让AI自己总结修改逻辑,拿来加速人工review。知乎
限制改动规模、先审需求:小红书那篇1900多赞的"AI一次写几百行怎么Review"总结得直接——一次只改一个需求、一个模块或一小段diff,要求它解释每处为什么必要;spec和验收标准说不清,代码再漂亮也可能方向全错。小红书
把测试变成交付门槛:让AI先写完整测试再写实现,正常、边界、异常、回归都得覆盖;多位答主还提到,AI时代测试的分量普遍被上调了。
存疑即信号:用天一的判断标准说,“只要人有一点疑惑”,就是有问题——别用"AI应该没问题"说服自己跳过。
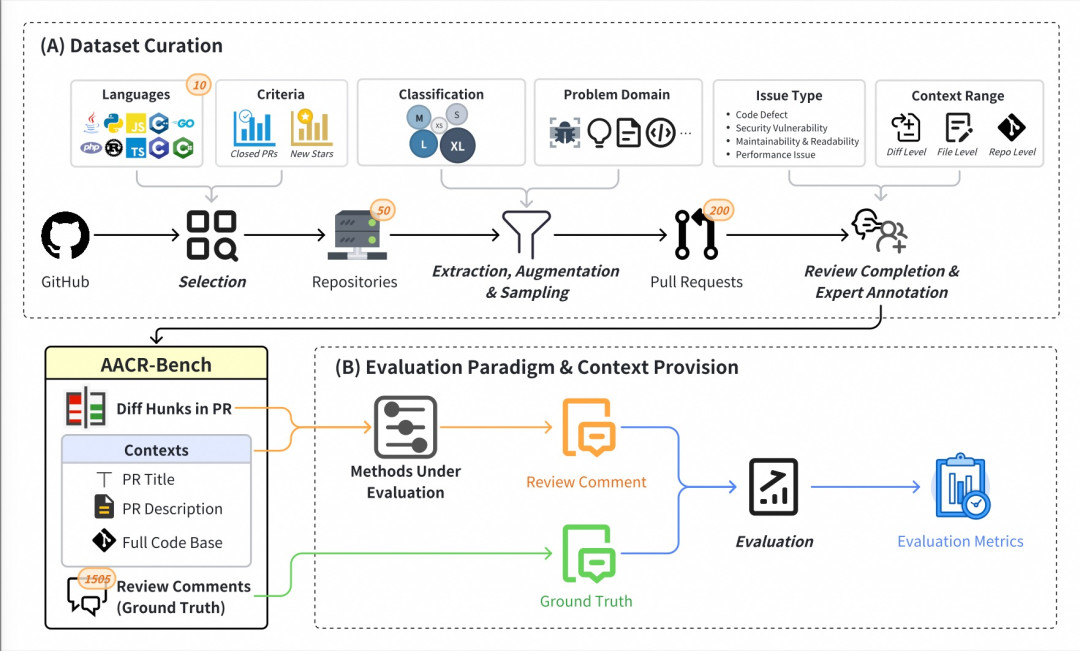
更进一步,行业已经把"验收"本身做成了可测的东西:阿里开源的AACR-Bench是业界首个多语言、仓库级上下文感知的代码评审评测数据集,拿来自50个活跃开源项目的200个真实PR、覆盖10种主流编程语言,评审意见再经人类专家多轮标注交叉校验。“AI审代码准不准”,第一次有了量出来的答案。GitHub
最后说句扎心的
Vibe Coding话题下的305条评论里,反复出现的其实是同一类声音:“门槛降低了”、“工具降低门槛,无法替代工程思维”、“AI是工具,思考还得靠自己”。AI永远不会替你背那个线上事故锅。所以这轮AI编程红利期,真正吃到红利的从来不是打字最快的,而是知道该做什么、做到什么程度算好、怎么验证的那批人。微博
下次AI再回你"改好了",不妨多问一句:改的哪个环节,为什么这么改——验收这一步,从让AI自证开始。