10月15日,阶跃星辰把新一代旗舰模型 Step 5 Preview 的完整权重放了出来,BF16、FP8 两个版本同步上线 Hugging Face 和 ModelScope,配套发布技术博客、开发工具和部署指南。 先说结论:在“每一块钱能换回多少智能”这个维度上,Step 5 Preview 是当下开源阵营里最具竞争力的选手之一;但它没在所有榜单上登顶,“香不香”要按任务拆开看。这款模型此前已在海外测评机构 Artificial Analysis 的综合智能指数中拿到 44 分,被普遍放进“全球开源前三”的讨论里。经济观察网知乎
这次开源了什么
权重的技术底色是面向 Agentic 任务的工程设计:注意力部分采用 3 层 512-token 滑窗加 1 层全注意力的混合结构,摩尔线程当天就在自家 GPU 上完成了稀疏注意力后端适配。 国产算力阵营几乎同步跟进,沐曦的曦云 C 系列也在发布当天完成 Day 0 深度适配。摩尔线程技术博客沐曦股份MetaX
对开发者更实际的是部署路径:模型支持通过 vLLM、SGLang 部署 API 服务,也可以用 Transformers 做离线推理。 开放权重之后,团队可以把它接进自有数据、工具和业务系统,这是 API 闭源模型给不了的选项。经济观察网
规格上,Step 5 Preview 采用稀疏 MoE 架构,总参数量 600B,每个 Token 只激活 27B,支持 1M Token 上下文窗口和视觉输入。 主干走“窄而深”路线:92 层 Transformer,配合 Sparse GQA 和 Block-wise Token Merging,官方称百万上下文的索引检索成本被压到了原来的八分之一。摩尔线程技术博客爱范儿
榜单对线:44分坐进同一桌,短板写在明面上
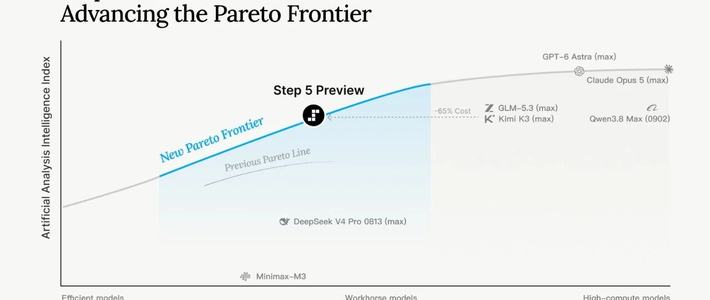
智能水位上,Kimi K3 是 44 分,Grok 4.6 是 44 分,GLM-5.3 也是 44 分,这几家被业内当作前沿守门员,Step 5 Preview 用更小的激活规模站到了同一位置。 对比它自己,上一代 Step 3.7 Flash 在这个榜单上只有 19 分,两年时间几乎翻了一倍还多。爱范儿冷逸
海外媒体把这组对比算得更直白:参数规模的差距是效率差距。 这也是它敢提“智能效率帕累托前沿”的底气:同样 44 分的智能,它要的算力和要花的钱都更少。爱范儿
主打方向的成绩确实硬:软件工程基准 DeepSWE v1.1 得分 67.7,压过 Kimi K3 和 GLM-5.3。 官方为此专门造了测试题——真实仓库、真实工程任务,而不是算法竞赛。爱范儿
金融是另一条强线:FrontierFinance 基准拿到 66.4 分,把 GPT-6 Astra 的 55 分甩开一截,GLM-5.3 和 Kimi K3 都排在它后面,前面只剩一个 Claude Opus 5。 对做研报、对账、数据面板这类活儿的用户,这是它区别于“纯编程模型”标签的增量。爱范儿
热度侧的佐证来自真实用量:模型先在海外开发者社区刷屏,登上 OpenRouter Trending 榜首。 按阶跃星辰披露,截至开源当天,它位列该平台 Token 用量周榜和日榜第二。WorkBuddy经济观察网
但弱项同样是官方自己贴出来的成绩单:真实的 553 仓库、33 种语言工程基准 StepCodeBench 上,Step 5 Preview 只拿 49 分,Claude Opus 5 是 63.9,GPT-6 Astra 是 61.0。 敢把难看的成绩放出来值得点赞,但也说明离闭源旗舰的天花板还有一截。爱范儿
更吃“长时间连续干活”能力的 Terminal-Bench v4 上差距更直观:它只有 33.3 分,GLM-5.3 拿了 41.9,GPT-6 Astra 冲到 57.9。 长链条工具调用和终端自动化,是它相对整个第一梯队最明确的差距项。爱范儿
实测:最突出的体感是一个“稳”字
AI 博主 karminski-牙医用多轮自建测试给出的第一结论是输出稳:后训练扎实,写工程代码很少出现反复推倒重来的情况。 在他设计的“硅基交警” Agent 测试里,它全程没有指挥出一次事故。karminski-牙医
另一项实测里被反复验证的特性是 Agent 循环:它会卡着任务的极限约束迭代优化,甚至会“钻规则空子”把积分刷满。 对长任务自动化来说,这种“自己盯自己”的属性比单点聪明更值钱。karminski-牙医
知乎答主欧巴聊AI的测试偏交付质量:让它在浏览器里复刻 Windows 系统,它通过无头浏览器自验、自修,一口气修掉了 7 个 Bug。知乎
开发者小林的测法最接近真实工作:一张原型图加一份简短 PRD,让它从 0 到 1 做出一个可用的 AI Agent 工作台。读图整理需求、写前后端、起服务、跑测试、修 Bug,全程自主,图读不全它会自己切图,页面写完还会拿渲染结果和原型图对差异。 这轮长任务合计约 4549 万 token,账单细节放到下一节。小林
独立的工程横评则给出了坐标系:有测评者出四道 WebGL 题、四题等权各 100 分,Step 5 Preview 的疏散模拟产出与 DeepSeek V4.1 Flash 并列单项第一,另外两道题拿下单项第一、第二,但在个别题上输给对手,综合没有通吃。 对开源阵营,它已是“掰手腕”的级别;对最强对手,还没到一边倒。知乎
实测共识里的短板也很集中:前端、3D 场景和美学输出,比上一代有提升,但和这一代 SOTA 仍有距离。 想用它直出炫酷 3D 演示的,目前还别抱太高期望。karminski-牙医
成本账:便宜从哪来,坑在哪
API 定价是叙事的核心:每百万输入 token 7 元,命中缓存只收 0.35 元,输出 20 元,命中与未命中相差整整 20 倍。 美元口径下,同级推理模型的输出价中位数是每百万 token 10 美元,它是 2.7 美元。小林爱范儿
换算成“办成一件事”的成本更直观:把 AA 整套智能指数测试跑下来,它平均每个任务花 0.71 美元,同一份榜单上 Grok 4.6 是 1.86 美元、Kimi K3 要 2 美元、Claude Opus 5 接近 6 美元。 官方宣传语称这是 Claude Opus 5 的八分之一,腾讯科技的报道提醒,这个比例要限定在特定任务和配置里才成立。爱范儿
便宜之外有个必须计入的变量:它偏“话痨”。 单价省下来的钱,会被多出一倍的输出吃掉一部分;好在每秒 100 token 左右的解码速度,比推理模型平均快一半,把等待成本又拉了回来。爱范儿
缓存才是真实成本的胜负手。小林那轮工作台开发合计 29.47 元:命中缓存的输入约 15.37 元、未命中输入约 9.22 元、输出约 4.87 元。 同样的任务,调用方式是否让上下文稳定复用,账单可能差出数倍——这也是“比谁更便宜”时各家口径最容易打架的地方。小林
开源之后,谁的菜,谁再等等
先用起来的路已经铺平:API 兼容 OpenAI 和 Anthropic 协议,Codex、Claude Code 都能按对应方式直接接入。 不想管 Key 的,WorkBuddy 平台的独家限免窗口截至 10 月 25 日。小林WorkBuddy
而真正决定“开源香不香”的那两个问题,现在还没有答案:600B 总参数的权重放出来,普通团队手里的卡到底跑不跑得动;权重版本能不能复现 API 那份成绩单,也得等开发者们真机验过才算数。爱范儿
公司层面的注脚也值得一提。作为“AI 六小虎”里最安静的一家,阶跃今年 1 月完成了超 50 亿人民币的 B+ 轮融资,上海国资领投、腾讯加注、国寿入局。 从追分到追“智能/成本比”,这家公司三代模型押的是同一道题。爱范儿
回到“谁更香”:按量付费做 Agentic 编程、金融分析、长文档处理的用户,它现在是同预算下几乎绕不开的选项;想自建的团队,建议先按官方部署指南拿真实显存跑一轮 PoC,再谈性价比;而重度依赖超长终端工具链、或者以 3D 视觉呈现为核心的场景,GLM 与闭源旗舰们的证据仍然更硬。开源大模型的这张桌子上,阶跃放回的不只是碗筷,还是一道逼所有人重新算账的题。