
这周苹果阵营的本地推理帖,热闹得不正常。
一边是翻车实录:Mac mini M6 24G 的博主原以为"扣掉系统还能剩 16G,跑千问 27B 级够用",结果剩约 10G 内存时模型直接起不来。这条避坑帖一天内攒了 14 条评论、1500 多次播放。另一边是晒单实测:128G Mac Studio 跑 103.94GB 的 Qwen3.8-Flash-Next 权重、最高 102.9 tok/s,评论区 73 条几乎全是"真的假的、我这台能不能照做"。再旁边还有 150 赞、131 收藏的"Mac Studio 对双 Spark"对比帖,把 M5 Ultra 256G 和两台 DGX Spark 按在地上比。三条帖下面,是同一个撕裂:有人说 Mac 是本地推理的"终极形态",有人说统一内存就是营销话术。哔哩哔哩小红书小红书
撕到这个程度,其实是因为大多数人只算了第一笔账——“我买了多少 G”。而这周刷屏的几篇实测,真正值钱的数字全在这三笔账里。

第一笔账:容量账,标称值和你能用的中间隔着四层减法
统一内存 ≠ 可用内存,这周被两篇实测给出了具体扣减数。Mac Studio M5 Ultra 256G 那期实测(10-04 发布,50 赞 85 评论)给了两个硬数字:标称 256G,Metal 实际能给到 GPU 的硬顶约 222.7G。更隐蔽的一刀是权重载入——105.4G 的权重文件,不是按 105.4G 占,加上预测头、嵌入层和缓冲对齐,得按 142.3G 留。也就是说,一个标称百 G 的模型在这台机器上真实吃掉接近一半预算,留给 KV 缓存和上下文的只有几十 G。哔哩哔哩
然后是系统侧的门槛。Mac mini M6 24G 的翻车证明"24G 减掉 macOS 占用还剩多少"这种直觉算法根本不成立:模型的启动门槛比预想高得多。另一篇"用 M4 MacBook 24G 跑了一个月"的吐槽帖(41 条评论)把多任务的账摊得更开:一个 Qwen 3bit 版吃 13G、ComfyUI 出图占 15G、系统 6G,合计 34G——24G 的机器装得下一个,装不下两个,这位作者的结论是咬牙下单 128G。小红书
把这几篇的数字并排放,得到一个粗糙但可用的预算公式:GPU 可用上限 ≈ 标称 × 0.87;权重实际占位 ≈ 文件体积 × 1.35;再扣掉系统常驻和你的上下文 KV,剩下的才是真实余量。按这个口径回头验:128G Studio 跑 103.94G 权重(×1.35≈140G)居然跑通了,要么帖主的量化口径让膨胀系数明显低于 1.35,要么就是贴着上限在跑——博主自己也留了话:"后面准备继续测试长上下文、多轮 Agent、代码和更复杂的工具调用。"所以"128G 跑通 100G 级"能信,但别把它当成 128G 的舒适区,它更像极限票。

一个提醒:上面这些数出自单机、单次、单样本实测,原作者明确标注"视为量级判断,不作精确复现承诺",部分硬顶还是推算值,别当精确复现。
第二笔账:速度账,解码看带宽,而"哪个引擎最快"是个伪问题
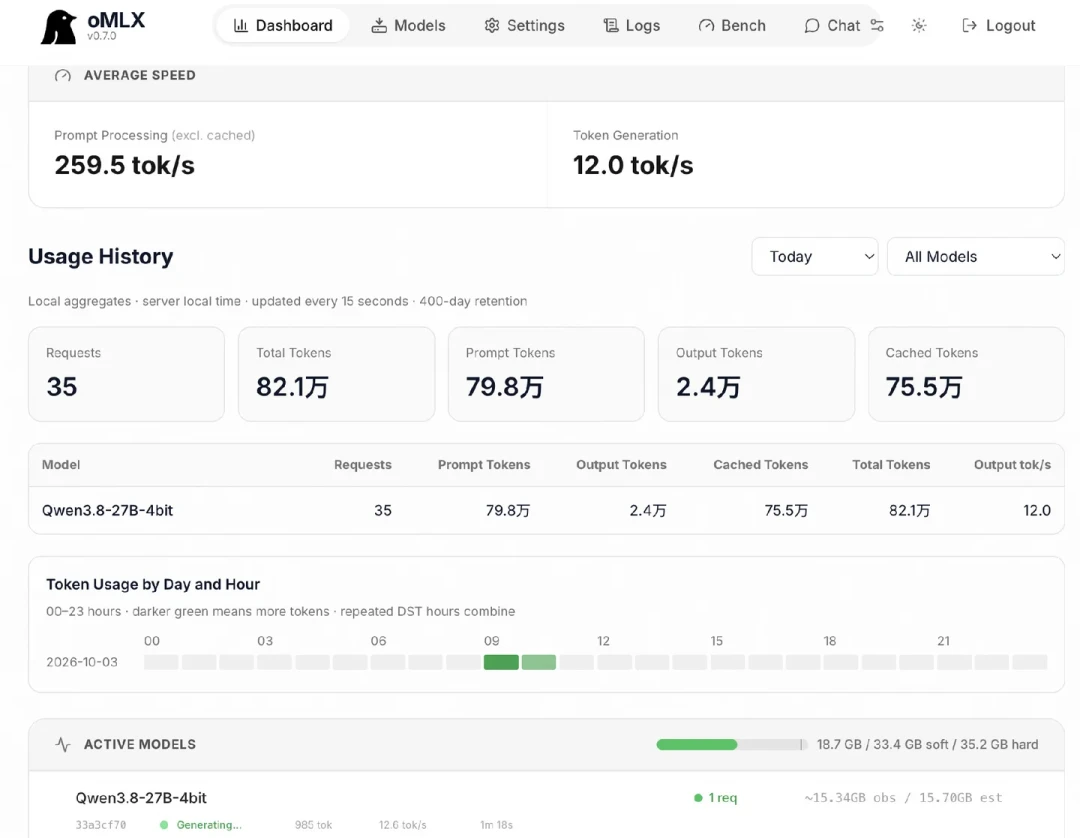
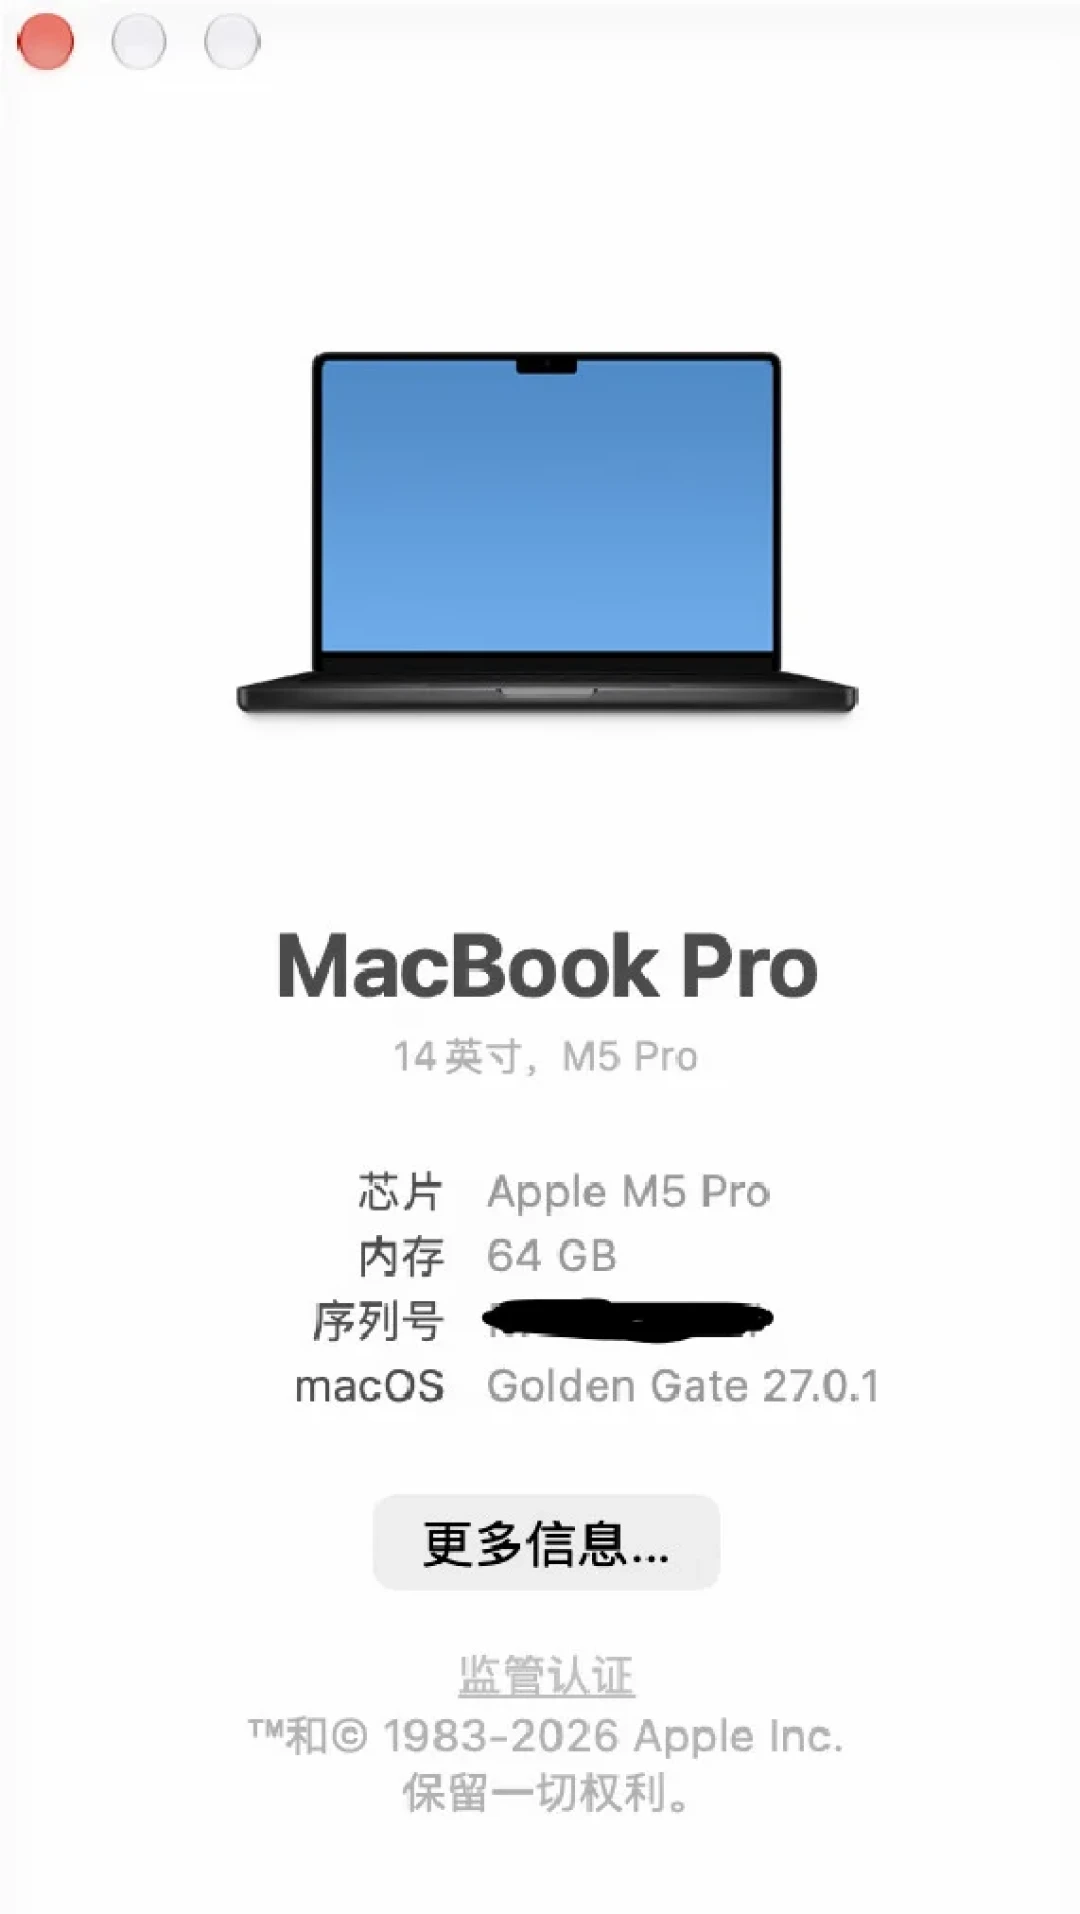
满血 M5 Pro 64G MacBook 那期实测(52 赞 50 评论)把带宽天花板说得很白:27B-4bit 权重约 14G,每生成一个 token 都要完整过一遍内存,理论上限约 20 tok/s,实测 12–15 tok/s,已经吃到理论的 60%–75%——不是配置问题,是物理上限附近。这跟知乎那个 26 万阅读的硬件配置回答口径一致:真正要回答的只有两个问题,能不能跑起来、跑起来有多快,而它们由两个不同的硬件指标决定,混在一起谈就会买错。小红书知乎
但同一个模型同一台机器,读数能骗人:换框架、换上下文长度、命中不命中前缀缓存,读数能差出 6.8 倍(40→272 token/s)。所以"oMLX 和 MTPLX 谁快"这类争论基本无效,先问你的活儿是什么形态:短对话、长文摘要,还是 Agent 多轮。哔哩哔哩
而"38 对 38"这组数值得单拎出来:256G Mac Studio 和双 Spark 跑同一个 DeepSeek V4 Flash,生成速度打平。这基本坐实了消费级苹果芯片跑大 MoE 的体感——逐字生成这一段,Mac 不欠你的。
第三笔账:场景账,读文档看算力,多人用看并发,这才是 Mac 露怯的地方
生成打平,不等于两台机器打平。同一篇对比帖里的另一组数才是真正的分水岭:读一份 3.2 万 token 的代码库,Mac 50 秒、双 Spark 17 秒,8 人并发首字等待则是一分多钟对约 24 秒。原帖三点结论写得很干净:写得快看内存带宽,读得快看 GPU 算力,一个人用选 Mac,长上下文和小团队选双 Spark。小红书
"读得快"这件事在视频输入上会被放大到夸张:满血 M5 Pro 那期,识别本地视频累计喂了 776 万输入 tokens,只换回 14 万输出(55:1),GPU 95% 负载、风扇狂转的根源是预填充而不是生成。作者给的优化路径也很具体:换 8B 级 VLM 或激活 3–4B 的 MoE,解码提速 3–5 倍;抽帧降到 0.5–1fps、分辨率 448px,视觉 token 直接降一个数量级。翻译成人话:Mac 适合你一个字一个字地读给它听,不适合你把整个硬盘扔给它。小红书
按切片对号入座,别为"最大能跑多少B"付费
手里是 24G 的 Mac mini / MacBook:27B 级别别碰,13G 权重 + 系统 6G + 任何第二个常驻服务就穿帮;现实用法是 FMCLI 这类内置端侧 3B 模型做摘要和实体提取,或 7B 以下小模型。哔哩哔哩
64G 档(M5 Pro/Max):27B-4bit/6bit 的主力位,预期 12–20 tok/s,会烫、会狂转风扇、别和剪辑浏览器三开;64G 跑 27B"三个坑"那期视频 6000 多播放、52 条追问,问的全是散热和常驻内存。哔哩哔哩
128G 档:百 G 级 MoE 的极限票,能进这个门,但长上下文和并发请按第一笔账重新扣,别拿跑通当日用。
256G 及以上:100B MoE + 中等长上下文的舒适区;但如果你的场景是"多人 + 长文档 + Agent 流水线",10 月 23 日六家 OEM 开卖的 Spark 集群(ConnectX-7 直连、双机汇聚 128GB)在同预算下的读长文和并发是另一套物理,这不是 Mac 的主场。哔哩哔哩
最后三个继续观察的信号:128G 跑 103.94G 的博主承诺补测长上下文与多轮 Agent,这条"能跑通"目前只覆盖普通对话和基础智能体调用。M5 Ultra 实测这边,作者把口径红线写在明处:单机、单次、单样本,还有一整页"还没补"清单(MTPLX 256K、四引擎同口径横评、512G 实机)。以及整个 DIY 阵营那边,DDR5 现货还在涨——统一内存"一次性买断不再折腾"的优势,正在被内存行情反复称重。证据就到这周这几篇实测为止,你的机器、你的量化口径、你的活儿,都得自己再算一遍这三笔账。小红书哔哩哔哩












校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案