

2026-11-03 16:38:17
10:01
小学生是怎么折腾本地大模型的?
 扑通同学

AI为你总结
全文概述
以小学生视角分享本地大模型入门体验,解释基础概念、实操过程中的问题以及研究本地大模型的价值,适合AI新手快速了解本地大模型的基础逻辑和入门玩法,同时传递了以好奇心为驱动、问题导向的学习理念。
本地大模型基础认知
常规云端AI(如ChatGPT、千问、豆包)需要将问题上传到服务器推理后返回结果,本地大模型的权重文件直接存储在用户自己的电脑上,断网也可正常运行。入门阶段可先理解核心术语的通俗含义:参数量代表模型大小,量化代表模型的压缩程度,上下文窗口代表模型一次性可记忆的信息容量,首Token延迟代表开始回答问题的等待时间,生成速度代表回答时的输出效率,弄懂这些基础概念即可开始尝试在电脑上运行本地模型。
本地大模型实操体验
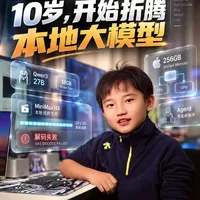
初期通过Ollama运行千问大模型,先尝试了80亿参数版本,后续更换为270亿参数的千问3.8版本,模型文件约18GB,在256GB统一内存的Mac上运行无压力。不满足于聊天功能后,尝试折腾Z-Image Turbo、Draw Things、ComfyUI、Minimax H3等工具实现本地生成图片、视频,其中Minimax H3多次在20步采样完成后卡在VAE解码环节,报错MPS后端不支持相关算法,最终生成失败。实操中发现并非内存足够装下模型就能正常运行,很多开源项目主要针对CUDA优化,适配Apple Silicon的MPS后端时容易出现适配问题,单个环节出错就可能导致整个运行失败。
苹果设备运行本地大模型的特点
针对Apple Silicon推出的MLX机器学习框架,相比直接在Ollama下载运行模型有不同的特性。苹果统一内存架构的优势是可以完整存放单张显卡显存无法容纳的大模型,无需在显存和系统内存之间频繁搬运数据;但256GB统一内存并不等同于256GB独立显存,大模型加载本身就需要较长时间,运行速度还受内存带宽、KV缓存分配等因素影响,运行过程中需要重点关注内存压力参数。目前苹果也在基于MLX布局工具调用、本地服务、智能体循环等本地Agent相关能力,不再局限于让模型单纯回答问题。
研究本地大模型的价值
当前云端AI已经能满足日常使用需求,小学生运行本地大模型没有刚性需求,驱动研究的核心是好奇心,希望搞懂不同模型的特性差异、量化原理、不同框架的区别等问题。本地大模型的核心潜力在于支持智能体(Agent)运行,相比普通一问一答的聊天机器人,智能体可以自主判断下一步动作、调用工具、读取文件、运行代码,并根据结果迭代执行后续步骤,形成完整的本地工作流,代表了AI从“会回答问题”向“能连续完成任务”的发展方向。现阶段优先梳理清楚参数量、量化、推理、上下文、智能体、工具调用等基础概念,即使相关技术后续更新迭代,也能为未来的学习打下基础。
0评论


当前文章无评论,是时候发表评论了
提示信息
取消
确认
评论举报






已收藏
去我的收藏夹