
2025-11-17 14:52:08
现在搞大模型训练,数据搬得慢真成硬伤。见过太多GPU干等存储的场景,InfiniBand这套低延迟、高并发的路子,确实是冲着解决实际问题来的,尤其万卡规模下,稳得住才跑得快
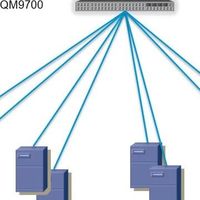
InfiniBand:高性能存储网络的关键基石
 超擎数智ChaoQing

AI为你总结
全文概述
InfiniBand网络凭借其高带宽、低延迟和RDMA技术,成为AI和高性能计算领域存储系统的最佳选择。它解决了多客户并发访问的性能瓶颈问题,提升了数据处理效率,特别适合大规模AI训练场景。
高性能存储需求
在AI和高性能计算中,存储系统的带宽和并行处理能力是关键瓶颈。新一代GPU需要更高速、更高并行的存储架构来充分发挥其算力优势,满足多客户、高并发的数据处理需求。
InfiniBand的核心特性
InfiniBand网络具备极致带宽与高并发处理能力,单节点带宽可达400Gb/s,并支持数千个客户端的I/O请求。其超低延迟和RDMA零拷贝技术显著提升数据访问速度和系统效率。
实际部署案例
采用MCX653106A-HDAT/MCX755106AS-HEAT网卡、MQM9790-NS2F交换机等设备构建的InfiniBand网络,具有极低延迟和超高带宽,适用于大规模AI集群,确保了网络的稳定性和高效性。
合作伙伴及服务
作为NVIDIA的双Elite精英级合作伙伴,超擎数智提供完整的基于InfiniBand网络的并行存储解决方案,利用其丰富的项目实施经验,帮助智算中心解决AI算力的存储瓶颈问题。
0评论


当前文章无评论,是时候发表评论了
提示信息
取消
确认
评论举报







已收藏
去我的收藏夹