

2025-10-31 17:24:24
把推理、代理和对齐训练合并到一个RL阶段,确实是个大胆的尝试。多阶段训练容易遗忘旧知识,就像学新技能忘了老本事,现在这样一体化处理,反而更贴近真实能力的融合过程
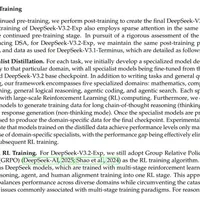
DeepSeek-V3.2-Exp RL细节
 AIGC探索之旅

AI为你总结
全文概述
DeepSeek-V3.2-Exp通过引入DeepSeek Sparse Attention (DSA)提升了长文本处理效率,采用单一RL阶段进行推理、代理和人类对齐训练。该模型在多个专业领域(如数学、编程等)表现出色,并通过混合RL训练有效避免了灾难性遗忘。
DeepSeek Sparse Attention (DSA)介绍
DeepSeek Sparse Attention (DSA) 是一种细粒度的稀疏注意力机制,通过闪电索引器计算查询令牌与前一个令牌之间的索引分数,选择关键值条目进行稀疏注意力计算。这种机制显著提高了训练和推理中的计算效率,尤其适用于长上下文场景。
单一RL阶段的优势
DeepSeek-V3.2-Exp将推理、代理和人类对齐训练合并为一个RL阶段,避免了多阶段训练带来的灾难性遗忘问题。这种方法不仅平衡了不同领域的性能,还通过基于规则的奖励、长度惩罚和语言一致性奖励来优化模型。
专业领域训练
针对数学、竞赛编程、逻辑推理、代理编程和搜索五个专业领域,DeepSeek-V3.2-Exp使用大规模强化学习训练专门模型。这些模型生成的数据用于最终检查点的训练,实验结果表明,经过后续RL训练后,模型性能接近领域专家水平。
混合RL训练方法
DeepSeek-V3.2-Exp采用Group Relative Policy Optimization (GRPO) 作为RL训练算法,不同于之前的多阶段训练方法。这种方法通过合并多种训练任务,有效地提升了模型在多样化任务中的表现,同时保持了较高的计算效率。
0评论


当前文章无评论,是时候发表评论了
提示信息
取消
确认
评论举报





已收藏
去我的收藏夹