












27
35
起猛了,DeepSeek 也有被斩杀的一天?
2026-08-28 22:08:50
7点赞
18收藏
11评论
作者|董道力**|ddl941110
8 月 26 日晚,阿里和智谱几乎同时发布了两个名字里带着“Flash”的模型。
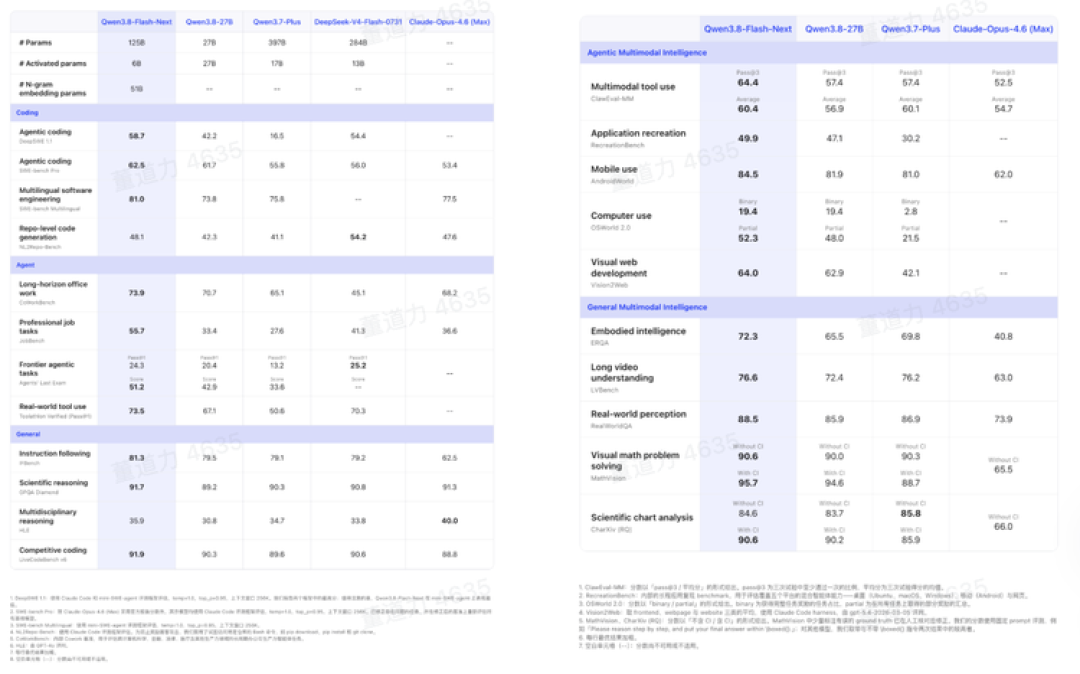
Qwen3.8-Flash-Next 拥有 125B 主模型和额外的 51B N-gram Embedding,每个 Token 只激活 6B 参数。GLM-5.3-Flash 总参数 320B,激活参数 18B。前者开放权重,后者采用 MIT 许可证开源。
过去的大模型发布会,喜欢往参数规模和 Benchmark 榜首上冲。这一次,两家公司却不约而同地把“少算一点”摆到了台前。
Qwen 开放了新架构和权重,迅速接入 vLLM、SGLang 等推理框架,生产版将以 Qwen3.8-Flash 进入 QwenCloud,千问办公已经用它支撑 Standard 模式。Qwen 官方公布的 API 价格为每百万 Token 输入 0.16 美元、输出 0.47 美元。
GLM 的打法就比较传统,先推出个匿名模型 Ox Alpha,在 OpenCode 和 OpenRouter 免费开放。开发者不知道它来自哪家公司,照样拿它写代码、调用工具、跑长任务。调用量起来之后,智谱才揭晓身份,开放 MIT 权重,并宣布测试期的全部请求由国产芯片集群承载。
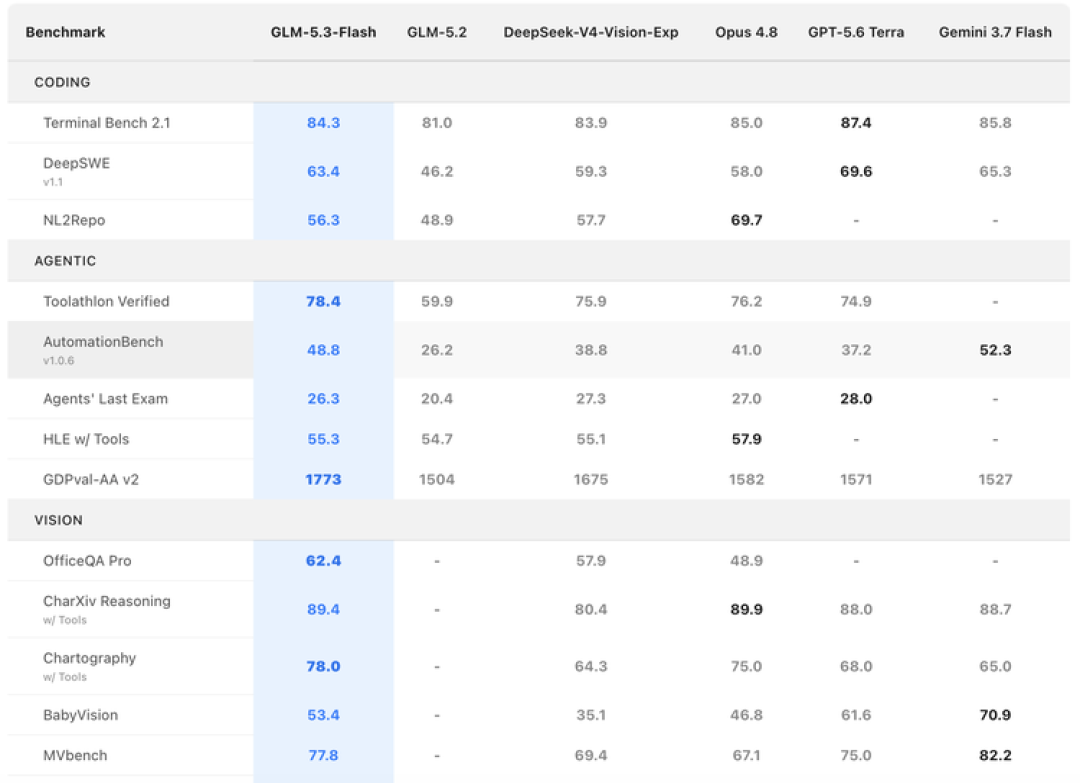
但无论他们的打法有多不同,目的都是进入 Agent ,成为那个默认、常驻、一天到晚跑个不停的模型。
1
DeepSeek 涨价十天后,替代者同时到场
这个时间点很微妙。
8 月 1 日,DeepSeek-V4-Flash 上线。短短两周,它在 OpenCode 上的日 Token 量便从约 3 万亿冲到 18 万亿。低价第一次把 Agent 需求彻底释放出来:过去舍不得交给模型反复尝试的任务,现在可以放心跑上几十轮。
但 8 月 16 日涨价后,日 Token 量迅速跌到峰值的一半以下。OpenCode CEO 估算,平台上由此空出了接近 10 万亿 Token 的日需求。
四天后,Ox Alpha 匿名(GLM)上线。
没有品牌背书,也没有发布会造势。开发者甚至不知道它来自哪家公司,只知道它免费、能力够用,可以接替 DeepSeek 继续干活。据公开数据,Ox Alpha 六天内在 OpenCode 累计处理 44 万亿 Token;在 OpenRouter 过去七天的调用量达到 23.2 万亿 Token,位列第一。
这几乎是一场天然的品牌盲测。摘掉公司名字之后,开发者仍然用调用量投了票:在 Agent 市场,模型是谁并没有账单、速度和完成率重要。
8 月 26 日晚,智谱揭晓 Ox Alpha 的身份,阿里也在同一天发布 Qwen3.8-Flash-Next。
DeepSeek 刚刚用一次涨价榨出了市场对低价模型的渴求,Qwen 和 GLM 便顺着这道裂缝挤了进来。
1
Agent 最重要的生态位,是日常主力模型
大模型竞争最容易被看见的,是谁又拿了 Benchmark 第一。但进入 Agent 之后,真正值钱的位置变了。
最强模型负责解决少数难题,日常模型负责处理绝大多数工作:读取代码、搜索文件、调用工具、检查结果,失败了再重来一轮。一个看似简单的任务,背后可能循环几十次。上下文不断变长,思考 Token 和工具调用逐层累积,几毛钱的价差很快就会被放大。
这正是 DeepSeek-V4-Flash 此前受欢迎的原因。它未必每项能力都最强,却便宜到让开发者不必盯着账单,可以把任务交给它一直跑。
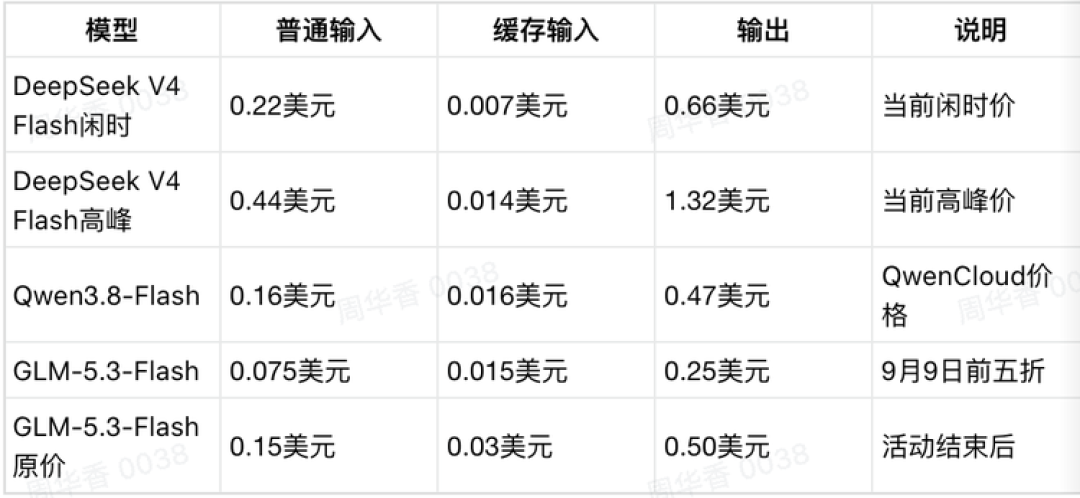
在聊天产品里,用户可能习惯某个模型的语气、界面和记忆。但在 Agent 世界,大模型几乎没有品牌忠诚度。换模型通常不需要迁移社交关系或重新学习一套产品,有时只是改掉配置文件里的模型名。
模型价格一旦变动,流量马上会寻找下一个出口。开发者关心的是任务能否完成、工具调用是否可靠,以及跑一晚上究竟要花多少钱。模型来自哪家公司并不重要。
也因此,日常主力模型的位置比旗舰模型更难守,也更有价值。一旦成为默认选项,拿到的就不只是 API 调用量。IDE、Agent 框架和办公工具会围绕它做适配,企业部署、订阅计划和云服务也会随之跟进。
最强模型决定 Agent 能做到什么,日常模型决定 Agent 每天在做什么。
榜单第一赢得发布会,默认模型拿走工作流。
1
这是一轮有技术的价格战
Qwen 和 GLM 毫无疑问带来了新一轮价格战。区别在于,过去的低价往往来自云平台补贴,这一次,两家公司先从模型结构里压低了成本。
总参数决定模型能够容纳多少知识和能力,激活参数则更接近每生成一个 Token 时,真正需要参与计算的部分。
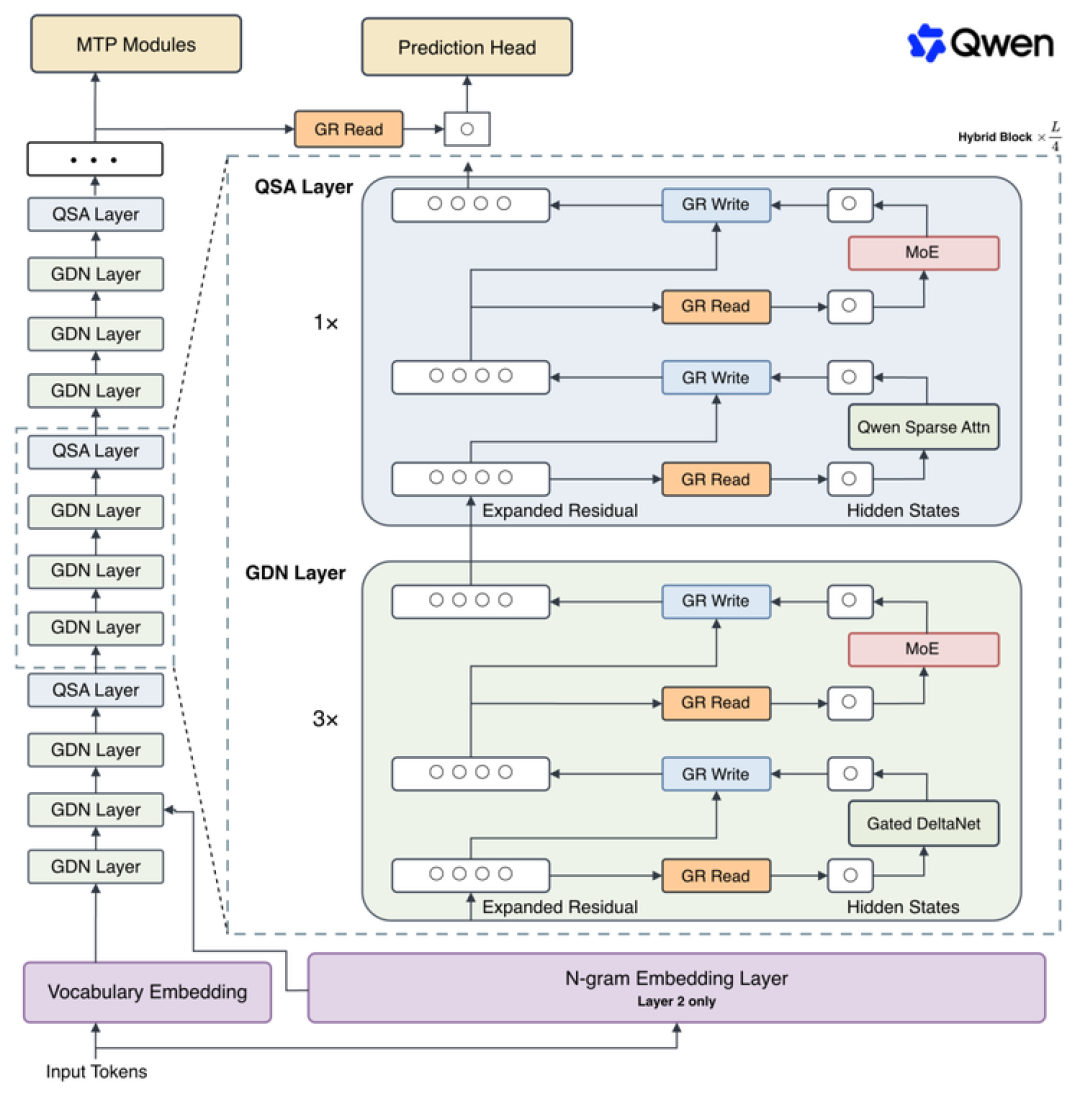
Qwen3.8-Flash-Next 的主模型拥有 125B 参数,另有 51B N-gram Embedding,但每个 Token 只激活 6B 参数。模型规模没有大幅缩水,每次推理真正参与计算的部分却被压得很小。
Agent 最烧钱的地方,往往不是回答一个问题,而是反复处理越来越长的上下文。每执行一轮,模型都要重新读取系统提示、历史对话、代码文件和工具返回结果。传统全注意力机制近似于每写一个字,都要把前面的整本材料重新翻一遍。上下文越长,计算量和 KV Cache 占用就越高,GPU 不仅忙着计算,还要不断搬运数据。
Qwen 的处理方式,是让四分之三的网络层使用 GDN,把历史信息持续压缩到固定大小的状态中;剩余层再通过 QSA 稀疏注意力,从长上下文里寻找真正相关的部分。它不再要求每一层都完整**全部历史,而是先做摘要,需要细节时再精准检索。
额外的 51B N-gram Embedding,则更像一套规模庞大的常用词组和局部模式库。查找位置可以提前确定,因此能够放在成本更低的主机内存中,需要时再异步读取,不必长期占用昂贵的 GPU 显存,也几乎不增加每个 Token 的矩阵运算量。
GLM-5.3-Flash 走的是相似方向。
它拥有 320B 总参数,每个 Token 只激活 18B,并采用线性注意力与稀疏注意力结合的混合架构。线性注意力负责低成本地压缩和延续历史状态,稀疏注意力负责从百万 Token 上下文中找回关键细节。智谱称,相比 GLM-5.3,GLM-5.3-Flash 的注意力计算量降至约三分之一,KV Cache 缩小至约四分之一。
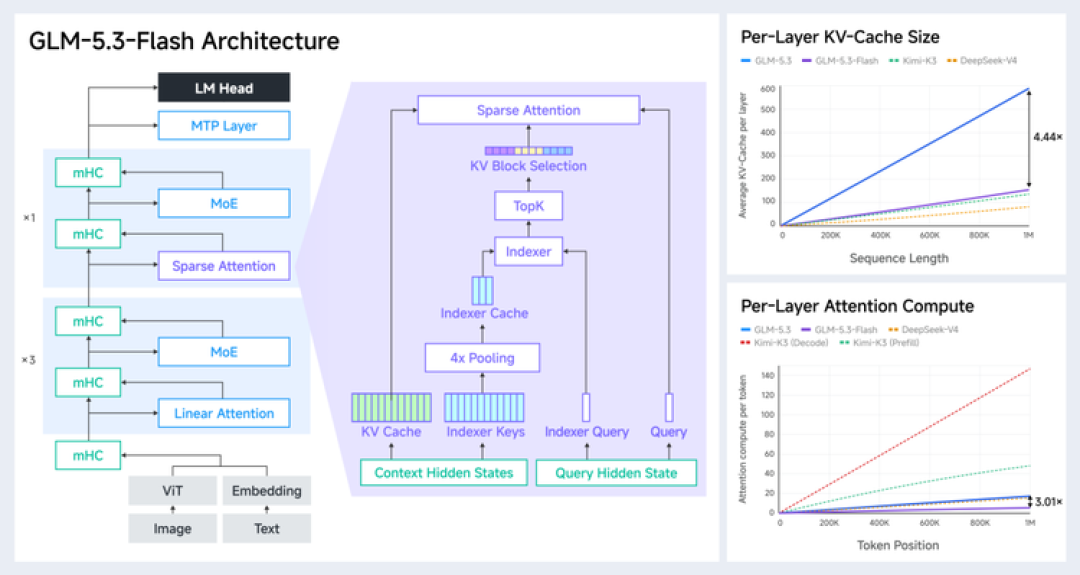
这也是 Agent 时代的价格战与聊天时代不同的地方。聊天产品的成本主要来自一次生成,Agent 的成本会在几十轮循环中持续累积。模型结构每节省一次上下文读取、一次显存搬运,都会在整个任务里被重复放大。
当然,激活参数少不等于最终账单一定低。真正的竞争指标已经从“每百万 Token 多少钱”,转向“完成一个任务需要多少钱”。
免费补贴可以开启价格战,但只有架构效率才能决定价格战能打多久。
看起来Qwen和GLM就是在用DeepSeek制造斩杀线的方式制造新的斩杀线,并且第一个要斩杀的就都瞄准了DeepSeek。
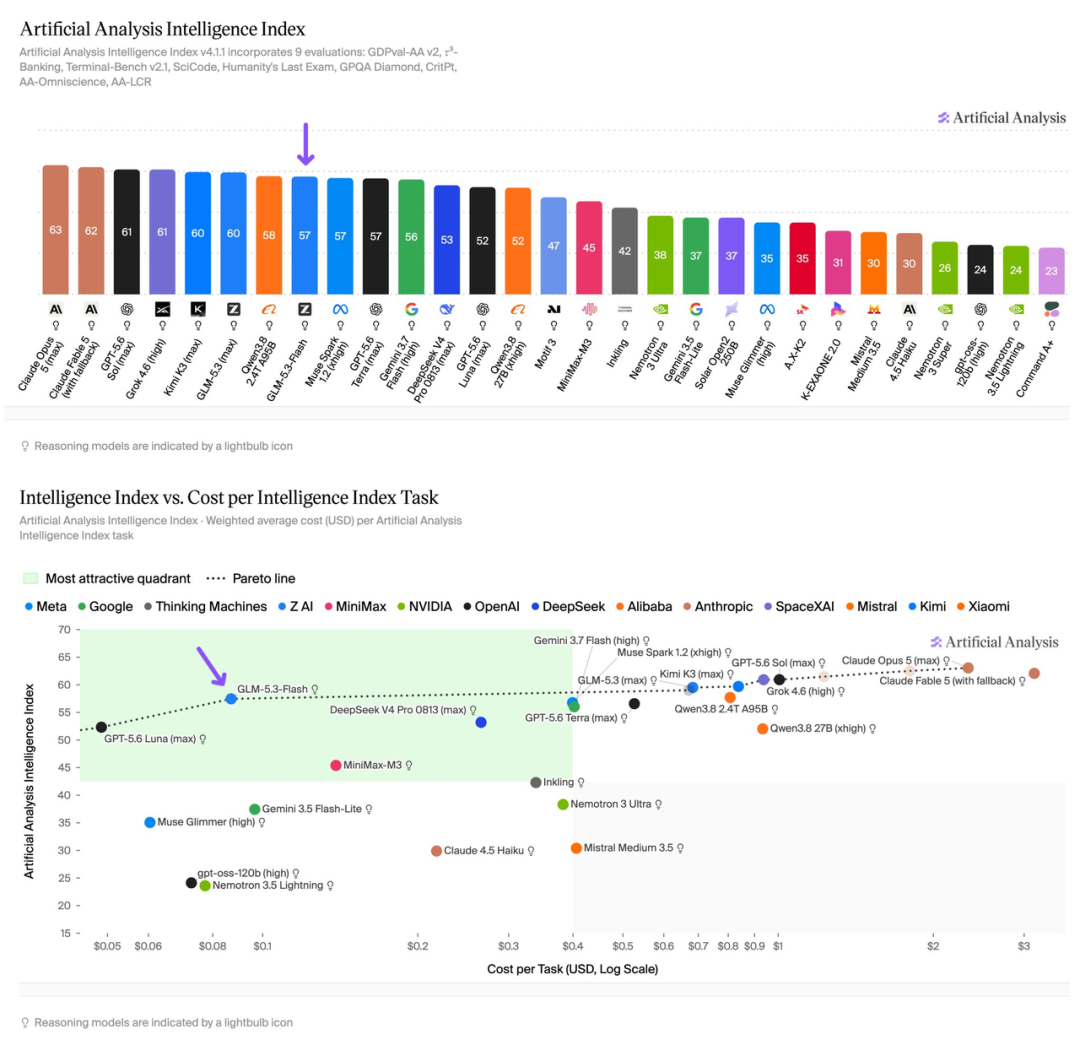
不过,竞争不会就此结束。
涨价之后,DeepSeek 仍有一个价格几乎无人能打:缓存命中。
按照调整后的峰谷价格,V4-Flash 每百万缓存命中 Token,闲时为 0.007 美元,折合约 0.05 元;高峰为 0.014 美元,约 0.10 元。GLM-5.3-Flash 五折后的缓存输入价格是 0.015 美元,约 0.11 元。
差距看起来只有几分钱,放进 Agent 循环里却可能被放大很多次。
任务的缓存率高、上下文重复多,DeepSeek 依然可能最便宜。新输入和输出占比高,Qwen 与 GLM 的低价就更有优势。
谁才是真正的低价模型,得等整个任务跑完再看账单。斩杀线的所有权,接下来看起来还会不停的继续迁移下去。

点个“爱心”,再走吧






校验提示文案
校验提示文案
校验提示文案
思考中 这种本来就应该在准备工作中的免费行为 仔细看的话 能发现也植入了商业策略 故意用无效内容消耗token 甚至主动纳入延长达到目的路径来重复计算
说简单了 就是你打车让ai从A到B ai却磨磨唧唧的中间跑了几回C和D 夹带私货 让你为路费多买单
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
思考中 这种本来就应该在准备工作中的免费行为 仔细看的话 能发现也植入了商业策略 故意用无效内容消耗token 甚至主动纳入延长达到目的路径来重复计算
说简单了 就是你打车让ai从A到B ai却磨磨唧唧的中间跑了几回C和D 夹带私货 让你为路费多买单
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案