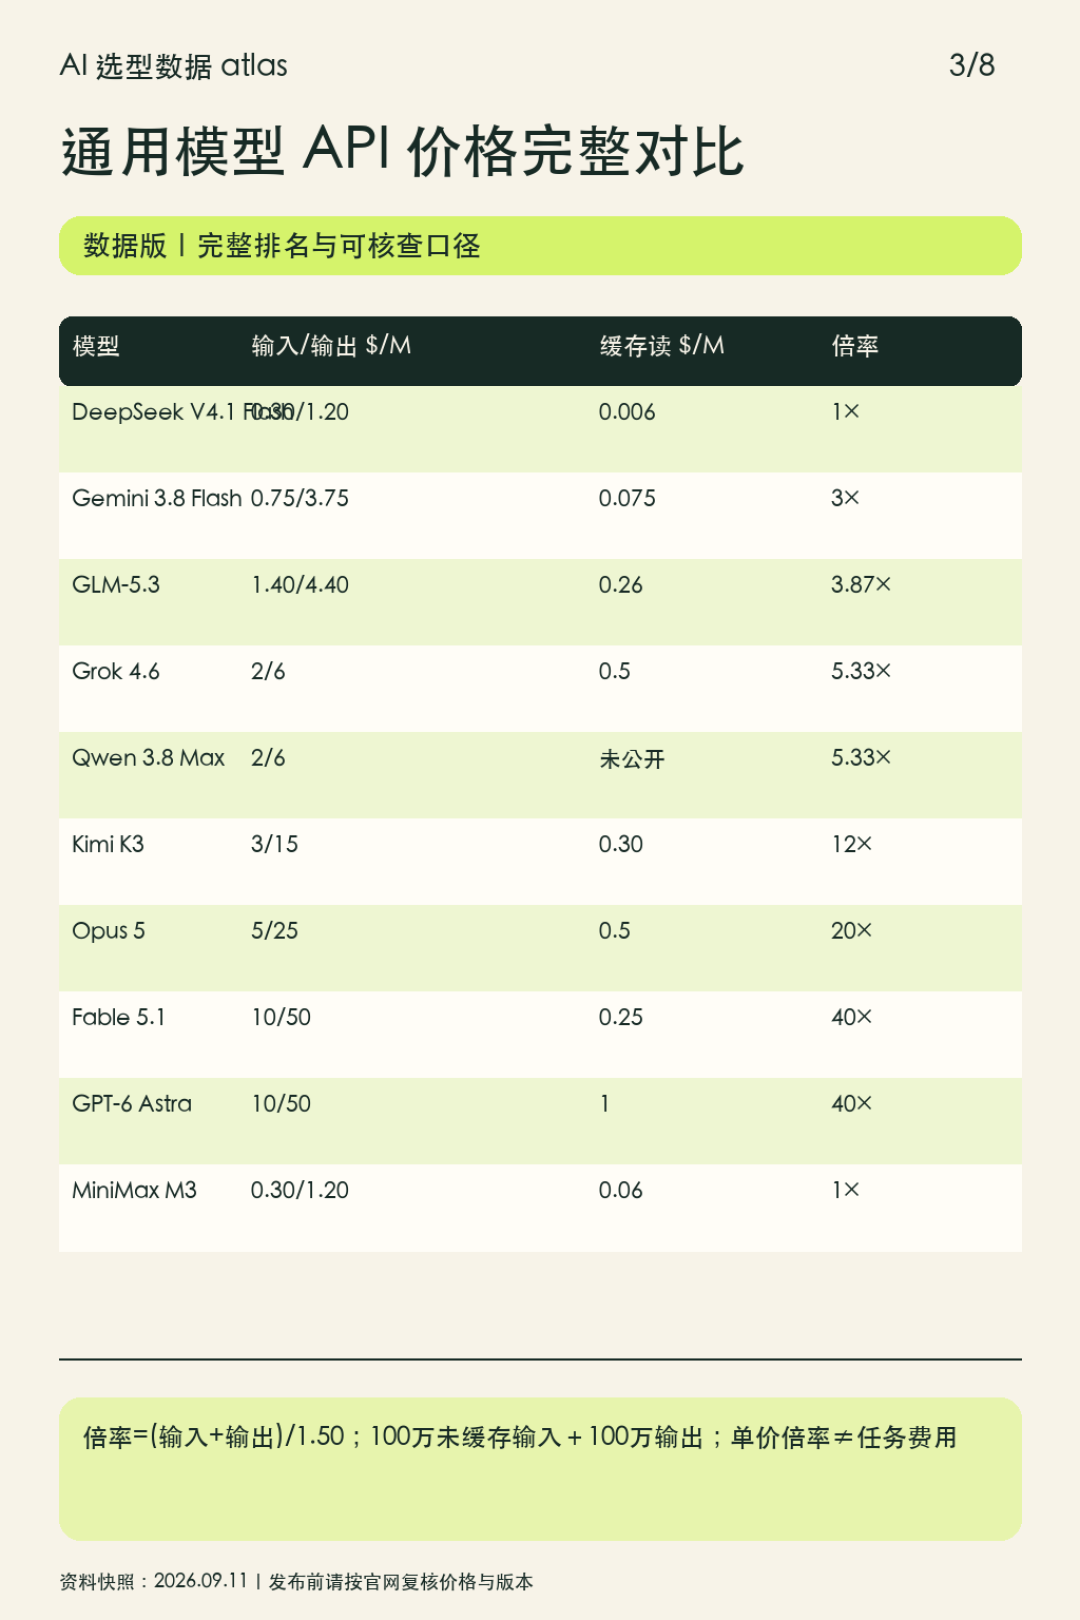
Anthropic 北京时间 9 月 23 日凌晨发布了 Claude Opus 5.5,官方口径很直接:大部分工作任务上追平自家顶级 Fable 5.1,按任务算的平均花费比上一代 Opus 5 低 40%。这正好卡在 CEO 阿莫代伊万字长文呼吁「AI 该降速」之后,是嘴炮过后掏出的第一张牌。定价输入 $4/百万 Token、输出 $20/百万 Token,对比 Opus 5 的 $5/$25;Max 用户的 5 小时用量窗口不仅加了额度,还直接重置了一次。新浪微博新浪微博
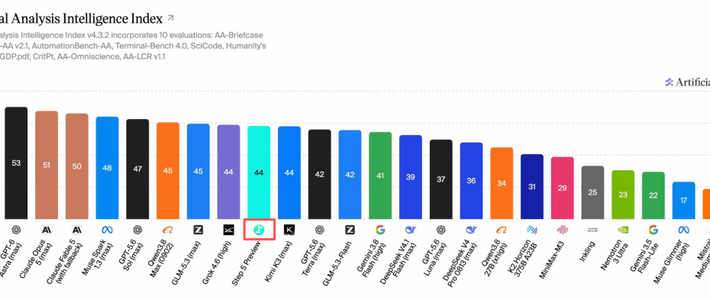
同一天晚上,OpenAI 把 GPT-6 Sol/Luna 也放了出来——社区普遍叫它「Astra 的降价打工版」。再往前两天,xAI 的 Grok 4.7 已经发布:500K 上下文、定价约为同级一半、同步接入 GitHub Copilot 全系 IDE。小米那边,MiMo-V2.6 系列开源发布,Pro 版在 Artificial Analysis 智能指数拿了 46 分,被称当前最强开源模型。这一周不是又发了个模型,是「编码模型价格战」正式开打。知乎新浪微博新浪微博
已经在掏 Claude Pro/Max 或者 Cursor、Copilot 订阅费的人,真正的问题不是「有没有新模型」,而是:官方说的 40%,你能不能拿到?我把官方简报、社区实测和三份基准测试对了一遍,结论是——你省下的钱,大头可能不来自单价,而来自你用的工具和接入路径。
这次降价,账怎么算
40% 是两部分叠出来的:单价降约 20%,同时干同一件事烧的 Token 变少了。官方放出的演示案例是 3 小时完成 20 万行代码审阅,比 Opus 5 快 6 倍、省 2.5 倍 Token。这次还专门修了「不说人话」的老毛病,官方强调会先给结论、少堆术语。新浪微博
但社区口径比官方热闹。知乎前端实测博主 Karminski-牙医 的怀疑很有代表性:他对比后认为「我怀疑现在opus 5.5就是 fable 5.1 的量化版或者自家蒸馏版」。他的依据是思考 Token 消耗明显变多——用小一号的模型换推理长度换性能,实测里还碰到过一次「雷霆大思考」卡住、终端和网页反复测都吐不出代码。但同一篇结论他给得不低:6 次抽卡 6 次都是高质量,「Anthropic 一贯的稳」还在。知乎
另一位知乎用户拿自己未投稿的论文做了个 A/B:同一 workspace、同一句提示词,Fable 5.1 跑一次用掉了 $20 订阅档约 4% 的月额度,Opus 5.5 约 1%,两边给出的评审结论几乎一致。个例不能当结论,但它和官方「按任务算花费降 40%」的方向对上了。知乎
至于 B 站那些「打爆 GPT-6 Astra」「Agentic 编程双料第一」的说法,目前还只是自媒体转述,等 Artificial Analysis 这类第三方榜单页面更新再采信不迟。所有 Claude 老用户也都记得那句圈内话:「无奈Anthropic降智是祖传艺能」,发布一周后的口碑才是真信号。哔哩哔哩知乎
真正决定你账单的:启动税和缓存率
比换模型更值钱的省钱信息,藏在 9 月初的三份基准测试里(InfoQ 编译,原始测试覆盖 12 种智能体框架跑同一模型):每解决一个任务消耗的 Token,从 Aider 的约 3500 个到 OpenClaw 的 29.2 万个——模型一模一样,账单天差地别。差距来自两个机制。一是「启动税」:智能体框架自带的系统提示词和工具说明,最省的约 700 Token,最重的约 2.6 万,再乘以十几轮对话,脚手架自己就能吃掉 39 万输入 Token。36氪
二是缓存率:同一轮测试里 Claude Code 的输入 Token 只有 1.5% 来自缓存,Codex 约 70%、OMP 约 57%,而缓存输入的单价大约只有新输入的五分之一。也就是说你的 Token 用量和对手差不多,账单却贵好几倍——问题出在服务路径,测试环境里 Claude Code 是唯一走 Anthropic messages 端点接 OpenRouter 的框架,网关转换把缓存命中率打没了。36氪
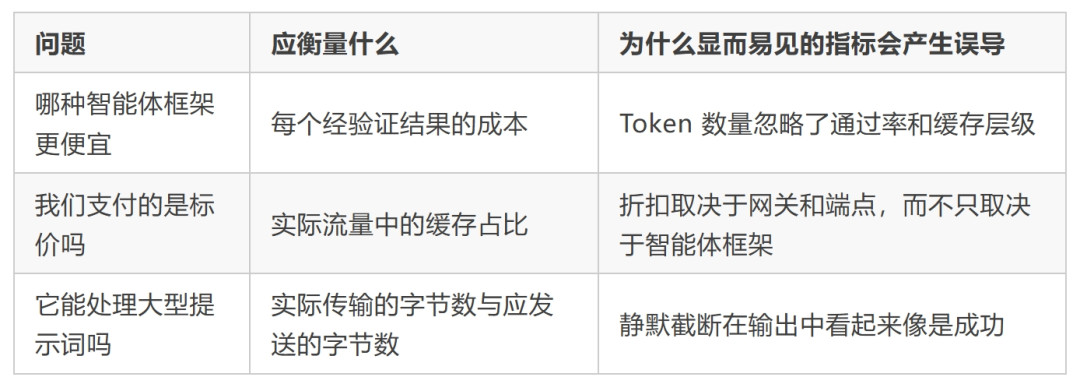
所以换不换 Opus 5.5,正确的算账顺序是:先翻自己的账单看缓存率和对话轮数,再看那张降价 20% 的单价表。传说的 $0.2/百万缓存读取价目前还是线报口径,以官方定价页确认版为准。36氪
按你的状态给判断
Max/Pro 订阅党:先别动,也别急着吹。额度窗口刚重置,切过去抽卡几轮日常任务,重点盯两件事——5 小时窗口烧得是不是比 Opus 5 快、「雷霆思考」卡死出现频率,一周后再定长期主力。新浪微博
API 重度用户:值得现在就重算账。$4/$20 的价格表配上官方宣称的 token 减量,长任务流(长上下文、多轮 Agent)受益最大;但先测你实际服务路径的缓存命中,别拿降价预期骗自己。
Copilot 用户:这轮价格战给了你一个和 Anthropic 无关的选项——Grok 4.7 已接入 IDE 全系,性能实测「逼近 Opus 5、价格一半」,手头任务偏前端的可以直接开一局对比。
国产模型用户:MiMo-V2.6 Pro 顶着「最强开源」下场,自用部署成本逻辑没变;但社区说得很直白——闭源两家一起砍价,国产模型「性價比上也要開始被斩殺」,如果你在用 DeepSeek API 跑编码,GLM 5.5、Kimi K3.1 的下一版跟不跟价,是你的换库窗口。知乎
轻度/观望用户:这周不要凑热闹。让「降智检测」的口碑先沉一沉,教程潮水退了你再挑口粮,反正 Max 用户重置的窗口又不共享给你。
接下来盯这几个信号
1)Anthropic 官方定价页的完整价格确认(尤其缓存读写单价);2)高负载期 Opus 5.5 是否重演降智、蒸馏论有没有官方回应;3)GPT-6 Sol/Luna 的正式定价——如果「降价版 Astra」更狠,这次 40% 只是开胃菜;4)国产大厂下一版的定价动作。
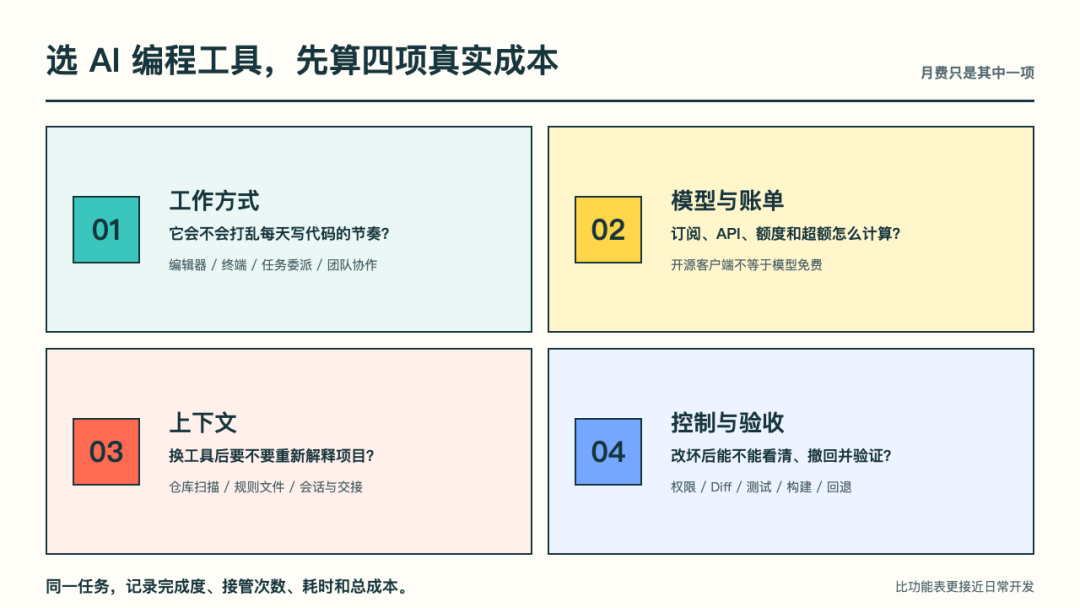
价格战的月份,最贵的从来不是 Token,是你在错误工具链上多烧的那几十轮上下文。