十月初,极客湾把一颗麒麟9050 Pro送上了切片台。封装磨掉,芯片一层层剥开,再放进电子显微镜。视频发出来,295万播放、25万赞,弹幕里刷得最多的是“这也能看见?”哔哩哔哩
Mate90开售前后,这段视频又被翻了出来。
电镜下不是一颗完整的单层芯片。两颗Die面对面贴在一起:上面是计算单元,下面是缓存。微博知乎
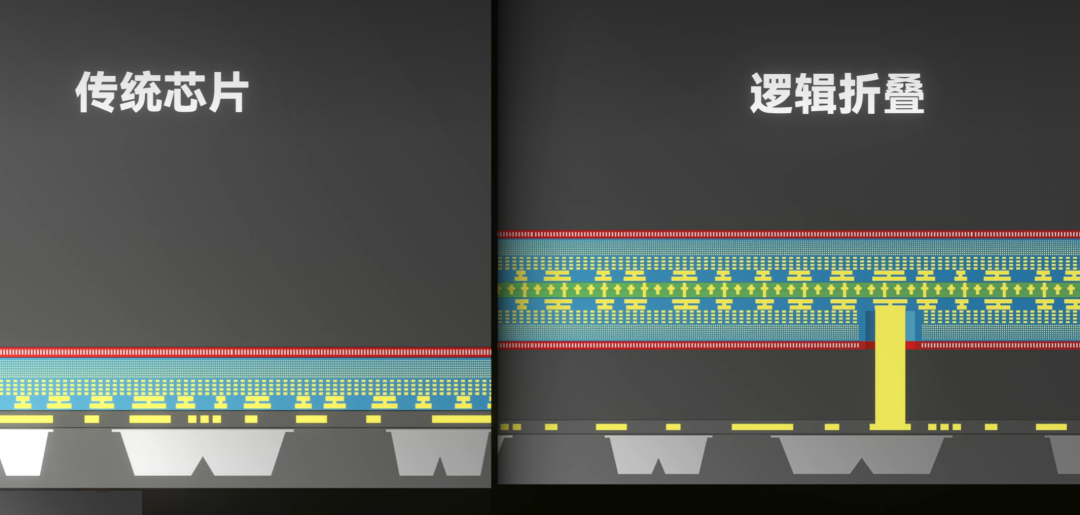
铜-铜混合键合把两层的金属层直接焊住,中间没有传统封装的凸点,也没有绕来绕去的水平走线。拆解资料里,大约8万根硅通孔从背面穿下去供电。
为什么偏偏把缓存拆出去?因为缓存早就不好缩了。逻辑电路还能跟着制程一代代变小,SRAM却从7nm前后开始放慢脚步,面积降不下去。既然缩不动,就把它单独做一颗Die,再贴到计算单元背上。知乎
这一贴,省的是路。信号从计算单元跑到缓存再跑回来,这段路有电阻也有电容,RC延迟决定了关键路径。路越长,想跑同样的频率就得把电压往上抬;电压一抬,功耗按平方涨。
缓存搬到工位头顶,同样的频率可以用更低的电压,能效就这么出来了。
所以这一代被“折”得最狠的,其实是缓存访问的那段路。极客湾的切片里,L1、L2缓存都跟着折了上去。至于CPU、GPU、NPU之间的逻辑互连,仍然铺在二维平面上。
有人据此说“首款韬芯片没有逻辑折叠”,这话说得太满。缓存控制层也是逻辑,华为自己的论文也承认这一代实现偏保守。但边界确实存在:它折的是缓存,不是整个计算架构。
按华为公开的口径,逻辑折叠让核心布线减少约20%,关键时序路径最多缩短70%,相近性能下CPU功耗降41%。知乎
第三方按切片估算,晶体管密度到了每平方毫米2.38亿左右。“等效3nm”的说法,就是从密度上来的。微博
“70度和70度的水倒在一起,真能整出140度。”这句调侃针对的,正是把密度叠加直接换算成性能翻倍的算法。
密度等效不等于性能等效。同样多的晶体管,能不能跑出同样的频率、同样的帧率,还取决于架构、缓存命中、调度和散热。
极客湾测Mate90 Pro Max,性能比上一代强20%左右。能效也确实摸到了台积电3nm级旗舰的附近,可这是“接近”,不是“打赢”。知乎
黄仁勋的评价更直接:对华为是突破,对台积电不是威胁——台积电做堆叠和3D封装已经快十年。这话不完全错。真正的差别不在“叠”,而在叠什么、叠多近、叠完之后那截路短了多少。微博
代价也摆在切片里。两颗Die各自流片、再对准键合,任何一颗的良率问题都会拖累整体。两颗Die加起来约241平方毫米,比上一代多出七成,成本自然往上走。微博
更麻烦的是热。两层叠在一起,高功耗模块如果上下对齐,热量会互相憋着。
华为麒麟首席架构师黄勇在ISCAS 2026上,把工艺、时序、散热、功耗列为逻辑折叠的四大挑战。后来的论文里,华为也让高功耗电路避开垂直重叠。知乎知乎
还有一个现实结果:这套方案先落在Mate90 Pro Max这类最贵的机型上,不是全系普及。
对准备掏钱的人来说,结论不复杂。Mate90 Pro Max的能效进步是真的,尤其在日常和中低负载;但把它理解成“7nm打赢3nm”,就过头了。
它更像是用封装和布线,把一颗7nm级芯片的短板补到接近3nm的水平,代价是成本、散热和设计复杂度。
极客湾这次切片最大的价值,不是给“遥遥领先”再添一条证据,也不是拆台。它把发布会上的一个大词,还原成了电镜下能数清楚的铜柱和走线。
技术值得佩服,但佩服完之后,还是得看它到底折了什么、没折什么。
下一代麒麟2027据说会用更小的键合间距、更多的垂直互连。到那时候,如果折的真是逻辑,而不只是缓存,这颗芯片的故事才讲到下半场。