

后台那个叫「硬件流量分载」的复选框,大概是软路由里最容易被顺手勾上的东西。勾上去,效果立竿见影。
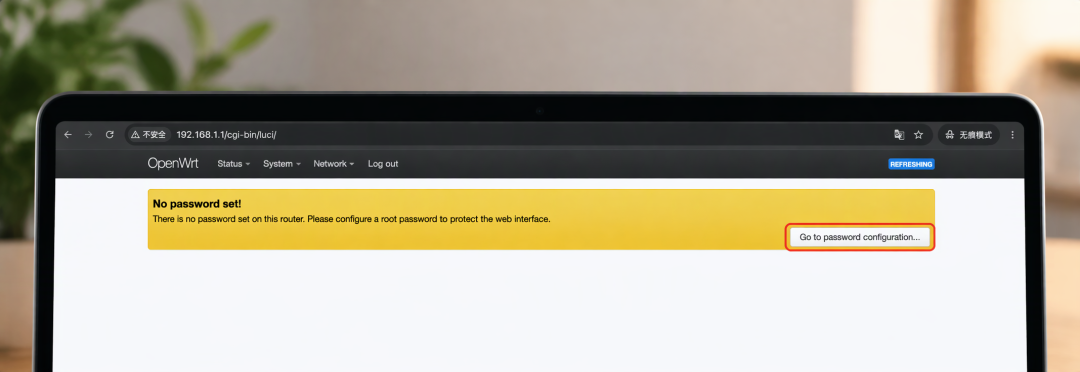
B 站 UP 主 staylightblow 在联发科 MT7981(Filogic 820)平台上做了 16 并发流的稳态打流:开启硬件加速后,CPU 软中断占用从 35.8% 掉到 0.09%,整机发热明显下来。同一台机器、同一根网线,原先设成 100Mbps 的限速规则,实测跑出了 938Mbps。哔哩哔哩
不是限速写错了,是数据包已经不经过写限速的那个地方了。
快转的代价:路由器看不见这些流量了
正常转发路径上,每条连接都要在 conntrack(连接跟踪表)里登记一次。流量统计、按设备限速、SQM/CAKE 整形、按域名分流、连接级去广告,全挂在这张表上。
硬件加速做的事,是把已经建好的连接交给芯片里的 NAT 引擎直接快转,跳过 CPU,也跳过 conntrack。跳过去的那部分,统计归零、规则失效。所以那次实测里,应用识别和域名统计「全部失明归零」,QoS 流控「全军覆没」。哔哩哔哩
这个开关在不同固件里名字不一样:OpenWrt 官方叫软件流量分载和硬件流量分载,第三方固件里常见 Turbo ACC、SFE、快转、HWNAT。x86 小主机没有专用 NAT 芯片,一般只能退到软件分载,B 站有 UP 主实测称开启后吞吐提升约 310%,本质同样是拿「绕过完整路径」换来的。哔哩哔哩哔哩哔哩
开还是关,看你把它当什么用
只当主路由拨号,家里十几台设备,不装统计和分流插件:开。跑满线速、温度更低、风扇更安静,纯赚。那条实测视频的评论区里,最高频的一句就是「家里设备不多,没有流控需求」。
装了流量统计、开了 SQM 保游戏、按域名分流:关,或者只对不重要的网段开。你要的是可见性和控制权,不是最后那几个百分点的吞吐。
用的是 MT7981 这类 ARM 弱芯片机,还想跑 CAKE:这时问题不在开关。有用户在评论区反馈,7981 关掉硬件加速后根本带不动 CAKE,流量一大连 500Mbps 都撑不住;也有人说 7981 本身支持硬件 QoS,只是固件没适配。两种说法没有共识,但落点一致:弱芯片上做精细流控,先天吃亏。
补一句,这不是死结。staylightblow 后来又交了一版软硬协同方案,声称能同时保住 100% 的应用流量统计和硬件加速红利,千兆满载 CPU 只占 1.8%。代价是它依赖特定固件和平台适配,换个盒子不保证通用。哔哩哔哩
别为「跑满千兆」多花钱
很多人为这件事去买更贵的 CPU,方向就错了。
知乎作者「铁军」做过一次四架构横评:5 台设备接在同一台千兆交换机下打明文流量,从高通 ARMv8 到 Intel Atom 再到老 MIPS,有效带宽达标率全部落在 87.5%–93.5%,双向对称比 98% 以上。明文转发这一关,几乎人人都能跑满家用千兆。知乎
真正的分水岭在加密隧道。WireGuard 压测下,百元级的京东云无线宝 AX1800 Pro 靠 ARMv8 架构加 NEON 指令集跑出 731.1 Mbps,把搭载 Atom C3558、带 AES-NI 的企业级设备 VMware Edge620 压在身后。而老 MIPS 的小米路由器 4 跑 OpenVPN 只有 18.7 Mbps,单核直接锁死在 100%。知乎
所以选购逻辑应该反过来:只为拨号转发,几百块的盒子够用;要跑加密隧道,看的是指令集(AES-NI、ARMv8 Crypto、NEON),不是核数。设备没有硬件 AES 加速时,把算法从 AES-256-GCM 换成 ChaCha20-Poly1305,纯算力能差 3 倍以上,这是个不花钱的性能外挂。知乎
还有个容易被忽略的细节:同一台机器,接收(RX)通常比发送(TX)慢一截。原因是解密的软中断默认全压在 CPU0 上,没调 RPS/RFS 就是「一核有难、三核围观」。知乎
最后
这个开关没有好坏,只有一个取舍:你想让路由器看见多少流量。看得越少越快,看得越多越慢。
先想清楚自己要哪个,再去勾那个框。
当前文章无评论,是时候发表评论了