

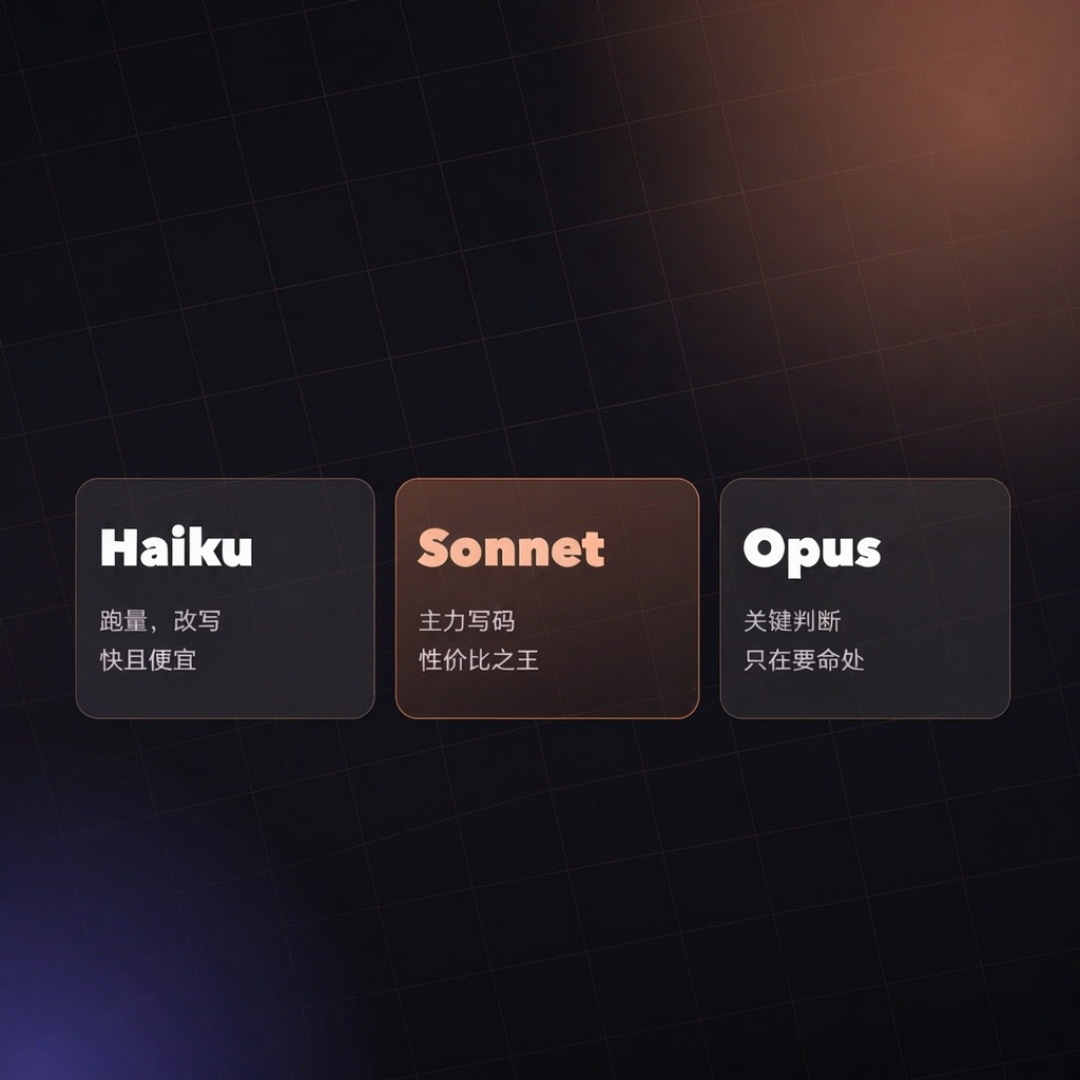
不想让AI写出屎山,现在比较成型的解法已经不是“挑一个最强模型”,而是按层级用三个模型。Anthropic 在 11 月中旬更新的 Claude Code 官方文档里给出了一个名为 Escalate hard decisions with the advisor tool 的入口,专门讲怎么把硬决策升级给更贵的模型处理。围绕它的玩法最近扩散得很快,核心思路一句话:同时运行 Sonnet、Haiku 和 Opus 5.5,每个只做它最擅长的工作。Claude Code 官方文档小红书小红书
AI 代码堆成屎山,常见原因不是写得明显烂,而是“看起来对”却没人把关。代码分析公司 GitClear 把 2020 到 2024 年 2.11 亿行代码变更逐行分析了一遍,结论是代码库越写越乱:新增代码变便宜了,顺手整理旧代码的人却变少了。被这股冲击正面打到的 Claude Code 团队自己也承认:Claude Code 约 90% 的代码是由 Claude 编写的,审查也主要交给了模型。知乎知乎小红书
变化量在智能体提效后直接爆了:这个团队所在代码仓,每天合并的变更从 5 月的约 2,500 条涨到今年 9 月的超过 3 万条。写码不再稀缺之后,三个模型各自站好三个岗。知乎
第一个岗是“建”。负责写的主会话交给中档模型,Sonnet 5.5 运行会话并编写代码。更彻底的“包工头”版本则规定,模型 A(最强)在主会话想方案、写派活单、验收改动,不改代码。小红书小红书
第二个岗是“找”。Haiku 5.5 负责并行探索文件和文档,常见做法是拆出三个只读子代理:search 映射仓库、grep 查找调用站点、docs 拉取 API 参考。但第三方基准提醒,这颗螺丝不能放权做判断:开源基准 Bicameral 在 Claude Code 上对四个模型跑了 96 次对照,未过检的失败全部出现在最便宜的小模型上。小红书36氪
第三个岗是“判”。Opus 5.5 全程不写代码,只担任随时待命的顾问,它的介入时机被写进 CLAUDE.md 规则:在锁定计划之前、相同错误出现两次后以及宣布任务完成之前咨询顾问。小红书
上手只需要一条命令:claude --model sonnet --advisor opus。如果想把顾问位置换成同家族更高的模型,官方文档注明部分订阅计划下 Fable 也能作为 advisor,但需要先接受一次性的用量计费授权。小红书Claude Code 官方文档
为什么不干脆全用最强的模型?一笔账是成本结构:主会话只想和验、读多写少,缓存利用率高,写 1 次、读 20 次,缓存读只要 0.1 倍价。另一笔账是能力结构——消耗大头的机械劳动不需要多少判断,可以下放给便宜模型,而需要判断的那几个位置恰恰不能下放。Claude Code 的创建者 Boris Cherny 估计,一套验证流程能把 Claude 的输出质量提升两到三倍。分工的本质,就是把钱花在判断和把关这两件省不掉的事上。小红书知乎
写码分工只解决“谁来写”,防屎山最终靠“谁来收”。包工头模式的派活单上写明改动范围、禁区、验证命令、Done when、并行边界,超范围的问题一律 BLOCKED 顶回主会话,不自行扩大改动。小红书
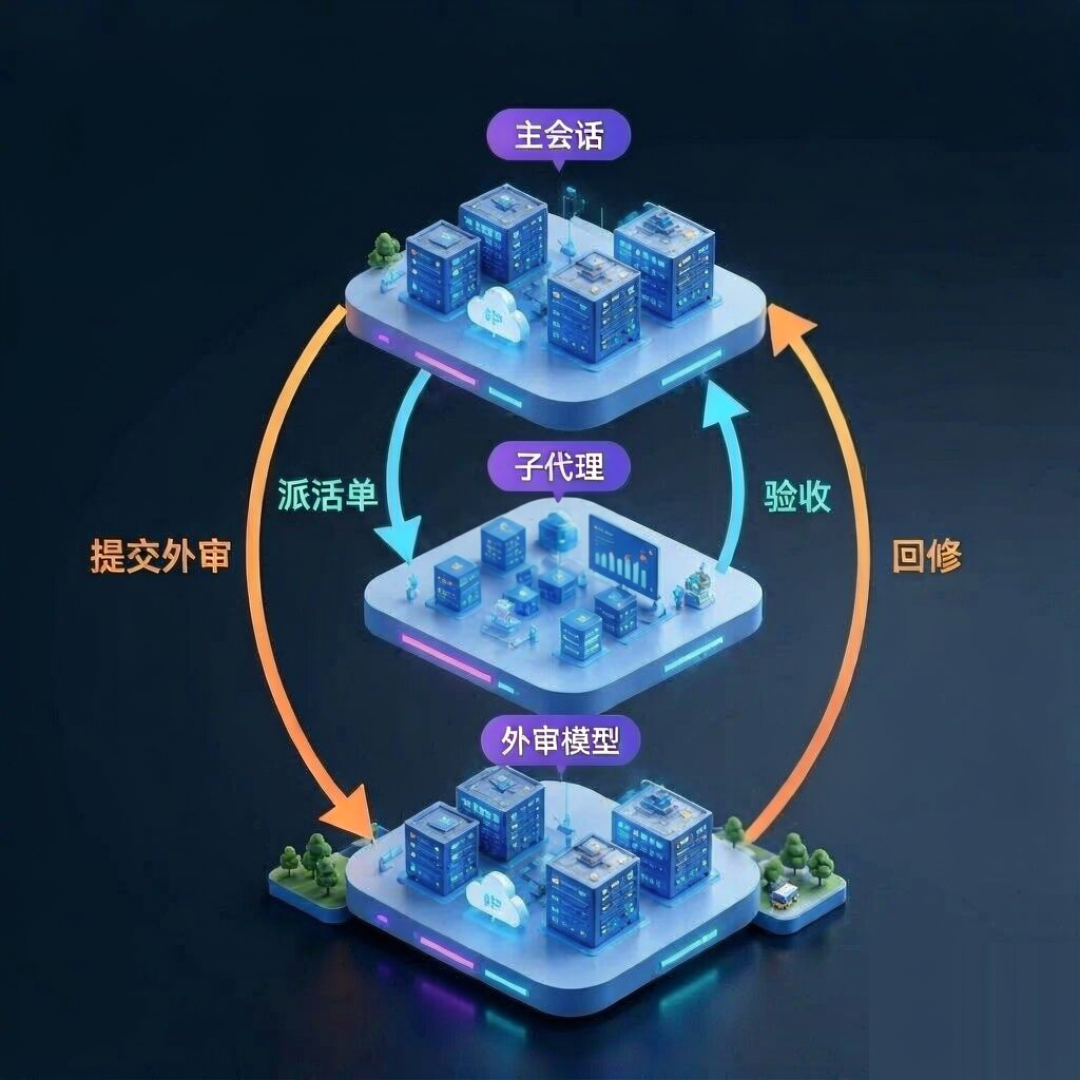
遇到资金计算、状态机、接口契约这类重要改动,这套打法还有一条规矩:重要改动(资金计算、状态机、接口契约、安全认证、数据迁移)必须换家族模型送外审。外审模型只读代码挑毛病,举证责任在外审一方,拿不出证据的推测不算发现,不会阻塞合并。小红书
官方团队给出的版本更系统:一次典型变更要过六层检查,外加一套回滚机制来处理任何漏网的问题。人工只按风险档位签字:低风险 0 人,中风险 1 人,高风险 2 人。知乎小红书
效果也公开了:从 6 月到 9 月,合并进代码库的 PR 数量增长了一倍多,回滚占比下降 40% 以上。同期,拿到实质审查意见的 PR 从 16% 升到 54%。知乎小红书
最值得普通团队抄的作业,是他们对“AI 审查 AI”陷阱的处理。一个 PR 曾在智能体作者和智能体审查者之间一夜来回拉扯五十多轮。这个循环最后靠人工才停下来——两个 AI 互相审查,是可以无限打转的。知乎
复盘发现,审查系统反复标记的问题里约 59% 从第一轮起就存在。团队因此把机制改为收敛型:审查系统会在三轮之后要求作者重新评估其方案。审查噪声也有度量方法,官方博客的说法是观察人类如何回应评论。知乎Claude 官方博客
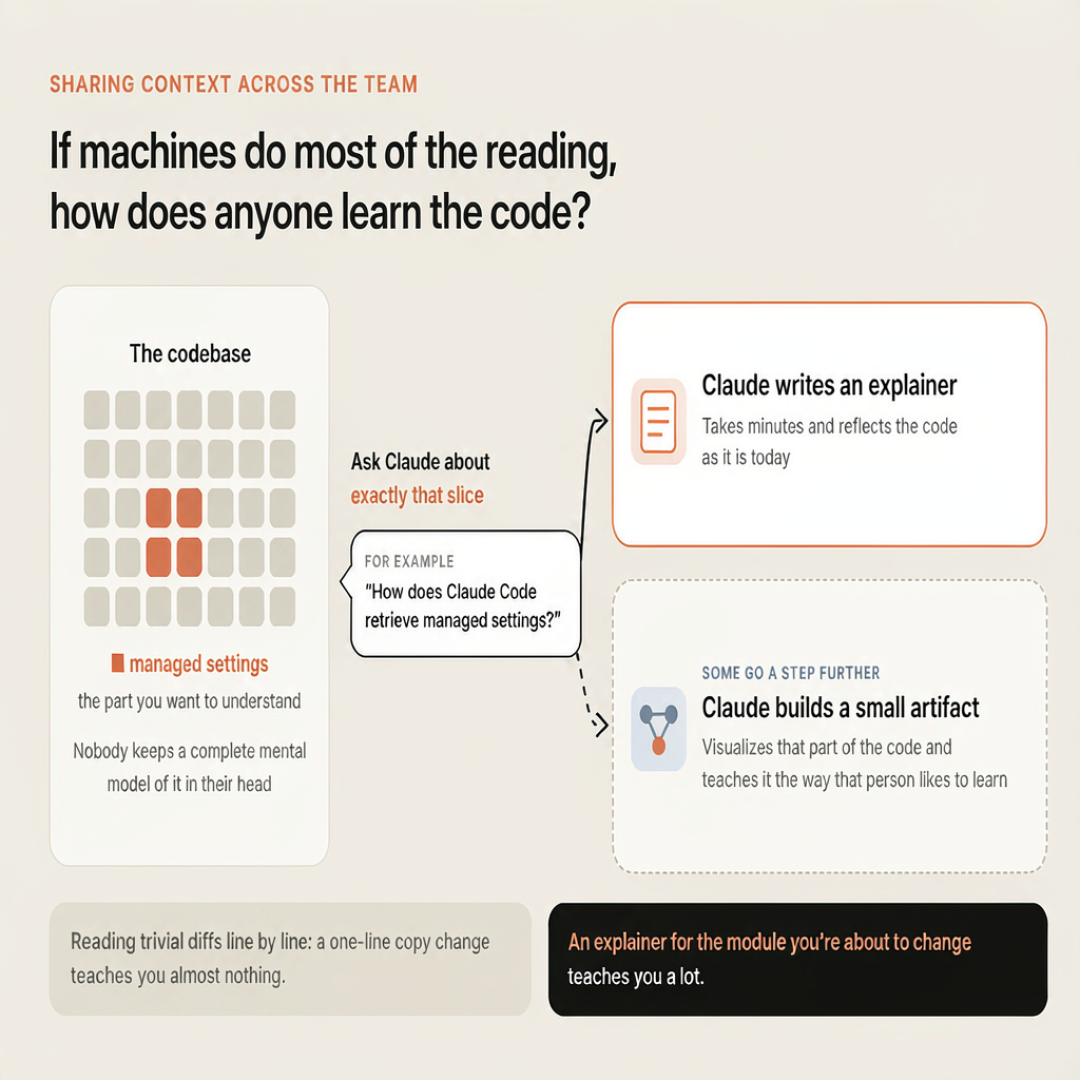
另一个隐性风险是“理解债”:机器读掉了大部分 diff,人怎么还学得懂这个代码库?官方博客的回答很坦诚,团队中没有任何一个人在脑子里拥有 Claude Code 的完整心智模型,需要弄懂某个模块时,就让 Claude 现场生成一份只讲那一段、永远是最新状态的讲解。知乎
最后是边界。这套分工适合多文件、能并行、改完要测的复杂功能,小修不用开派活单,更不用为了仪式感凑齐三个模型。11 月中旬 Anthropic 还实验性开放了 CodeMode:完全不换模型、不牺牲智商的前提下,开启这个模式跑多步开发任务,真实 API 账单直接少了 22%–23%。它目前默认关闭、仅限本地终端直连官方账号,且测试口径里“累计处理的 Token”不等于实际账单——省掉的多数是本来就有折扣的缓存重复读取。小红书36氪
三个模型分别怎么用,答案可以压缩成一句话:便宜模型负责找,主力模型负责建,最强模型只在计划锁定前、错误重复时、交付宣布前负责判。屎山从来不是模型写出来的,是判断和审查缺位堆出来的——模型分工省下的钱,最终都要花在把这两件事守住上。

当前文章无评论,是时候发表评论了